세 단계 — pre-training · SFT · RFT
foundation model 은 강력하지만 범용입니다. 내 로봇, 내 작업, 내 카메라 각도에 맞추려면 추가 학습이 필요합니다. 전형적인 흐름은 세 단계입니다.
학습 문제의 틀 — MDP 와 POMDP
로봇 학습이 푸는 문제는 전통적으로 MDP(Markov Decision Process) 라는 틀로 적습니다. "지금 상황을 보고 → 행동을 하나 고르면 → 상황이 바뀌고 → 잘했으면 점수를 받는다" 를 계속 반복하는 문제입니다.
| 조각 | 뜻 | 예 |
|---|---|---|
| 상태 (state) | 지금 세상이 어떤지 | 컵이 테이블 왼쪽, 로봇 팔은 오른쪽 |
| 행동 (action) | 로봇이 할 수 있는 선택 | 팔을 왼쪽으로 5 cm |
| 전이 (transition) | 행동하면 상태가 어떻게 바뀌는지 | 팔이 왼쪽으로 가면 컵에 가까워짐 |
| 보상 (reward) | 잘했는지 알려주는 점수 | 컵을 집으면 +1 |
| policy | 각 상태에서 어떤 행동을 할지 정하는 규칙 | 컵이 왼쪽에 보이면 팔을 왼쪽으로 |
출처: Megajuice, Wikimedia Commons, Reinforcement learning diagram · CC0
"Markov" 는 "다음에 뭐가 될지는 지금 상태만 보면 안다" 는 가정입니다. 과거 이력을 전부 기억할 필요가 없다는 뜻입니다. 결국 VLA 는 관측을 받아 행동을 내는 policy 이고, 이 MDP 를 푸는 신경망입니다.
그런데 위 MDP 는 "상태를 정확히 안다" 고 전제하지만, 실제 로봇은 세상을 전부 보지 못합니다. 카메라에 안 잡히는 사각지대가 있고, 컵 뒤에 뭐가 있는지 모릅니다. 로봇이 실제로 아는 것은 카메라 이미지 + 자기 관절 각도 같은 부분 관측 뿐입니다. 이 조건을 반영한 것이 POMDP(Partially Observable MDP) 입니다.
부분 관측은 로봇 학습이 어려운 근본 이유 중 하나입니다. 수식은 여기까지이고, 불완전한 관측에서 행동을 예측하는 문제라고만 기억하시면 충분합니다.
모방학습과 강화학습의 선택
아래 두 방법은 경쟁 관계가 아니라 상황에 따라 쓰는 도구입니다.
| 상황 | 유리한 쪽 | 이유 |
|---|---|---|
| 깨끗한 전문가 시연을 수백 개 모을 수 있다 | 모방학습 (IL) | 빠르게 수렴하고 안전. 단, 시연에 없는 상황엔 약함 |
| 시연이 없고, 탐색이 필요하고, 좋은 시뮬레이터와 보상이 있다 | 강화학습 (RL) | 강하지만 보상 설계와 시행착오 비용이 큼 |
| 실전 | 둘 다 | IL 로 그럴듯한 정책까지 빠르게 간 뒤 RL 로 마무리 |
그래서 이 편도 SFT → RFT 순서입니다.
시연 데이터 수집 — teleoperation 과 모방학습
SFT 에는 정답 시연이 필요합니다. 사람이 VR 컨트롤러나 리더 팔로 로봇을 직접 조종해 시연을 모으는 것이 teleoperation 이고, 이렇게 전문가 시연을 따라 배우는 방법론 전반이 imitation learning(모방학습), 그 가장 단순한 구현이 behavior cloning(BC) 입니다.
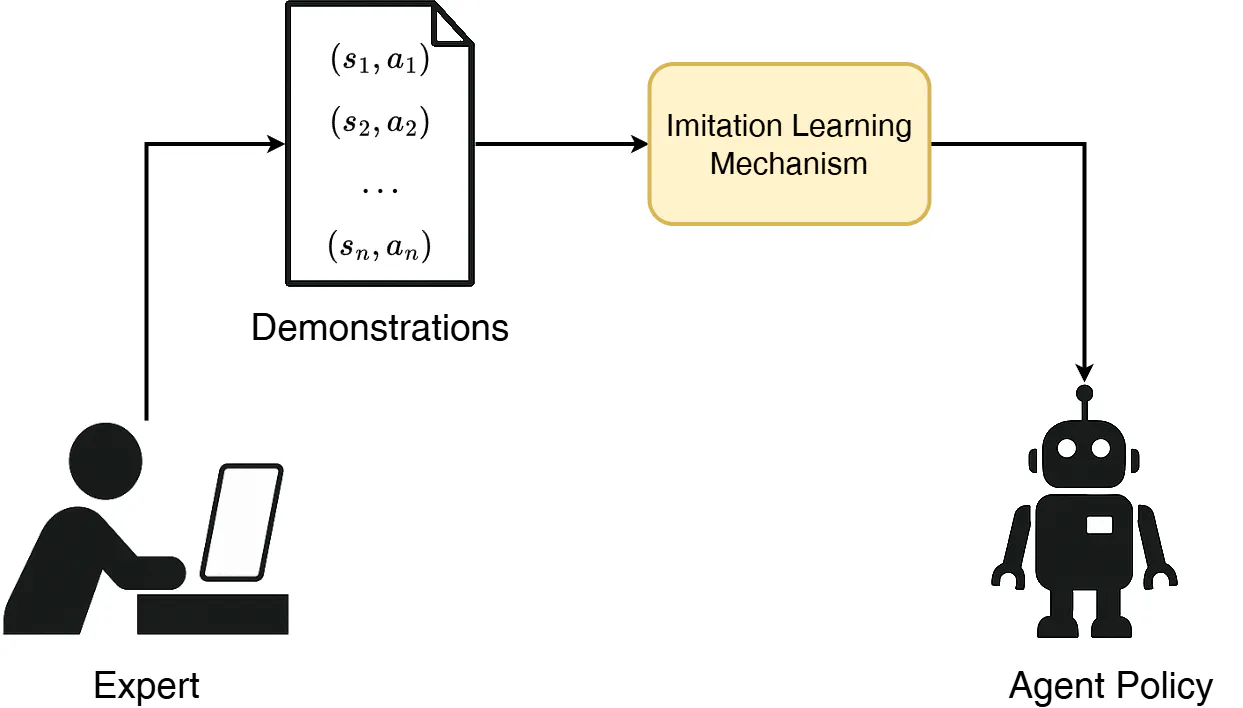
출처: Imitation Learning in the Deep Learning Era, arXiv:2511.03565 · CC BY 4.0
수집한 데이터는 episode 단위로 저장되고, 이 포맷을 표준화하는 대표 도구가 Hugging Face 의 LeRobot 입니다. 저가형 로봇팔과 데이터셋 포맷, 학습 코드를 한 묶음으로 제공해 입문 장벽을 크게 낮췄습니다.
일부 파라미터만 학습 — LoRA / PEFT
수십억 파라미터 모델을 통째로 재학습하면 GPU 도 시간도 감당이 안 됩니다. 그래서 일부 파라미터만 건드리는 PEFT(Parameter-Efficient Fine-Tuning) 전략을 씁니다.
강화학습으로 마무리 — reward, PPO, GRPO
시연 모방만으로는 사람의 실수까지 따라 배웁니다. 환경이 주는 보상(reward) 신호로 시행착오하며 더 잘하게 만드는 단계가 RFT 입니다.
강화학습은 어떤 행동을 해 보고, 그 결과가 평소보다 좋았으면 그 행동을 더 자주 하게, 나빴으면 덜 하게 정책을 조금 밉니다. 여기서 "평소보다" 를 판단하려면 기준이 필요합니다. 지금 이 상황에서 보통 얼마나 잘되는지를 알아야 이번 행동이 잘한 건지 못한 건지 말할 수 있기 때문입니다. 이 기준을 baseline 이라 하고, 그것을 어떻게 구하느냐가 아래 두 알고리즘의 차이입니다.
알고리즘으로는 critic 을 쓰는 PPO 가 오래 표준이었고, 최근에는 critic 없이 기준을 구하는 GRPO 가 급부상했습니다.
PPO — 조금씩, 대신 안정적으로
PPO 는 직전 정책에서 너무 멀리 벗어나지 않고 조금씩 개선합니다.
왜 조금씩일까요. 강화학습에서는 정책이 자기가 배울 데이터를 직접 만듭니다. 지금 정책이 방문하는 상태·행동이 곧 학습 데이터입니다. 한 번의 큰 업데이트로 정책이 망가지면 더 나쁜 데이터를 모아 더 나빠지는 악순환에 빠지고, 되돌아갈 고정 데이터셋이 없습니다. 그래서 PPO 는 매 업데이트를 직전 정책 근처로만 제한합니다.
비율 r = π_new(a|s) / π_old(a|s) 는 새 정책이 그 행동을 얼마나 더(또는 덜) 선택하게 됐는지, 즉 정책이 얼마나 바뀌었나를 잽니다. PPO 의 목적함수는
L = E[ min( r·A, clip(r, 1−ε, 1+ε)·A ) ] (ε ≈ 0.2)
입니다. clip 은 r 이 1 ± ε 범위를 벗어나면 목적함수를 평평하게 만들어 "더 멀어지라" 는 유인을 지웁니다. A(advantage) 는 "그 행동이 평균적 행동보다 얼마나 더 좋았나" 이고, 이 값을 추정하는 것이 앞서 본 critic 입니다.
GRPO — critic 없는 기준선
PPO 의 critic 은 정책망과 맞먹는 연산과 메모리를 따로 차지하기 때문에, 모델이 커질수록 그 부담도 함께 커집니다. GRPO 는 이 critic 을 아예 없애고, 대신 같은 상태에서 N 개의 rollout 을 돌려 그 그룹 평균을 기준선으로 씁니다. 어떤 rollout 이 평균보다 잘했으면 그쪽으로, 못했으면 반대로 정책을 밀고 당깁니다. GRPO 는 원래 언어 모델을 위해 만들어진 알고리즘입니다. DeepSeek-R1 이 수학·코딩 추론을 이 방법으로 학습해 유명해졌고, 그 뒤 같은 알고리즘을 VLA 의 RFT 에도 쓰기 시작했습니다.
근거: Schulman et al., PPO arXiv:1707.06347 · Shao et al., DeepSeekMath arXiv:2402.03300
보상 설계 — 알고리즘보다 어려운 것
강화학습에서는 알고리즘보다 보상을 어떻게 정의하느냐가 더 어렵습니다.
- sparse vs dense — 가장 단순한 보상은 성공 시에만 +1 인 sparse 입니다. 문제는 로봇이 수많은 시도 동안 단 한 번도 성공하지 못해 배울 신호 자체가 안 생기는 것입니다. 그래서 목표에 가까워질 때마다 조금씩 주는 dense 보상으로 유도합니다. 단, dense 는 설계자의 편견을 주입할 위험이 있습니다.
- reward hacking — 보상을 잘못 설계하면 로봇은 목표 대신 점수 자체를 해킹합니다. "앞으로 이동한 거리" 에 보상을 주면 제자리에서 빙글거리며 센서를 속이기도 합니다. 보상은 달성하고 싶은 결과 그 자체를 재야 합니다.
그래서 시뮬레이터의 충실도가 곧 보상의 충실도입니다. 시뮬레이션이 마찰·접촉·지연을 얼마나 충실히 재현하느냐가 보상 신호의 정확도이고, 학습 품질을 결정합니다.
실전 파이프라인 — teacher → student → bootstrapping
실제 연구에서 자주 보이는 조합입니다.
- teacher — 시뮬레이션 안에서만 볼 수 있는 특권 정보(정확한 물체 자세·접촉·속도)를 주고 PPO 로 강한 teacher 정책을 학습합니다.
- student — 카메라 이미지 + 관절 상태만 입력받는 student 정책을 따로 만듭니다. 특권 정보가 없으니 실물에도 그대로 올릴 수 있습니다. teacher 가 낸 행동을 정답 삼아 student 가 따라 배우게 하는데, 이를 distillation 이라 부르고 여기에 DAgger 와 BC 를 씁니다.
- bootstrapping — 성공 / 실패 보상만으로 GRPO 를 돌려 마무리합니다.
DAgger 가 무엇이고 왜 필요한지는 4편의 "모방학습의 한계"에서 다룹니다.
한 번에 여러 스텝 — action chunking 과 flow matching
로봇 제어는 아주 빠른 주기로 명령을 내야 부드럽습니다. 매 순간 무겁게 추론하면 느리니, 한 번의 추론으로 미래 여러 스텝의 행동을 한꺼번에 뽑는 action chunking 을 씁니다. 그 행동 묶음을 실제로 생성하는 방식으로는 flow matching 이 GR00T · π0 계열의 표준이 됐습니다. 이 둘은 4편에서 자세히 다룹니다.
다른 로봇에 이식 — embodiment adapter
같은 지능을 다른 로봇 몸에 옮기려면, 로봇마다 다른 관절 구성을 공통 표현으로 바꾸는 작은 신경망(MLP)만 fine-tuning 하면 되는 경우가 많습니다. 행동 자체를 새로 배워야 할 때만 더 깊은 부품까지 학습합니다. MLP 만 바꿔도 되는 이유는 4편의 GR00T 구조에서 설명합니다.
스스로 점검
Q1. BC / SFT 로 충분한데 굳이 RFT 를 더하는 이유는?
시연 모방은 사람의 실수까지 그대로 따라 배웁니다. 목표 달성 여부를 직접 채점하는 보상으로 시행착오하면 시연에 없던 더 나은 행동까지 찾아냅니다.
Q2. PPO 가 조금씩만 움직이는 것이 왜 중요한가?
정책이 자기가 배울 데이터를 직접 만들기 때문입니다. 한 번 크게 망가지면 더 나쁜 데이터를 모아 악순환에 빠지고 되돌아갈 데이터셋이 없습니다.
Q3. GRPO 는 PPO 와 무엇이 다른가?
"이번 행동이 평소보다 잘했나" 를 판단하는 기준(baseline)을 구하는 방법이 다릅니다. PPO 는 그 기준을 예측하는 신경망(critic)을 따로 학습시킵니다. GRPO 는 같은 상황에서 N 번 시도해 보고 그 평균 점수를 기준으로 쓰므로 critic 이 필요 없습니다.
요약
- 범용 모델을 내 로봇에 맞추는 흐름은 pre-training → SFT(내 시연 모방) → RFT(보상으로 마무리) 입니다.
- 로봇 학습은 부분 관측에서 행동을 예측하는 문제(POMDP)이고, 모방학습과 강화학습은 경쟁 관계가 아니라 순서대로 씁니다.
- PPO 는 정책이 자기 데이터를 만들기 때문에 조금씩 움직이고, GRPO 는 그룹 평균으로 critic 을 대체합니다. 보상 설계와 시뮬레이션 충실도가 알고리즘보다 중요합니다.
다음 편에서는 VLA 의 내부 구조에 대한 이야기입니다.
다음 편 → 4편 모델의 내부 구조 — System 1/2 · action chunk · flow matching · 모방학습의 한계