한 줄 정의
Physical AI 는 소프트웨어 속 답이 아니라 물리 세계에서의 행동을 만들어내는 AI 입니다.
지난 10년의 AI 는 대부분 화면 안에서 끝났습니다. 글을 쓰고, 이미지를 분류하고, 답을 생성했습니다. Physical AI 는 그 경계를 넘어 몸을 가진 기계가 현실에서 움직이고 물건을 다루게 만드는 분야입니다. 로봇팔이 "빨간 컵을 집어라"는 말을 알아듣고 실제로 집는 것, 4족 로봇이 처음 보는 창고를 스스로 돌아다니는 것이 모두 여기에 들어갑니다.
챗봇과의 결정적 차이 — 실패의 비용
챗봇이 틀리면 문장을 다시 쓰면 됩니다. 로봇이 틀리면 물건을 떨어뜨리거나 사람을 다치게 합니다. 그래서 Physical AI 는 "보기 → 판단 → 움직이기"가 실시간으로 계속 돌아가는 고리 안에서 작동해야 하고, 실제 로봇에 올리기 전에 시뮬레이션에서 충분히 검증합니다.
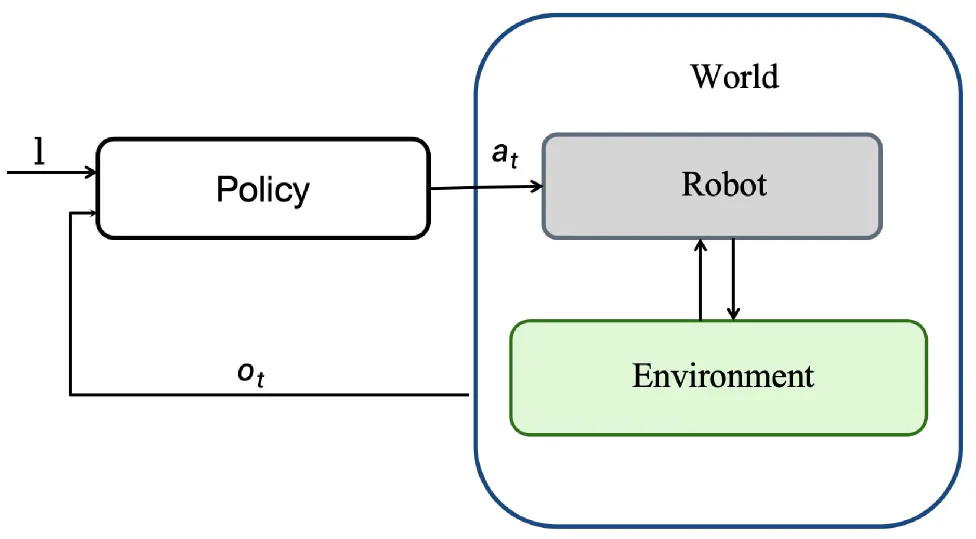
출처: Zhang, Zeng, Zhang, arXiv:2607.00836 Fig. 3 · CC BY 4.0
기본 개념 셋
뒤에 나오는 내용은 모두 이 세 가지를 바탕으로 설명합니다.
모듈 파이프라인 vs end-to-end
고전 로봇 소프트웨어는 인지·계획·제어를 서로 다른 모듈이 맡습니다. 인지 모듈이 카메라 영상에서 물체 위치를 추정하고, 계획 모듈이 그 위치로 경로를 만들고, 제어 모듈이 경로를 관절 명령으로 바꿉니다. 모듈 사이를 지날 때마다 정보가 줄어듭니다. 인지 모듈이 "컵이 대략 저기 있다"로 요약해 넘기면 제어 모듈은 그 요약만 보고 움직여야 합니다. VLA 는 카메라 영상과 언어 명령을 받아 관절 명령까지 신경망 하나가 통째로 냅니다. 중간 요약이 없으니 정보가 줄지 않습니다. 릴레이 경주에서 바통을 넘길 때마다 속도가 떨어지는 것과 한 선수가 끝까지 뛰는 것의 차이와 같습니다.
Moravec 의 역설 — Physical AI 가 늦은 이유
사람에게 쉬운 일(빨래 개기, 계단 걷기)이 기계에는 가장 어렵고, 사람에게 어려운 일(체스, 대규모 계산)은 오히려 쉽습니다. 디지털 AI 가 먼저 발전하고 Physical AI 가 뒤따르는 근본 이유입니다.
LLM 학습 단계와의 대응
GPT 의 학습 단계를 아신다면 아래 대응표로 바로 이해할 수 있습니다.
| 단계 | 언어 모델 | 로봇 모델 |
|---|---|---|
| 1. 대규모 사전학습 | 인터넷 텍스트 | 여러 로봇의 시연 데이터 (robot foundation model) |
| 2. 지시 맞춤 | instruction tuning | 사람이 조종해 모은 시연으로 미세조정 (teleoperation) |
| 3. 작업 특화 | 도메인 fine-tuning | 특정 작업·특정 로봇에 특화 |
그런데 로봇에는 언어 모델과 달리 학습 데이터가 거의 없습니다.
데이터 희소성 — 세 층의 피라미드
글과 사진은 인터넷에 사실상 무한히 있습니다. 반면 로봇이 실제로 물건을 집어 옮기며 남긴 기록은 아주 적습니다. 자릿수로 비교하면 수천 배에서 수백만 배 차이입니다. 그래서 로봇 학습은 인터넷의 흔한 데이터로 물체와 상식을 먼저 배우고, 귀한 로봇 데이터는 실제 움직임을 배우는 데만 아껴 씁니다. 아래 피라미드가 그 세 층입니다.
세 층의 규모 감각을 잡기 위해 각 층의 대표 데이터셋을 하나씩 적어 두었습니다.
- 위층 — LAION-5B. 인터넷에서 긁어모은 이미지와 그 설명 문장의 쌍 약 58.5억 개를 모은 공개 데이터셋입니다. 이미지 생성 모델과 비전-언어 모델이 "이 사진에 무엇이 있나" 를 배운 곳입니다. 로봇의 관절 명령은 한 줄도 없습니다.
- 가운데층 — Ego4D. 전 세계 9개국 931명이 머리에 카메라를 달고 요리·청소·조립 같은 일상 활동을 찍은 1인칭 영상 3,670시간입니다. 손이 어떤 순서로 움직이는지는 보이지만, 사람 손이라 로봇 몸과 다릅니다.
- 아래층 — Open X-Embodiment. 여러 연구팀이 서로 다른 로봇으로 모은 teleoperation 시연을 합친 데이터셋으로 약 100만 episode 입니다. 실제 관절 명령이 들어 있는 유일한 층이고, 그래서 가장 귀합니다.
단위가 층마다 다르니(쌍·시간·episode) 정밀 비교가 아니라 자릿수 비교로 보시면 됩니다. Physical AI 학습은 이 세 층을 어떻게 섞느냐의 문제이기도 합니다.
데모 판별 기준 — 비전·언어·행동 세 축
휴머노이드가 몇백 시간 연속으로 상자를 포장하는 데모가 화제가 됩니다. 인상적이지만, 로봇 지능을 비전(보기) + 언어(추론) + 행동(움직이기) 세 축으로 뜯어보면 이런 데모는 대개 비전과 행동만 보여 줍니다. 균일한 물체를 반복 처리하는 장면에서는 "왜 멈췄는지 설명하거나 처음 보는 상황을 추론하는" 언어·추론 축이 드러나지 않습니다.
| 축 | 하는 일 | 반복 포장 데모에서 |
|---|---|---|
| Vision | 물체를 본다 | 대개 보임 |
| Language | 추론하고 설명한다 | 잘 안 보임 |
| Action | 잡아서 옮긴다 | 대개 보임 |
정해진 일을 아주 잘하는 로봇과, 규칙에 안 맞는 예외 상황에 스스로 대응하는 로봇은 다릅니다. 후자를 일반화(generalization) 라 부르고, 이 언어·추론 축이 그 관건입니다. 데모를 볼 때는 "세 축 중 무엇이 실제로 증명됐나" 를 먼저 물으시면 됩니다.
형태보다 기능. 휴머노이드가 Physical AI 의 상징처럼 보이지만, 평평한 창고 바닥에서는 다리 대신 바퀴 + 팔이면 충분한 경우가 많습니다. 화려한 형태가 곧 검증된 기능은 아닙니다.
로봇의 몸과 감각
embodiment — 로봇마다 다른 몸
로봇팔, 휴머노이드, 4족 보행 로봇은 관절 수도 생김새도 다릅니다. 이 서로 다른 몸을 embodiment 라 부르고, "하나의 지능을 여러 embodiment 에 어떻게 옮길 것인가" 가 이 분야의 큰 숙제입니다. 크게 manipulator(로봇팔), quadruped(4족), humanoid(휴머노이드), AMR(자율이동로봇)으로 나뉩니다.
센서 — 세상을 느끼는 입력
행동하려면 먼저 지각해야 합니다. 거리를 재는 LiDAR, 색과 깊이를 함께 주는 depth camera, 자기 움직임을 재는 IMU, 접촉힘을 재는 force-torque 센서가 대표입니다. 이런 입력의 종류를 modality 라 부릅니다.
로봇의 두뇌 — policy, 그 최신형 VLA
로봇이 "지금 상황에서 무엇을 할지" 정하는 함수를 policy 라고 합니다. 강화학습에서 온 용어입니다. 원래 뜻은 "방침" 인데, 상황마다 어떤 행동을 할지 정해 둔 규칙표라는 뜻으로 굳었습니다. 관측(observation)을 입력받아 행동(action)을 출력합니다. 최근 몇 년 사이 이 policy 를 대형 신경망 하나로 통째로 만드는 흐름이 주류가 됐고, 그 대표가 VLA 입니다.
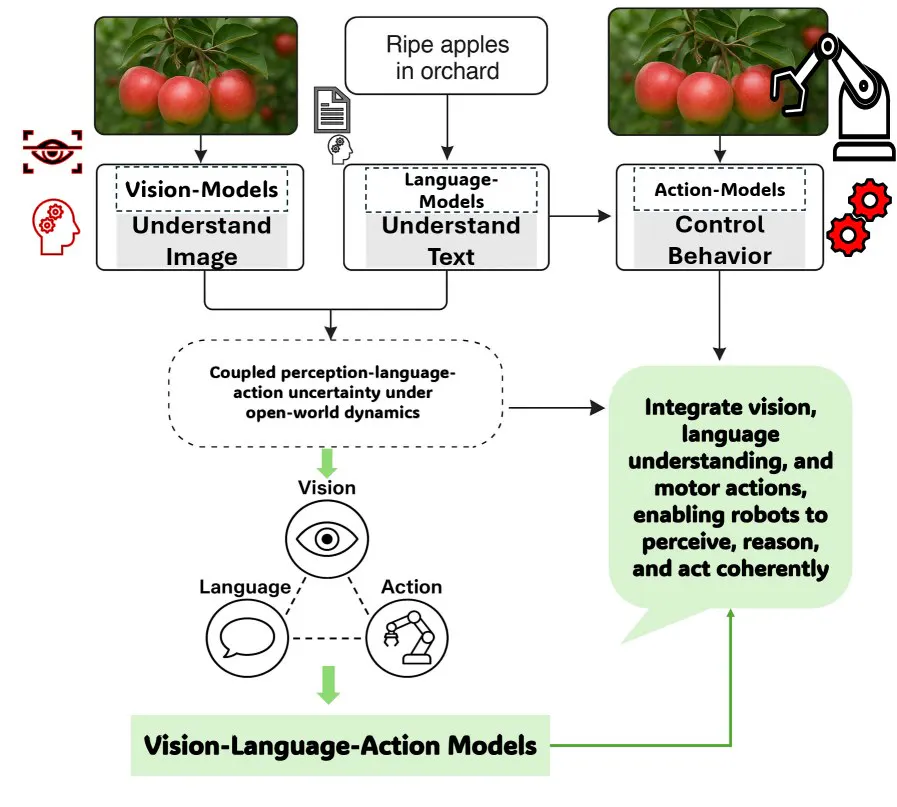
출처: Vision-Language-Action Models survey, arXiv:2505.04769 Fig. 1 · CC BY 4.0
VLA 의 내부 구조는 4편에서 설명합니다. 지금은 "관측을 받아 행동을 내는 함수" 라는 정의만 기억해 두시면 됩니다.
행동의 전제 — 내가 어디 있는지 알기
물건을 집든 길을 찾든, 이동 로봇은 먼저 자기 위치와 주변 지도가 있어야 합니다. 그런데 위치를 알려면 지도가 필요하고, 지도를 만들려면 위치를 알아야 하는 순환이 생깁니다. 이걸 확률적으로 동시에 푸는 것이 SLAM 입니다. 로봇팔 조작에서는 덜 등장하지만 AMR 의 핵심 기술입니다.
실물 로봇의 비용 — 시뮬레이션이 필요한 이유
실제 로봇으로 수백만 번 시행착오를 하긴 어렵습니다. 그래서 실제 로봇과 환경을 그대로 본뜬 digital twin 을 만들어 그 안에서 학습하고 검증합니다. 실물 로봇에는 세 가지 부담이 있습니다.
- 가격 — 4족 보행 로봇 약 1,600달러에서 휴머노이드 13만 달러대까지. 시뮬레이션에서는 대수를 늘려도 비용이 거의 0입니다.
- 구조 — 휴머노이드 원가의 절반가량이 관절(actuator)입니다. 시뮬레이션 속 관절은 마모도 고장도 없습니다.
- 규제 — 한국은 산업용 로봇에 1.8 m 이상 울타리와 의무 안전인증을 법으로 요구합니다. 시뮬레이션에는 방호 설비도 사고도 없습니다.
문제는 시뮬레이션과 현실 사이의 미세한 차이입니다. 이걸 sim-to-real gap 이라 하고, 2편 끝에서 다시 다룹니다.
요약
- Physical AI 는 현실에서 행동하는 AI 이고, 실패의 비용 때문에 closed-loop 와 시뮬레이션 검증이 기본입니다.
- 로봇의 두뇌는 policy(관측 → 행동 함수)입니다. 카메라 영상과 언어 지시를 받아 관절 명령을 내는 VLA 가 지금 가장 활발히 연구되는 policy 입니다.
- 언어 모델의 사전학습 → 미세조정 → 특화 3단계가 로봇에도 옮겨오지만, 로봇 데이터는 수천 배에서 수백만 배 적어서 데이터 피라미드의 위층을 최대한 끌어 씁니다.
다음 편에서는 모델을 구분하는 다섯 가지 질문과 연구가 어디까지 왔는지에 대한 이야기입니다.
다음 편 → 2편 연구 지형 — foundation model · VLA · world model · 시뮬레이션