이 편의 목표
로봇을 다룰 때 반드시 만나는 개념과 용어를 이해하는 것입니다. 구조 기술, 제어, 관측 순서로 설명합니다.
로봇 구조 기술 — URDF
로봇의 물리 구조를 XML 로 적은 표준이 URDF(Unified Robot Description Format) 입니다. 어떤 부품(link)이 어떤 관절(joint)로 연결되고, 무게와 충돌 형상이 어떤지가 들어갑니다. 관절 개수가 그 로봇의 자유도를 결정합니다. ROS 생태계의 사실상 표준이고, 시뮬레이터에 로봇을 올릴 때 입력이 됩니다.
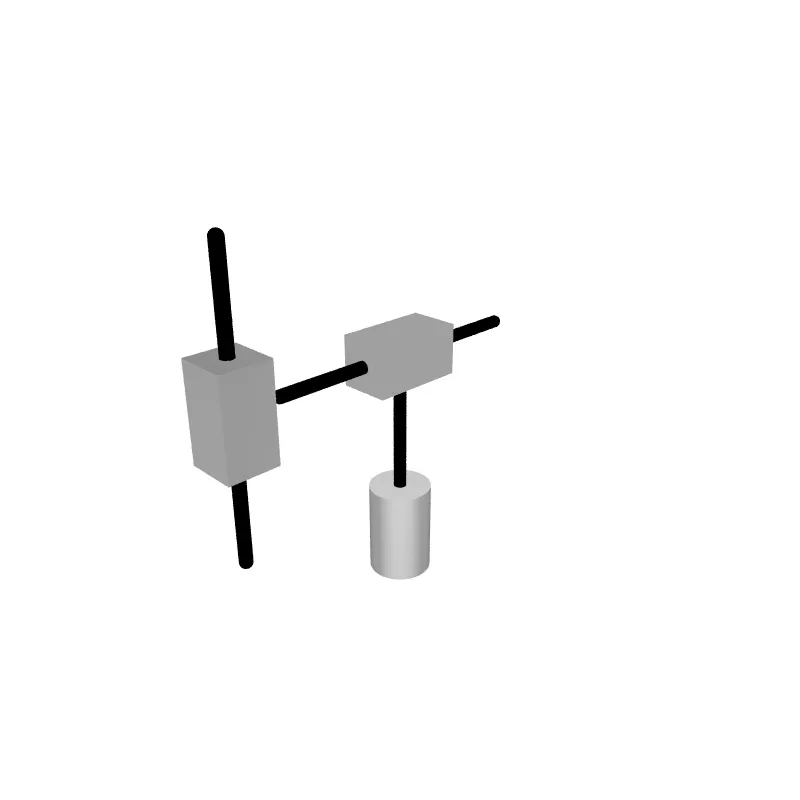
출처: Wikimedia Commons, Cylindrical configuration · CC BY-SA 3.0
최신 시뮬레이션 파이프라인에서는 URDF 를 더 풍부한 3D 장면 표준인 OpenUSD 로 변환해 렌더링·물리 시뮬레이션에 씁니다. URDF 가 로봇 한 대의 구조만 적는다면 USD 는 로봇과 환경을 층층이 합성한 장면 전체를 적습니다.
end-effector 와 FK / IK
로봇팔 끝에서 실제로 물건을 잡는 부분이 end-effector(EEF) 입니다. 그리퍼나 손이 여기에 해당합니다.
관절 각도에서 손끝 위치를 구하는 것이 forward kinematics(FK), 반대로 "손끝을 여기로" 지정하면 관절 각도를 역산하는 것이 inverse kinematics(IK) 입니다. FK 는 답이 하나이고 계산이 쉽습니다. IK 는 해가 여러 개일 수 있고(같은 손끝 위치를 만드는 팔 자세는 여럿), 아예 없을 수도 있습니다(닿지 않는 위치).
| 방향 | 입력 | 출력 | 해의 개수 |
|---|---|---|---|
| FK | 관절 각도 | 손끝 위치·자세 | 항상 하나 |
| IK | 손끝 위치·자세 | 관절 각도 | 여럿 또는 없음 |
FK · IK 가 어디에 쓰이는지는 행동을 관절 각도로 적을지 손끝 위치로 적을지에 따라 다릅니다. 그 선택에 따라 변환이 수집 때 들어가기도 하고 추론 때 들어가기도 합니다.
- 수집 때 — 리더 팔로 조종하면 사람이 관절을 직접 움직이므로 관절 각도가 그대로 기록되고 변환이 없습니다. VR 컨트롤러나 손잡이 장치로 조종하면 손끝 위치만 얻어지므로, 로봇이 그 손끝을 따라가게 하려고 수집 중에 IK 로 관절 명령을 만듭니다.
- 추론 때 — 정책이 관절 각도를 내면 변환이 없습니다. 정책이 손끝 위치를 내도록 학습했다면 추론 때 IK 로 관절 명령을 만듭니다.
- 그 밖에 — 관절 한계·충돌 검사 같은 안전 제한과 시뮬레이션 검증에서는 손끝이 어디 있는지 알아야 하므로 FK 가 늘 쓰입니다.
수집 때 IK 와 추론 때 IK 는 장단점이 다릅니다.
| 수집 때 IK (관절 각도로 저장·학습) | 추론 때 IK (손끝 위치로 저장·학습) | |
|---|---|---|
| 실행 | 단순하고 빠름. 저장된 관절값은 로봇이 실제로 취한 자세라 그대로 재현됨 | 매 스텝 IK 계산과 실패 처리가 실시간 경로에 들어감 |
| IK 실패 | 수집 단계에서 걸러짐. 실패한 episode 는 버리면 됨 | 정책이 도달 불가 위치를 내면 그 자리에서 실패 |
| 팔 자세 | 데이터에 고정됨 | 같은 손끝에 팔 자세가 여럿이라 스텝마다 튈 수 있어 연속성 유지 로직이 필요 |
| 이식성 | 낮음. 그 로봇 전용 데이터 | 높음. 로봇이 달라도, 로봇 없이 손잡이 장치로 모아도 됨 |
| 맞는 경우 | 로봇 한 대를 정해 두고 쓸 때 | 여러 로봇에 옮기거나 손잡이 장치로 수집할 때 |
실무에서는 수집 때 IK 를 써서 관절값으로 저장하는 쪽 이 많습니다. 정책은 관절 각도를 배우고, 추론 때는 IK 를 돌리지 않습니다.
관절 각도 쪽으로 기운 이유는 손끝 위치만으로는 팔의 자세와 양팔 사이의 간섭을 표현할 수 없기 때문입니다. 양팔·휴머노이드로 갈수록 그 정보가 필요합니다.
계층 제어와 제어 주기
로봇 제어는 보통 두 층으로 나뉩니다. "어디로 갈지, 무엇을 할지" 를 낮은 빈도로 정하는 high-level policy 와, 그것을 실제 관절 명령으로 빠르게 바꾸는 low-level policy 입니다. 갱신 빈도를 control frequency(제어 주기, Hz) 라 하고, 보통 low-level 이 훨씬 빠릅니다. 걷기 제어는 50 Hz 이상, 상위 판단은 5~10 Hz 정도입니다.
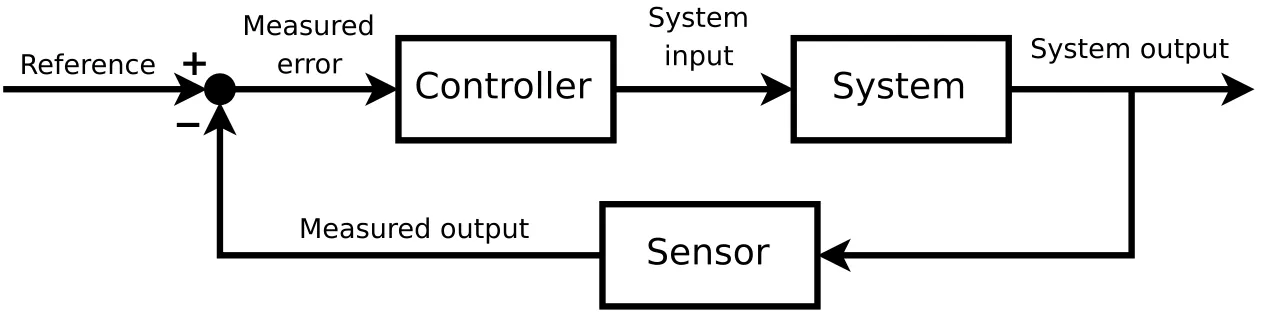
출처: Orzetto, Wikimedia Commons, Feedback loop with descriptions · CC BY-SA 4.0
4편의 System 2 / System 1 이 바로 이 계층의 학습형 구현입니다. VLM 이 낮은 빈도로 이해하고, action head 가 chunk 로 높은 빈도의 명령을 채웁니다. "느린 추론과 빠른 제어의 주파수 불일치" 가 미해결 문제로 꼽히는 이유도 여기에 있습니다.
관측의 종류
로봇이 받는 입력에는 여러 종류(modality)가 있습니다.
| modality | 무엇 | 왜 중요한가 |
|---|---|---|
| 카메라 영상 | 3인칭 고정 카메라, 1인칭·손목 카메라 | 물체와 장면을 봅니다 |
| 언어 지시 | "빨간 컵을 왼쪽에" | 무엇을 할지 정합니다 |
| 고유감각(proprioception) | 자기 관절 각도·속도·토크 | 카메라 없이도 팔이 어디 있는지 압니다 |
| 힘·접촉 | 손목 force-torque, 그리퍼 압력 | 잡았는지, 얼마나 세게 쥐었는지 압니다 |
미해결 문제 다섯 가지
마지막으로 이 분야가 아직 풀지 못한 문제를 다섯 가지로 묶습니다. 데모 영상이나 논문을 볼 때 어느 문제의 진전인지 가늠하는 기준으로 쓰시면 됩니다.
| 문제 | 핵심 질문 | 현재 한계 |
|---|---|---|
| representation — 행동 표현 | 행동을 어떤 형태로 표현해야 잘 배우고 잘 옮겨지나. raw action 인지, chunk 인지, 언어·코드인지 | 표현마다 정밀도·일반화·속도의 trade-off 가 다르고 정답 표현이 없음 |
| execution — 실행 | 느린 추론(System 2)과 빠른 제어(System 1)의 주파수 불일치를 어떻게 메우나 | 큰 VLA 는 무거워 로봇 위 실시간이 어렵고, 클라우드로 빼면 지연·연결 문제 |
| generalization — 전이 | 한 로봇·한 환경에서 배운 것을 다른 몸·새 물체·새 장면으로 얼마나 옮기나 | sim-to-real gap 과 cross-embodiment 전이는 여전히 미해결 |
| safety — 안전 | 물리적으로 힘을 쓰는 로봇이 사람·환경에 위험하지 않다고 어떻게 보장하나 | 실패가 물리 피해로 직결. 전용 survey 가 따로 나올 만큼 독립 난제 |
| dataset & eval — 데이터와 평가 | 데이터를 어떻게 충분히 모으고(teleoperation 은 비쌈), 모델을 어떻게 공정히 비교하나 | loss 로는 성공을 못 잼. 벤치마크·rollout 성공률도 표준화 진행 중 |
다섯 문제는 서로 얽혀 있습니다. 표현이 좋아지면 일반화가 쉬워지고, 평가가 정확해야 안전을 보장할 수 있습니다. 인상적인 데모를 볼 때 이 다섯 중 무엇을 실제로 전진시켰는지 물으면 과장과 진짜 진전을 가릴 수 있습니다.
다섯 편 요약
각 편의 한 문장 요약입니다.
- Physical AI 는 현실에서 행동하는 AI 이고, 그 두뇌는 관측 → 행동 함수인 policy 입니다.
- 연구는 foundation model 위에서 돌아가고, VLA 는 backbone 의 선택지, diffusion / flow matching 은 action head 의 선택지입니다.
- 내 로봇에 맞추는 흐름은 사전학습 → 시연 모방(SFT) → 보상 강화(RFT) 입니다.
- 모델 안에서는 System 2 가 이해하고 System 1 이 chunk 를 flow matching 으로 뽑으며, 모방학습의 한계은 covariate shift 입니다.
- 로봇 자체는 URDF · FK / IK · 제어 주기 · 고유감각(proprioception)의 언어로 다루고, 미해결 문제는 다섯 가지입니다.
마지막 6편에서는 시뮬레이션과 학습을 어디서 돌리는지에 대한 이야기입니다.