들어가며
1편 Attention Is All You Need에서 Transformer는 단어 토큰열을 받아 self-attention으로 토큰 사이 관계를 계산하는 모델이었습니다. 2편 GPT-3은 같은 구조를 키우고 데이터를 늘리면 성능이 계속 오른다는 것을 보였습니다. 두 논문 모두 입력은 텍스트였습니다.
2020년까지 이미지 인식은 여전히 합성곱 신경망(Convolutional Neural Network, CNN)이 주류였습니다. self-attention을 이미지에 쓰려는 시도는 있었지만, 대부분 합성곱과 섞어 쓰거나 특수한 주의 패턴을 설계해야 해서 대규모로 학습하기 어려웠습니다.
ViT(Vision Transformer) 는 이미지를 고정 크기 패치(patch)로 잘라 한 줄로 늘어놓고, 각 패치를 단어 토큰처럼 취급해 표준 Transformer 부호기(encoder)에 그대로 넣습니다. 저자들은 구조를 일부러 거의 바꾸지 않았습니다. 그 대신 사전학습 데이터를 1,400만 장에서 3억 장 규모로 키우면, 이미지에 맞춘 가정이 없는 이 모델이 최신 CNN을 따라잡거나 앞선다는 것을 실험으로 보입니다.
📄 An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale — Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, Matthias Minderer, Georg Heigold, Sylvain Gelly, Jakob Uszkoreit, Neil Houlsby / Google Research, Brain Team, ICLR 2021
미세조정 코드와 사전학습 모델은 github.com/google-research/vision_transformer에 공개돼 있습니다. arxiv 식별자는 2010.11929이고, 이 글은 2021-06-03에 올라온 v2를 기준으로 합니다.
초록 요약
자연어 처리에서는 Transformer가 사실상 표준이 됐지만, 컴퓨터 비전에서는 쓰임이 제한적이었습니다. 비전에서 주의(attention)는 합성곱 신경망과 함께 쓰이거나, 전체 구조는 그대로 둔 채 일부 구성 요소만 대신하는 식이었습니다. 저자들은 CNN에 기대지 않아도 된다고 주장합니다. 이미지 패치열에 순수 Transformer를 바로 적용해도 이미지 분류를 매우 잘 해냅니다. 대량의 데이터로 사전학습한 뒤 ImageNet, CIFAR-100, VTAB 같은 중소 규모 벤치마크로 옮기면, ViT는 최신 합성곱 신경망보다 좋은 결과를 내면서 사전학습에 드는 계산 자원은 훨씬 적습니다.

그림 1 — 이미지를 패치로 자르고 선형 임베딩과 위치 임베딩을 더해 표준 Transformer 부호기에 넣습니다.
위 그림은 ViT의 처리 순서를 보여줍니다. 왼쪽 아래에서 이미지를 같은 크기의 패치로 자르고, 각 패치를 펼쳐 선형 투영(linear projection)으로 벡터로 바꿉니다. 맨 앞에 학습 가능한 분류용 토큰 하나를 붙이고, 모든 토큰에 위치 임베딩(position embedding)을 더한 뒤 Transformer 부호기에 넣습니다. 부호기 출력 중 분류용 토큰 자리의 벡터만 MLP 헤드(MLP head)에 넣어 클래스를 예측합니다. 오른쪽은 부호기 한 층의 내부로, 1편의 Transformer 부호기와 같습니다.
1. 문제 — 이미지 인식의 합성곱 신경망 의존
자연어 처리와 비전의 차이
자연어 처리에서는 큰 텍스트 말뭉치로 사전학습하고 작업별 소규모 데이터셋으로 미세조정하는 방식이 자리 잡았습니다(BERT). Transformer는 계산 효율과 확장성이 좋아 파라미터가 1,000억 개를 넘는 모델까지 학습할 수 있었고, 모델과 데이터를 키워도 성능이 포화하는 조짐이 없었습니다.
비전에서는 대규모 이미지 인식의 최고 성능이 여전히 ResNet 계열 구조에서 나왔습니다. self-attention을 이미지에 적용한 연구는 여러 방식이 있었지만 각각 제약이 있었습니다.
| 기존 접근 | 방법 | 한계 |
|---|---|---|
| 픽셀 단위 전역 self-attention | 모든 픽셀이 모든 픽셀을 참고 | 픽셀 수의 제곱에 비례하는 비용이라 실제 해상도에 적용 불가 |
| 국소 self-attention (Parmar et al., 2018 등) | 질의 픽셀 주변 영역에서만 주의 계산, 합성곱을 완전히 대체 가능 | 특수한 주의 패턴이라 하드웨어 가속기에서 효율적으로 구현하기 어려움 |
| Sparse Transformer (Child et al., 2019) | 전역 self-attention의 확장 가능한 근사 | 복잡한 엔지니어링 필요 |
| 축 방향 주의(axial attention) (Ho et al., 2019 등) | 행과 열 방향으로 따로 주의 계산 | 같은 문제 |
| Cordonnier et al. (2020) | 2 × 2 패치에 전체 self-attention | ViT와 매우 비슷하지만 작은 패치라 저해상도 이미지에만 적용 가능, 대규모 사전학습 효과는 보이지 않음 |
| CNN + self-attention 결합 | 특징 지도 보강, CNN 출력을 self-attention으로 후처리(검출·영상·분류) | 합성곱 구조를 그대로 유지 |
| image GPT (iGPT) | 해상도와 색 공간을 줄인 픽셀에 Transformer를 생성 모델로 비지도 학습 | ImageNet 최고 정확도 72% |
ViT는 이 목록과 방향이 다릅니다. 이미지 전용 주의 패턴을 설계하지 않고, 자연어 처리에서 쓰는 표준 Transformer를 가능한 한 수정 없이 가져옵니다. 그러면 이미 확장성이 검증된 자연어 처리용 Transformer 구현을 거의 그대로 쓸 수 있습니다.
저자들의 관찰
ImageNet 같은 중간 규모 데이터셋에서 강한 정규화 없이 학습하면, ViT는 비슷한 크기의 ResNet보다 정확도가 몇 퍼센트포인트 낮습니다. 저자들은 이 결과가 예상 가능하다고 봅니다. Transformer에는 CNN이 가진 이동 등변성(translation equivariance)과 국소성(locality) 같은 귀납 편향(inductive bias)이 없어서, 데이터가 부족하면 일반화가 잘 되지 않습니다.
그런데 1,400만 장에서 3억 장 규모 데이터셋으로 학습하면 결과가 달라집니다. 논문은 이를 "대규모 학습이 귀납 편향보다 더 큰 영향을 준다"고 요약합니다. 가장 좋은 모델은 ImageNet 88.55%, ImageNet-ReaL 90.72%, CIFAR-100 94.55%, 19개 작업으로 이루어진 VTAB 77.63%에 도달합니다.
2. 모델 구조 — 패치에서 분류 출력까지
전체 흐름을 먼저 한 번에 봅니다. 예시 수치는 224 × 224 이미지를 16 × 16 패치로 자르는 ViT-B/16 기준입니다.
패치 분할과 선형 투영
표준 Transformer는 1차원 토큰 임베딩열을 입력으로 받습니다. 2차원 이미지를 이 형식에 맞추려고, 높이 ·너비 ·채널 인 이미지 를 한 변이 픽셀인 패치로 자른 뒤 각 패치를 펼칩니다. 그러면 패치열 가 되고, 패치 수 가 곧 Transformer의 입력 시퀀스 길이입니다.
224 × 224 RGB 이미지를 16 × 16 패치로 자르면 가로세로 14개씩 196개 패치가 나오고, 패치 하나를 펼치면 16 × 16 × 3 = 768개 값입니다. Transformer는 모든 층에서 같은 크기 의 벡터를 쓰므로, 펼친 패치를 학습 가능한 선형 투영 로 차원에 옮깁니다. 이 투영의 출력을 패치 임베딩(patch embedding) 이라고 부릅니다.
논문 제목의 "16x16 Words"는 이 설계를 가리킵니다. 16 × 16 픽셀 패치 하나가 문장의 단어 하나와 같은 자리에 들어갑니다.
[class] 토큰
BERT의 [class] 토큰과 같은 방식으로, 패치 임베딩열 맨 앞에 학습 가능한 벡터 를 하나 붙입니다. 이 토큰은 특정 패치에 대응하지 않고, 부호기의 모든 층에서 self-attention으로 패치들의 정보를 모읍니다. 마지막 층 출력에서 이 자리의 벡터 를 이미지 전체의 표현 로 씁니다.
분류 헤드는 사전학습 때는 은닉층 하나짜리 MLP이고, 미세조정 때는 선형층 하나입니다.
위치 임베딩
self-attention은 입력 토큰의 순서를 구분하지 않습니다. 패치 순서를 섞어도 계산 결과가 같은 방식으로 섞일 뿐이라, 어느 패치가 어디에 있었는지는 따로 알려줘야 합니다. 그래서 패치 임베딩에 위치 임베딩을 더합니다.
ViT는 학습 가능한 표준 1차원 위치 임베딩을 씁니다. 패치를 왼쪽 위부터 행 순서로 번호를 매기고 번호마다 벡터 하나를 학습합니다. 2차원 구조를 반영한 위치 임베딩도 시험했지만 뚜렷한 이득이 없었습니다(부록 D.4, 이 글 10절).
Transformer 부호기
부호기는 다중 헤드 self-attention(Multihead Self-Attention, MSA) 블록과 MLP 블록이 번갈아 쌓인 구조입니다. 각 블록 앞에 층 정규화(Layer Normalization, LN)를, 각 블록 뒤에 잔차 연결(residual connection)을 둡니다. MLP는 GELU 비선형 함수를 쓰는 2층 구조입니다.
첫 식은 [class] 토큰과 투영한 패치 개를 이어 붙이고 위치 임베딩을 더하는 입력 단계입니다. 둘째와 셋째 식이 한 층이고, 이를 번 반복합니다. 마지막 식은 [class] 자리의 출력만 꺼내 정규화합니다.
부록 A는 self-attention 계산을 다시 적습니다. 입력 에 행렬 를 곱해 질의 , 키 , 값 를 만들고, 주의 가중치 로 값을 가중합합니다. 다중 헤드는 이 계산을 개 병렬로 돌려 이어 붙인 뒤 로 투영하는 방식이고, 헤드 수를 바꿔도 계산량과 파라미터 수가 같도록 로 둡니다. 1편에서 다룬 계산과 같습니다.
3. 귀납 편향과 하이브리드 구조
ViT와 CNN의 귀납 편향 차이
귀납 편향은 학습하기 전에 모델 구조에 미리 넣어 둔 가정입니다. CNN은 모든 층에 세 가지 가정이 들어 있습니다. 가까운 픽셀끼리만 먼저 계산한다는 국소성, 이미지가 2차원 이웃 구조를 가진다는 가정, 물체가 이동하면 특징 지도도 같은 만큼 이동한다는 이동 등변성입니다.
ViT에는 이런 가정이 훨씬 적습니다.
| 가정 | CNN | ViT |
|---|---|---|
| 국소성·이동 등변성 | 모든 합성곱 층 | MLP 층만 (패치마다 독립 계산) |
| 전역 계산 | 층을 깊게 쌓아야 수용 영역이 넓어짐 | self-attention 층은 첫 층부터 전역 |
| 2차원 이웃 구조 | 모든 층 | 처음 패치로 자를 때, 미세조정 해상도를 바꿀 때 위치 임베딩 보간에서만 |
| 패치 사이 공간 관계 | 구조에 내장 | 초기 위치 임베딩에 2차원 위치 정보가 없어 전부 데이터에서 학습 |
가정이 적으면 적은 데이터로는 공간 구조를 스스로 배우기 어렵고, 데이터가 충분하면 가정에 묶이지 않고 데이터에서 직접 패턴을 배웁니다. 4절과 7절의 실험이 이 차이를 수치로 보여줍니다.
하이브리드 구조
원본 픽셀 패치 대신 CNN의 특징 지도를 입력열로 쓸 수도 있습니다. 이 하이브리드(hybrid) 모델에서는 패치 임베딩 투영 를 CNN 특징 지도에서 뽑은 패치에 적용합니다. 특수한 경우로 패치 크기를 1 × 1로 두면, 특징 지도의 공간 차원을 펼쳐 Transformer 차원으로 투영하는 것과 같습니다. [class] 토큰과 위치 임베딩은 똑같이 더합니다.
실험에서는 ResNet50의 중간 특징 지도를 1 × 1 패치로 넣습니다. 시퀀스 길이를 바꾸려고 두 가지를 씁니다.
| 방식 | 사용하는 특징 지도 | 시퀀스 길이 |
|---|---|---|
| (i) | 일반 ResNet50의 4단계 출력 | 기준 |
| (ii) | 4단계를 없애고 같은 수의 층을 3단계에 옮겨 넣은 확장 3단계 출력 | (i)의 4배, ViT 쪽 계산량 증가 |
하이브리드 이름 끝의 숫자(R50+ViT-B/16의 16)는 패치 크기가 아니라 ResNet 백본의 전체 다운샘플링 비율입니다.
4. 미세조정과 해상도 변경
ViT는 보통 큰 데이터셋으로 사전학습하고 작은 후속 작업으로 미세조정합니다. 미세조정할 때는 사전학습한 예측 헤드를 떼고, 0으로 초기화한 선형층을 붙입니다. 는 후속 작업의 클래스 수입니다. 부록 B.1.1에 따르면 헤드 전체(선형층 2개)를 떼고 선형층 하나로 바꾸는 편이 마지막 층만 다시 초기화하는 것보다 조금 더 안정적이었습니다.
사전학습보다 높은 해상도로 미세조정하면 대개 성능이 오릅니다. 해상도를 올릴 때 패치 크기는 그대로 두므로 패치 수가 늘어나 시퀀스가 길어집니다. Transformer는 메모리가 허락하는 한 어떤 길이의 시퀀스든 처리하지만, 사전학습한 위치 임베딩은 원래 패치 개수에 맞춰져 있어 그대로는 의미가 맞지 않습니다. 그래서 사전학습한 위치 임베딩을 원래 이미지에서의 위치에 따라 2차원 보간(interpolation)합니다.
이 해상도 조정과 처음의 패치 분할이, 이미지의 2차원 구조에 대한 가정을 사람이 직접 넣는 유일한 두 지점입니다.
5. 실험 설정
데이터셋
| 데이터셋 | 클래스 수 | 이미지 수 | 용도 |
|---|---|---|---|
| ImageNet (ILSVRC-2012) | 1k | 1.3M | 사전학습·후속 작업 |
| ImageNet-21k | 21k | 14M | 사전학습 (공개) |
| JFT-300M | 18k | 303M 고해상도 | 사전학습 (구글 내부) |
사전학습 데이터셋에서는 후속 작업 시험 세트와 겹치는 이미지를 제거했습니다.
후속 작업은 ImageNet(원래 검증 라벨과 정리한 ReaL 라벨), CIFAR-10/100, Oxford-IIIT Pets, Oxford Flowers-102입니다. 여기에 19개 작업으로 이루어진 VTAB 분류 모음을 더합니다. VTAB은 작업마다 학습 예시 1,000개만 주고 옮겨 학습하는 벤치마크로, 세 묶음으로 나뉩니다.
| VTAB 묶음 | 내용 |
|---|---|
| Natural | Pets, CIFAR 같은 일반 사진 작업 |
| Specialized | 의료 영상, 위성 영상 |
| Structured | 위치 추정처럼 기하 이해가 필요한 작업 |
모델 변형
ViT 설정은 BERT를 따릅니다. Base와 Large는 BERT에서 그대로 가져왔고 더 큰 Huge를 추가했습니다.
| 모델 | 층 수 | 은닉 크기 | MLP 크기 | 헤드 수 | 파라미터 |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86M |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307M |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632M |
표 1 — Vision Transformer 모델 변형.
이름 표기는 크기와 패치 크기를 함께 적습니다. ViT-L/16은 Large 모델에 16 × 16 패치를 쓴다는 뜻입니다. 시퀀스 길이는 패치 크기의 제곱에 반비례하므로, 패치가 작을수록 계산 비용이 커집니다.
비교 기준 CNN은 ResNet인데, 배치 정규화(Batch Normalization)를 그룹 정규화(Group Normalization)로 바꾸고 표준화된 합성곱(standardized convolution)을 씁니다. 이 수정은 전이 성능을 높이며, 논문은 이 모델을 "ResNet (BiT)"라고 부릅니다.
학습과 평가 방식
ResNet을 포함한 모든 모델을 Adam(, ), 배치 크기 4096, 가중치 감쇠 0.1로 사전학습합니다. ResNet은 보통 SGD로 학습하지만, 이 설정에서는 Adam이 조금 더 좋았습니다(10절 표 7). 학습률은 선형 워밍업 후 감소시킵니다. 미세조정은 모든 모델에 모멘텀 SGD, 배치 크기 512를 씁니다. 표 2의 ImageNet 결과는 ViT-L/16을 512, ViT-H/14를 518 해상도로 미세조정하고, 계수 0.9999의 Polyak 평균을 추가로 적용한 값입니다.
성능은 두 가지로 잽니다. 미세조정 정확도 는 각 데이터셋으로 미세조정한 뒤의 정확도입니다. 선형 퓨샷(few-shot) 정확도 는 사전학습한 표현을 고정한 채, 학습 이미지 일부의 표현을 목표 벡터로 보내는 정규화 최소제곱 회귀를 풀어 얻습니다. 닫힌 해가 있어 빠르게 계산되므로, 미세조정 비용이 너무 클 때 빠른 평가용으로 씁니다.
6. 최신 모델과의 비교
가장 큰 모델인 ViT-H/14와 ViT-L/16을 문헌의 최신 CNN 두 가지와 비교합니다. 하나는 큰 ResNet으로 지도 전이 학습을 하는 Big Transfer(BiT)이고, 다른 하나는 라벨을 뗀 ImageNet과 JFT-300M으로 준지도 학습한 큰 EfficientNet인 Noisy Student입니다. 당시 ImageNet 최고 성능은 Noisy Student, 나머지 데이터셋 최고 성능은 BiT-L이었습니다.
| 데이터셋 | Ours-JFT (ViT-H/14) | Ours-JFT (ViT-L/16) | Ours-I21k (ViT-L/16) | BiT-L (ResNet152x4) | Noisy Student (EfficientNet-L2) |
|---|---|---|---|---|---|
| ImageNet | 88.55 ± 0.04 | 87.76 ± 0.03 | 85.30 ± 0.02 | 87.54 ± 0.02 | 88.4/88.5* |
| ImageNet ReaL | 90.72 ± 0.05 | 90.54 ± 0.03 | 88.62 ± 0.05 | 90.54 | 90.55 |
| CIFAR-10 | 99.50 ± 0.06 | 99.42 ± 0.03 | 99.15 ± 0.03 | 99.37 ± 0.06 | - |
| CIFAR-100 | 94.55 ± 0.04 | 93.90 ± 0.05 | 93.25 ± 0.05 | 93.51 ± 0.08 | - |
| Oxford-IIIT Pets | 97.56 ± 0.03 | 97.32 ± 0.11 | 94.67 ± 0.15 | 96.62 ± 0.23 | - |
| Oxford Flowers-102 | 99.68 ± 0.02 | 99.74 ± 0.00 | 99.61 ± 0.02 | 99.63 ± 0.03 | - |
| VTAB (19 tasks) | 77.63 ± 0.23 | 76.28 ± 0.46 | 72.72 ± 0.21 | 76.29 ± 1.70 | - |
| TPUv3-core-days | 2.5k | 0.68k | 0.23k | 9.9k | 12.3k |
표 2 — 주요 이미지 분류 벤치마크에서 최신 모델과의 비교. 미세조정 3회의 평균 ± 표준편차(%). *는 Touvron et al. (2020)이 보고한 조금 개선된 88.5%.
마지막 행의 TPUv3-core-days는 사전학습에 쓴 TPU v3 코어 수(칩당 2개)에 학습 일수를 곱한 값입니다.
같은 JFT-300M으로 사전학습한 BiT-L과 비교하면, 더 작은 ViT-L/16이 모든 작업에서 앞서면서 사전학습 계산량은 0.68k 대 9.9k입니다. 더 큰 ViT-H/14는 ImageNet, CIFAR-100, VTAB처럼 어려운 데이터셋에서 성능을 더 올리고, 그래도 계산량은 2.5k로 기존 최고 모델들보다 훨씬 적습니다. 저자들은 사전학습 효율이 구조뿐 아니라 학습 일정, 옵티마이저, 가중치 감쇠 같은 다른 설정에도 영향을 받는다고 덧붙이고, 구조별 통제 비교는 8절에서 따로 합니다.
공개 데이터셋인 ImageNet-21k로 사전학습한 ViT-L/16도 대부분의 데이터셋에서 좋은 성능을 냅니다. 이 모델은 코어 8개짜리 표준 클라우드 TPUv3 한 대로 약 30일이면 학습할 수 있는 규모입니다.

그림 2 — VTAB 성능을 Natural, Specialized, Structured 묶음으로 나눈 비교입니다.
위 그림은 VTAB을 세 묶음으로 나눠 기존 최고 방법과 비교합니다. 비교 대상은 BiT, ImageNet과 YouTube로 함께 학습한 ResNet인 VIVI, ImageNet으로 지도 학습과 준지도 학습을 함께 한 S4L입니다. ViT-H/14는 Natural과 Structured 작업에서 BiT-R152x4를 포함한 다른 방법보다 높고, Specialized 작업에서는 상위 두 모델이 비슷합니다.
7. 사전학습 데이터 규모의 영향
ViT는 ResNet보다 비전용 귀납 편향이 적습니다. 그렇다면 데이터셋 크기가 얼마나 결정적인지를 두 실험으로 확인합니다.
실험 1 — 데이터셋 세 가지로 사전학습
ImageNet, ImageNet-21k, JFT-300M 순으로 커지는 데이터셋에 ViT를 사전학습하고 ImageNet으로 미세조정합니다. ImageNet으로 사전학습한 모델도 다시 ImageNet으로 미세조정하는데, 미세조정 단계에서 해상도를 올리면 성능이 오르기 때문입니다. 작은 데이터셋에서 성능을 끌어올리려고 가중치 감쇠, 드롭아웃, 라벨 스무딩 세 가지 정규화 값을 조정했습니다.

그림 3 — 작은 데이터셋에서는 큰 ViT가 BiT ResNet(회색 영역)보다 낮고, 큰 데이터셋에서는 앞섭니다.
위 그림의 가로축은 사전학습 데이터셋, 세로축은 ImageNet 미세조정 정확도입니다. 가장 작은 ImageNet으로 사전학습하면 적당한 정규화를 걸어도 ViT-Large가 ViT-Base보다 낮습니다. ImageNet-21k에서는 둘이 비슷하고, JFT-300M에 와서야 큰 모델의 이점이 온전히 나타납니다. 회색 영역은 여러 크기의 BiT 모델이 차지하는 범위로, ImageNet에서는 BiT가 ViT보다 높지만 데이터셋이 커지면 ViT가 앞섭니다.
아래 표는 그림 3의 수치를 데이터셋별로 옮긴 부록 표 5입니다. 384 해상도로 미세조정했고, 표 2에 쓴 Polyak 평균과 512 해상도는 적용하지 않았습니다.
| 사전학습 | 후속 작업 | ViT-B/16 | ViT-B/32 | ViT-L/16 | ViT-L/32 | ViT-H/14 |
|---|---|---|---|---|---|---|
| ImageNet | CIFAR-10 | 98.13 | 97.77 | 97.86 | 97.94 | - |
| ImageNet | CIFAR-100 | 87.13 | 86.31 | 86.35 | 87.07 | - |
| ImageNet | ImageNet | 77.91 | 73.38 | 76.53 | 71.16 | - |
| ImageNet | ImageNet ReaL | 83.57 | 79.56 | 82.19 | 77.83 | - |
| ImageNet | Oxford Flowers-102 | 89.49 | 85.43 | 89.66 | 86.36 | - |
| ImageNet | Oxford-IIIT-Pets | 93.81 | 92.04 | 93.64 | 91.35 | - |
| ImageNet-21k | CIFAR-10 | 98.95 | 98.79 | 99.16 | 99.13 | 99.27 |
| ImageNet-21k | CIFAR-100 | 91.67 | 91.97 | 93.44 | 93.04 | 93.82 |
| ImageNet-21k | ImageNet | 83.97 | 81.28 | 85.15 | 80.99 | 85.13 |
| ImageNet-21k | ImageNet ReaL | 88.35 | 86.63 | 88.40 | 85.65 | 88.70 |
| ImageNet-21k | Oxford Flowers-102 | 99.38 | 99.11 | 99.61 | 99.19 | 99.51 |
| ImageNet-21k | Oxford-IIIT-Pets | 94.43 | 93.02 | 94.73 | 93.09 | 94.82 |
| JFT-300M | CIFAR-10 | 99.00 | 98.61 | 99.38 | 99.19 | 99.50 |
| JFT-300M | CIFAR-100 | 91.87 | 90.49 | 94.04 | 92.52 | 94.55 |
| JFT-300M | ImageNet | 84.15 | 80.73 | 87.12 | 84.37 | 88.04 |
| JFT-300M | ImageNet ReaL | 88.85 | 86.27 | 89.99 | 88.28 | 90.33 |
| JFT-300M | Oxford Flowers-102 | 99.56 | 99.27 | 99.56 | 99.45 | 99.68 |
| JFT-300M | Oxford-IIIT-Pets | 95.80 | 93.40 | 97.11 | 95.83 | 97.56 |
표 5 — 사전학습 데이터셋별 ViT의 top-1 정확도(%).
ImageNet 사전학습에서 ViT-L/16(76.53)이 ViT-B/16(77.91)보다 낮고, JFT-300M에서는 87.12 대 84.15로 순서가 뒤집힙니다.
실험 2 — JFT-300M 부분집합
두 번째 실험은 정규화 효과를 빼고 모델 자체의 성질을 봅니다. JFT-300M에서 무작위로 뽑은 9M, 30M, 90M 부분집합과 전체 데이터셋으로 학습하되, 작은 부분집합에도 추가 정규화 없이 모든 설정에 같은 하이퍼파라미터를 씁니다. 대신 조기 종료를 쓰고 학습 중 가장 좋은 검증 정확도를 보고합니다. 계산을 아끼려고 미세조정 대신 선형 퓨샷 정확도로 잽니다.
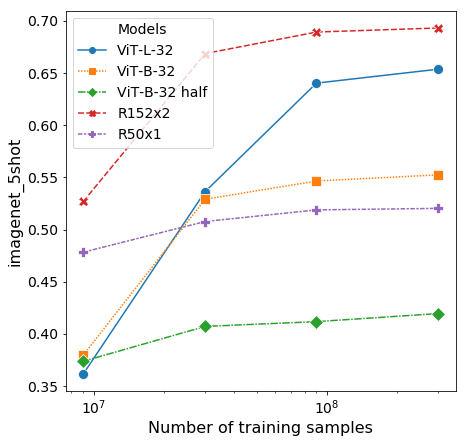
그림 4 — 작은 부분집합에서는 ResNet이 낫지만 더 일찍 포화하고, 큰 부분집합에서는 ViT가 낫습니다. ViT-b는 ViT-B의 모든 은닉 차원을 절반으로 줄인 모델입니다.
위 그림은 부분집합 크기에 따른 ImageNet 5-shot 정확도입니다. 계산 비용이 비슷한 짝끼리 보면, 작은 데이터셋에서 ViT가 ResNet보다 과적합이 심합니다. ViT-B/32는 ResNet50보다 조금 빠른데, 9M 부분집합에서는 훨씬 낮고 90M 이상에서는 더 높습니다. ResNet152x2와 ViT-L/16도 같은 양상입니다.
저자들은 이 결과를 두고, 합성곱의 귀납 편향은 작은 데이터셋에서 유용하지만 큰 데이터셋에서는 데이터로부터 관련 패턴을 직접 배우는 것으로 충분하고 오히려 유리하다고 해석합니다. ImageNet 퓨샷 결과와 표 2의 VTAB 저데이터 결과를 합쳐, 아주 적은 데이터로의 전이도 가능성이 있다고 보고 추가 분석을 향후 과제로 남깁니다.
8. 사전학습 계산량 대비 성능
JFT-300M으로 사전학습한 모델들의 전이 성능을 계산량 기준으로 통제해 비교합니다. 이 설정에서는 데이터 크기가 성능을 제한하지 않으므로, 모델별 사전학습 비용과 성능만 비교할 수 있습니다.
| 모델 묶음 | 7 에폭 사전학습 | 14 에폭 사전학습 |
|---|---|---|
| ResNet 7종 | R50x1, R50x2, R101x1, R152x1, R152x2 | R152x2, R200x3 |
| Vision Transformer 6종 | ViT-B/32, B/16, L/32, L/16 | L/16, H/14 |
| 하이브리드 5종 | R50+ViT-B/32, B/16, L/32, L/16 | R50+ViT-L/16 |

그림 5 — 같은 계산 예산에서 ViT가 대체로 ResNet보다 높고, 작은 크기에서는 하이브리드가 순수 ViT보다 조금 낫지만 큰 모델에서는 차이가 사라집니다.
위 그림의 가로축은 사전학습 총 계산량, 세로축은 전이 정확도입니다. 세 가지 경향이 보입니다.
- ViT와 ResNet — 성능과 계산량의 교환 관계에서 ViT가 ResNet보다 우세합니다. 같은 성능(5개 데이터셋 평균)에 도달하는 데 ViT가 계산량을 약 2–4배 적게 씁니다.
- 하이브리드와 ViT — 계산 예산이 작을 때는 하이브리드가 ViT보다 조금 높지만, 모델이 커지면 차이가 사라집니다. 합성곱의 국소 특징 처리가 모든 크기에서 ViT를 도울 것이라 예상할 수 있어서, 저자들은 이 결과를 다소 의외라고 적습니다.
- 포화 여부 — 시험한 범위 안에서 ViT는 포화하지 않아, 더 키울 여지가 있습니다.
| 모델 | 에폭 | ImageNet | ImageNet ReaL | CIFAR-10 | CIFAR-100 | Pets | Flowers | exaFLOPs |
|---|---|---|---|---|---|---|---|---|
| ViT-B/32 | 7 | 80.73 | 86.27 | 98.61 | 90.49 | 93.40 | 99.27 | 55 |
| ViT-B/16 | 7 | 84.15 | 88.85 | 99.00 | 91.87 | 95.80 | 99.56 | 224 |
| ViT-L/32 | 7 | 84.37 | 88.28 | 99.19 | 92.52 | 95.83 | 99.45 | 196 |
| ViT-L/16 | 7 | 86.30 | 89.43 | 99.38 | 93.46 | 96.81 | 99.66 | 783 |
| ViT-L/16 | 14 | 87.12 | 89.99 | 99.38 | 94.04 | 97.11 | 99.56 | 1567 |
| ViT-H/14 | 14 | 88.08 | 90.36 | 99.50 | 94.71 | 97.11 | 99.71 | 4262 |
| ResNet50x1 | 7 | 77.54 | 84.56 | 97.67 | 86.07 | 91.11 | 94.26 | 50 |
| ResNet50x2 | 7 | 82.12 | 87.94 | 98.29 | 89.20 | 93.43 | 97.02 | 199 |
| ResNet101x1 | 7 | 80.67 | 87.07 | 98.48 | 89.17 | 94.08 | 95.95 | 96 |
| ResNet152x1 | 7 | 81.88 | 87.96 | 98.82 | 90.22 | 94.17 | 96.94 | 141 |
| ResNet152x2 | 7 | 84.97 | 89.69 | 99.06 | 92.05 | 95.37 | 98.62 | 563 |
| ResNet152x2 | 14 | 85.56 | 89.89 | 99.24 | 91.92 | 95.75 | 98.75 | 1126 |
| ResNet200x3 | 14 | 87.22 | 90.15 | 99.34 | 93.53 | 96.32 | 99.04 | 3306 |
| R50x1+ViT-B/32 | 7 | 84.90 | 89.15 | 99.01 | 92.24 | 95.75 | 99.46 | 106 |
| R50x1+ViT-B/16 | 7 | 85.58 | 89.65 | 99.14 | 92.63 | 96.65 | 99.40 | 274 |
| R50x1+ViT-L/32 | 7 | 85.68 | 89.04 | 99.24 | 92.93 | 96.97 | 99.43 | 246 |
| R50x1+ViT-L/16 | 7 | 86.60 | 89.72 | 99.18 | 93.64 | 97.03 | 99.40 | 859 |
| R50x1+ViT-L/16 | 14 | 87.12 | 89.76 | 99.31 | 93.89 | 97.36 | 99.11 | 1668 |
표 6 — 모델 규모 실험의 전이 정확도(%)와 사전학습 계산량(exaFLOPs).
ViT-H/14 행은 표 5의 JFT-300M 열과 값이 다릅니다. 표 5는 ImageNet 88.04, ReaL 90.33, CIFAR-100 94.55, Pets 97.56, Flowers 99.68이고, 표 6은 각각 88.08, 90.36, 94.71, 97.11, 99.71입니다. ViT-L/16(14 에폭) 행은 두 표가 정확히 일치하므로 ViT-H/14만 서로 다른 실행 결과가 실린 것으로 보이며, 논문은 어느 쪽이 맞는지 설명하지 않아 두 값을 모두 논문에 적힌 대로 옮깁니다.
9. ViT 내부 표현 분석
ViT가 이미지를 어떻게 처리하는지 내부 표현을 세 단계로 살펴봅니다. 첫 층의 패치 투영, 투영 뒤에 더하는 위치 임베딩, 층마다 주의가 닿는 거리입니다.

그림 7 왼쪽 — ViT-L/32의 RGB 값 선형 임베딩 필터의 상위 주성분입니다.
ViT의 첫 층은 펼친 패치를 더 낮은 차원으로 선형 투영합니다(2절의 ). 위 그림은 학습된 투영 필터의 상위 주성분을 보여줍니다. 각 성분은 패치 안의 세밀한 구조를 낮은 차원으로 표현하기에 알맞은 기저 함수 모양입니다. 줄무늬, 색 대비, 가장자리 방향처럼 CNN 첫 층 필터에서 흔히 보이는 형태가 나타납니다.

그림 7 가운데 — ViT-L/32 위치 임베딩의 코사인 유사도. 각 칸은 해당 행·열 패치의 위치 임베딩과 다른 모든 패치 위치 임베딩 사이 유사도입니다.
위 그림에서 칸 하나는 패치 위치 하나이고, 칸 안의 작은 격자는 그 위치의 임베딩이 다른 모든 위치의 임베딩과 얼마나 비슷한지를 밝기로 나타냅니다. 모델은 이미지 안의 거리를 위치 임베딩 유사도로 표현하도록 학습합니다. 가까운 패치일수록 위치 임베딩이 비슷합니다. 행과 열 구조도 나타나서, 같은 행이나 같은 열의 패치는 임베딩이 비슷합니다. 격자가 큰 경우에는 사인파 형태가 보이기도 합니다(부록 D).
위치 임베딩은 1차원 번호로 시작했는데도 학습 후에는 2차원 이미지 위상을 표현합니다. 사람이 2차원 구조를 넣어 설계한 위치 임베딩이 개선을 가져오지 못한 이유가 여기서 설명됩니다(10절 표 8).

그림 7 오른쪽 — 층 깊이별 주의 거리. 점 하나는 한 층의 헤드 16개 중 하나의 이미지 평균 주의 거리입니다.
self-attention을 쓰면 가장 낮은 층에서도 이미지 전체의 정보를 모을 수 있습니다. 저자들은 모델이 이 능력을 실제로 쓰는지 확인하려고, 주의 가중치를 기준으로 정보를 모으는 평균 이미지 거리를 계산합니다. 이 주의 거리(attention distance) 는 CNN의 수용 영역(receptive field) 크기에 해당하는 지표입니다.
위 그림의 가로축은 층 깊이, 세로축은 주의 거리입니다. 가장 낮은 층에서도 일부 헤드는 이미 이미지 대부분에 주의를 둡니다. 모델이 전역 정보를 모으는 능력을 실제로 쓴다는 뜻입니다. 다른 헤드는 낮은 층에서 주의 거리가 계속 작습니다. 이렇게 매우 국소적인 주의는 Transformer 앞에 ResNet을 두는 하이브리드 모델에서는 덜 나타나서, 저자들은 이 헤드들이 CNN 앞쪽 합성곱 층과 비슷한 기능을 할 수 있다고 봅니다. 층이 깊어질수록 주의 거리는 늘어납니다.

그림 11 — 예시 이미지 128장에서 질의 픽셀과 다른 모든 픽셀 사이 거리를 주의 가중치로 평균한 값입니다. 이미지 너비는 224픽셀입니다.
부록 D.7은 여러 모델의 주의 거리를 더 자세히 보여줍니다. 낮은 층에서는 헤드마다 평균 주의 거리가 크게 달라, 일부 헤드는 이미지의 많은 부분에, 다른 헤드는 질의 위치나 그 근처의 작은 영역에 주의를 둡니다. 깊이가 늘면 모든 헤드의 주의 거리가 늘어나고, 네트워크 후반부에서는 대부분의 헤드가 토큰 전반에 넓게 주의를 둡니다.

그림 6 — 출력 토큰의 주의를 입력 이미지 위에 표시한 대표 예시입니다.
위 그림은 모델이 분류할 때 이미지의 어느 부분에 주의를 두는지 보여줍니다. 전반적으로 모델은 분류에 의미 있는 영역, 곧 물체 자체에 주의를 둡니다.
주의 지도는 주의 롤아웃(Attention Rollout, Abnar & Zuidema, 2020)으로 계산합니다(부록 D.8). ViT-L/16의 주의 가중치를 모든 헤드에 대해 평균한 뒤 모든 층의 가중치 행렬을 차례로 곱합니다. 이렇게 하면 여러 층을 거치며 토큰끼리 섞이는 주의를 반영할 수 있습니다.

그림 14 — 그림 6과 같은 방식으로 계산한 주의 지도의 무작위 추가 예시입니다.
10. 자기지도 사전학습 예비 실험
자연어 처리에서 Transformer의 성과는 확장성뿐 아니라 대규모 자기지도(self-supervised) 사전학습에서도 나왔습니다. 저자들은 BERT의 마스크 언어 모델링을 흉내 낸 마스크 패치 예측(masked patch prediction) 으로 자기지도 학습을 예비 실험합니다.
| 항목 | 설정 |
|---|---|
| 손상 비율 | 패치 임베딩의 50% |
| 손상 방식 | 학습 가능한 [mask] 임베딩으로 교체 80%, 다른 무작위 패치 임베딩으로 교체 10%, 그대로 유지 10% |
| 예측 목표 | 손상된 패치마다 3비트 평균 색(총 512색) |
| 학습 | JFT, 1M 스텝(약 14 에폭), 배치 4096, Adam, 기본 학습률 , 워밍업 10k 스텝, 코사인 감소 |
예측 목표는 세 가지를 시험했습니다. 평균 3비트 색 하나를 512색 중에서 고르기, 16 × 16 패치를 4 × 4로 줄여 칸 16개의 3비트 색을 동시에 고르기, 전체 패치를 RGB 3채널 256개 회귀로 L2 손실 학습하기입니다. 세 방식 모두 잘 작동했고 L2가 조금 낮았습니다. 퓨샷 성능이 가장 좋았던 첫째 방식의 결과만 보고합니다. BERT처럼 손상 비율 15%도 시험했지만 퓨샷 지표가 조금 낮았습니다.
결과적으로 자기지도 사전학습을 한 ViT-B/16은 ImageNet 79.9%를 냅니다. 처음부터 학습한 경우보다 2% 높고, 지도 사전학습보다는 여전히 4% 낮습니다. 이 방식은 JFT 같은 큰 데이터셋이나 긴 사전학습이 꼭 필요하지 않았습니다. 사전학습 10만 스텝 이후에는 후속 성능 향상이 줄었고, ImageNet으로 사전학습해도 비슷한 향상을 얻었습니다. 대조 학습(contrastive) 사전학습은 향후 과제로 남깁니다.
11. 부록 자료
학습 하이퍼파라미터
| 모델 | 데이터셋 | 에폭 | 기본 학습률 | 학습률 감소 | 가중치 감쇠 | 드롭아웃 |
|---|---|---|---|---|---|---|
| ViT-B/{16,32} | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| ViT-L/32 | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| ViT-L/16 | JFT-300M | 7/14 | linear | 0.1 | 0.0 | |
| ViT-H/14 | JFT-300M | 14 | linear | 0.1 | 0.0 | |
| R50x{1,2} | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| R101x1 | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| R152x{1,2} | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| R50+ViT-B/{16,32} | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| R50+ViT-L/32 | JFT-300M | 7 | linear | 0.1 | 0.0 | |
| R50+ViT-L/16 | JFT-300M | 7/14 | linear | 0.1 | 0.0 | |
| ViT-B/{16,32} | ImageNet-21k | 90 | linear | 0.03 | 0.1 | |
| ViT-L/{16,32} | ImageNet-21k | 30/90 | linear | 0.03 | 0.1 | |
| ViT-∗ | ImageNet | 300 | cosine | 0.3 | 0.1 |
표 3 — 사전학습 하이퍼파라미터. 모든 모델은 배치 4096, 학습률 워밍업 10k 스텝, 해상도 224로 학습합니다. ImageNet에서는 전역 노름 1의 기울기 클리핑을 추가합니다.
ImageNet에서 처음부터 학습할 때는 강한 정규화가 핵심이었습니다. 드롭아웃은 qkv 투영을 제외한 모든 밀집층 뒤와, 위치 임베딩을 패치 임베딩에 더한 직후에 적용합니다. 하이브리드 모델은 대응하는 ViT와 같은 설정으로 학습합니다.
| 데이터셋 | 스텝 | 기본 학습률 |
|---|---|---|
| ImageNet | 20 000 | {0.003, 0.01, 0.03, 0.06} |
| CIFAR100 | 10 000 | {0.001, 0.003, 0.01, 0.03} |
| CIFAR10 | 10 000 | {0.001, 0.003, 0.01, 0.03} |
| Oxford-IIIT Pets | 500 | {0.001, 0.003, 0.01, 0.03} |
| Oxford Flowers-102 | 500 | {0.001, 0.003, 0.01, 0.03} |
| VTAB (19 tasks) | 2 500 | 0.01 |
표 4 — 미세조정 하이퍼파라미터. 코사인 학습률 감소, 배치 512, 가중치 감쇠 없음, 전역 노름 1 기울기 클리핑, 별도 언급이 없으면 해상도 384입니다.
미세조정은 모멘텀 0.9의 SGD로 합니다. 학습률은 학습 세트의 작은 일부(Pets·Flowers 10%, CIFAR 2%, ImageNet 1%)를 개발 세트로 떼어 작은 격자 탐색으로 고르고, 최종 결과는 전체 학습 세트로 다시 학습해 시험 데이터로 평가합니다. VTAB은 모든 작업에 같은 설정(학습률 0.01, 2500 스텝)을 쓰고, 작업별 입력 해상도 대신 모든 작업에 384 × 384를 씁니다.
ResNet 사전학습의 SGD와 Adam 비교
| 데이터셋 | ResNet50 Adam | ResNet50 SGD | ResNet152x2 Adam | ResNet152x2 SGD |
|---|---|---|---|---|
| ImageNet | 77.54 | 78.24 | 84.97 | 84.37 |
| CIFAR10 | 97.67 | 97.46 | 99.06 | 99.07 |
| CIFAR100 | 86.07 | 85.17 | 92.05 | 91.06 |
| Oxford-IIIT Pets | 91.11 | 91.00 | 95.37 | 94.79 |
| Oxford Flowers-102 | 94.26 | 92.06 | 98.62 | 99.32 |
| Average | 89.33 | 88.79 | 94.01 | 93.72 |
표 7 — Adam과 SGD로 사전학습한 ResNet의 미세조정 결과(%).
JFT로 사전학습한 두 ResNet에서 Adam이 대부분의 데이터셋과 평균에서 SGD보다 높아, ResNet에도 Adam을 쓴 근거가 됩니다. 절대 수치가 Kolesnikov et al. (2020)보다 낮은 이유는 30 에폭이 아니라 7 에폭만 사전학습했기 때문입니다.
Transformer 형태 조정


그림 8 — 층 수, 너비, MLP 크기, 패치 크기를 하나씩 바꿨을 때의 5-shot 성능입니다.
모든 설정은 층 8개, , , 패치 크기 32인 ViT에서 출발합니다(모든 선이 만나는 점). 깊이를 늘리는 쪽이 개선 폭이 가장 커서 64층까지 뚜렷하게 오르지만, 16층 이후부터 향상 폭이 줄기 시작합니다. 너비를 늘리는 쪽은 변화가 가장 작습니다. 패치 크기를 줄여 시퀀스를 늘리면 파라미터를 추가하지 않고도 꾸준히 개선됩니다. 저자들은 파라미터 수보다 계산량이 성능을 더 잘 예측할 수 있고, 확장한다면 너비보다 깊이를 우선하는 편이 낫다고 봅니다. 모든 차원을 비례해 키우면 꾸준히 개선됩니다.
분류 헤드와 [class] 토큰

그림 9 — 두 방식 모두 비슷하게 작동하지만 서로 다른 학습률이 필요합니다.
본문 전체는 원래 Transformer에 가깝게 [class] 토큰 출력을 이미지 표현으로 쓰고, 은닉층 하나(tanh 비선형)짜리 MLP로 클래스를 예측합니다. 처음에는 ResNet의 마지막 특징 지도처럼 패치 임베딩만 전역 평균 풀링(Global Average Pooling, GAP)한 뒤 선형 분류기를 붙여 봤는데 성능이 매우 낮았습니다. 원인을 조사해 보니 [class] 토큰이나 GAP 연산 때문이 아니었고, 두 방식이 서로 다른 학습률을 필요로 한다는 것으로 성능 차이가 전부 설명됐습니다.
위치 임베딩 비교
위치 정보를 넣는 방식 네 가지를 비교합니다.
| 방식 | 입력을 보는 관점 | 구현 |
|---|---|---|
| 위치 정보 없음 | 패치 묶음(bag of patches) | 위치 임베딩을 더하지 않음 |
| 1차원 위치 임베딩 | 행 순서로 늘어선 패치열 | 본문 모든 실험의 기본값 |
| 2차원 위치 임베딩 | 2차원 패치 격자 | X축·Y축 임베딩을 각각 크기로 학습해 패치 좌표에 맞춰 이어 붙임 |
| 상대 위치 임베딩 | 패치 사이 상대 거리 | 질의·키 위치 차이마다 임베딩을 두고, 이를 키로 쓰는 추가 주의의 로짓을 원래 주의 로짓에 편향으로 더함 |
1차원과 2차원 위치 임베딩은 넣는 위치도 세 가지로 시험했습니다. 기본값은 입력 처리 직후 부호기에 넣기 전에 한 번 더하는 것(Default/Stem)이고, 나머지는 각 층 시작마다 층별로 학습한 임베딩을 더하는 것(Every Layer)과 층끼리 공유하는 임베딩을 각 층 시작마다 더하는 것(Every Layer-Shared)입니다.
| 위치 임베딩 | Default/Stem | Every Layer | Every Layer-Shared |
|---|---|---|---|
| 없음 | 0.61382 | N/A | N/A |
| 1-D | 0.64206 | 0.63964 | 0.64292 |
| 2-D | 0.64001 | 0.64046 | 0.64022 |
| 상대 위치 | 0.64032 | N/A | N/A |
표 8 — ViT-B/16의 ImageNet 5-shot 선형 평가로 본 위치 임베딩 제거 실험.
위치 임베딩이 없는 모델과 있는 모델 사이에는 차이가 크지만, 위치 정보를 부호화하는 방식끼리는 차이가 거의 없습니다. 저자들은 입력이 픽셀이 아니라 패치 단위라서 공간 차원이 224 × 224가 아닌 14 × 14로 훨씬 작고, 이 해상도에서는 어느 방식이든 공간 관계를 똑같이 쉽게 배운다고 추측합니다.


그림 10 — 서로 다른 하이퍼파라미터로 학습한 모델의 위치 임베딩 유사도입니다.
방식끼리 성능 차이는 거의 없지만, 네트워크가 학습하는 위치 임베딩 유사도의 구체적인 모양은 학습 하이퍼파라미터에 따라 달라집니다.
실제 계산 비용

그림 12 — 왼쪽은 입력 크기별 실측 추론 속도, 오른쪽은 코어 하나에 올라가는 최대 배치 크기입니다.
이론상 FLOPs는 메모리 대역폭이나 캐시 크기 같은 하드웨어 세부 때문에 실제 속도를 잘 예측하지 못하는 경우가 있어, TPUv3에서 주요 모델의 추론 속도를 직접 잽니다. 추론과 역전파 속도의 차이는 모델과 무관한 상수배입니다.
왼쪽 그래프는 입력 크기별로 코어 하나가 초당 처리하는 이미지 수이고, 각 점은 넓은 범위의 배치 크기 중 최고 성능입니다. ViT의 계산량은 이론상 이미지 한 변 길이의 네제곱에 비례하지만, 그 증가는 가장 큰 모델의 가장 큰 해상도에서야 겨우 나타나기 시작합니다. 비슷한 ResNet과 ViT의 속도는 비슷합니다. 오른쪽 그래프는 코어 하나에 올라가는 최대 배치 크기로, 큰 데이터셋으로 확장하려면 클수록 좋습니다. 큰 ViT 모델이 ResNet보다 메모리 효율에서 뚜렷하게 앞섭니다.
축 방향 주의


그림 13 — 축 방향 주의 모델의 ImageNet 5-shot 선형 정확도. 위는 FLOPs, 아래는 추론 속도 기준입니다.
논문의 그림 13 캡션은 FLOPs와 추론 시간을 모두 "left"로 적었지만, 본문 설명대로 FLOPs가 왼쪽, 추론 시간이 오른쪽 그래프입니다.
축 방향 주의는 다차원 텐서 입력을 1차원으로 펼치지 않고, 축마다 따로 주의를 계산하는 기법입니다. 한 번의 주의는 특정 축 방향으로만 정보를 섞고 다른 축 방향 정보는 독립으로 둡니다. 비교 모델은 두 가지입니다. ResNet50의 3 × 3 합성곱을 모두 행·열 축 방향 self-attention(상대 위치 부호화 포함)으로 바꾼 AxialResNet과, ViT가 입력을 2차원 모양으로 처리하게 바꾸고 self-attention + MLP 블록 대신 행 self-attention + MLP 뒤에 열 self-attention + MLP를 두는 Axial-ViT입니다.
JFT로 사전학습하고 ImageNet 5-shot 선형으로 평가하면, Axial-ViT-B/32와 Axial-ViT-B/16은 대응하는 ViT-B보다 성능이 높지만 계산량이 더 듭니다. 전역 self-attention 블록 하나가 행과 열 축 방향 블록 두 개로 바뀌고, 주의 시퀀스는 짧아지지만 블록마다 MLP가 하나 더 붙기 때문입니다. AxialResNet은 정확도 대비 계산량은 적당해 보이지만, 단순 구현이 TPU에서 매우 느립니다.
ObjectNet과 VTAB 세부
대표 모델 ViT-H/14를 ObjectNet 벤치마크에서 평가하면 top-5 정확도 82.1%, top-1 정확도 61.7%입니다.
| VTAB-1k 작업 | ViT-H/14 (JFT) | ViT-L/16 (JFT) | ViT-L/16 (I21k) |
|---|---|---|---|
| Caltech101 | 95.3 | 95.4 | 90.8 |
| CIFAR-100 | 85.5 | 81.9 | 84.1 |
| DTD | 75.2 | 74.3 | 74.1 |
| Flowers102 | 99.7 | 99.7 | 99.3 |
| Pets | 97.2 | 96.7 | 92.7 |
| Sun397 | 65.0 | 63.5 | 61.0 |
| SVHN | 88.9 | 87.4 | 80.9 |
| Camelyon | 83.3 | 83.6 | 82.5 |
| EuroSAT | 96.7 | 96.5 | 95.6 |
| Resisc45 | 91.4 | 89.7 | 85.2 |
| Retinopathy | 76.6 | 77.1 | 75.3 |
| Clevr-Count | 91.7 | 86.4 | 70.3 |
| Clevr-Dist | 63.8 | 63.1 | 56.1 |
| DMLab | 53.1 | 49.7 | 41.9 |
| dSpr-Loc | 79.4 | 74.5 | 74.7 |
| dSpr-Ori | 63.3 | 60.5 | 64.9 |
| KITTI-Dist | 84.5 | 82.2 | 79.9 |
| sNORB-Azim | 33.2 | 36.2 | 30.5 |
| sNORB-Elev | 51.2 | 51.1 | 41.7 |
| Mean | 77.6 | 76.3 | 72.7 |
표 9 — VTAB-1k 작업별 성능(%).
12. 저자가 밝힌 한계
첫째, 실험은 이미지 분류에 한정됩니다. 검출(detection)과 분할(segmentation) 같은 다른 비전 작업에 ViT를 적용하는 것이 과제로 남습니다. 저자들은 Transformer로 물체를 검출한 Carion et al. (2020)의 결과와 함께 볼 때 이 방향이 유망하다고 봅니다.
둘째, 자기지도 사전학습은 처음부터 학습하는 것보다 나았지만, 대규모 지도 사전학습과는 여전히 차이가 큽니다(ImageNet에서 4%).
셋째, 시험한 범위에서 ViT는 포화하지 않았으므로 더 키우면 성능이 오를 가능성이 높습니다. 이는 한계라기보다 남은 과제로 제시됩니다.
13. 정리 — VLA 선행 연구에서의 위치
ViT는 이미지 전용 구조를 새로 만들지 않고, 이미지를 패치 토큰열로 바꿔 자연어 처리의 Transformer에 넣었습니다.
- 패치 분할과 선형 투영 으로 이미지 한 장이 단어 토큰열과 같은 형식의 벡터열이 됩니다.
- [class] 토큰과 학습 가능한 1차원 위치 임베딩 만 더하고, 부호기는 표준 Transformer 그대로 씁니다.
- 귀납 편향이 적은 대신 ImageNet 규모에서는 ResNet보다 낮고, ImageNet-21k와 JFT-300M 규모에서는 ResNet을 앞섭니다. 같은 성능에 드는 사전학습 계산량은 약 2–4배 적습니다.
- 학습된 위치 임베딩과 주의 거리 를 보면, 모델이 2차원 위치 관계와 국소·전역 정보 결합을 데이터에서 직접 배웁니다.
VLA와의 연결
VLA 모델에서 영상 입력을 처리하는 부분은 대부분 ViT 계열입니다. 이미지를 패치 토큰열로 바꾸면 언어 토큰열과 같은 형식이 되므로, 두 토큰열을 이어 붙여 한 Transformer에 넣을 수 있습니다.
| VLA 모델 | 영상 입력 처리 |
|---|---|
| RT-1 | ViT가 아니라 EfficientNet-B3 CNN의 9 × 9 특징 지도를 펼쳐 81개 토큰으로 사용. ViT 논문의 1 × 1 패치 하이브리드와 같은 방식 |
| RT-2-PaLI-X | ViT-22B 시각 부호기 |
| RT-2-PaLM-E | ViT-4B 시각 부호기 |
| OpenVLA | SigLIP과 DINOv2 두 ViT 부호기의 패치 특징을 이어 붙여 Llama 2에 입력 |
| π0 | PaliGemma의 SigLIP ViT 부호기 |
RT-2 이후 모델의 시각 부호기는 ViT를 이미지만으로 학습하지 않고 이미지와 텍스트를 함께 학습합니다. SigLIP은 그 방식 중 하나이며, 출발점은 4편 CLIP입니다.
전체 목록은 VLA 선행 연구 목차에서 볼 수 있습니다.