들어가며
OpenVLA 논문해석은 공개 시각-언어 모델(Vision-Language Model, VLM)을 로봇 데이터로 미세조정해 행동을 출력하는 방법을 누구나 재현할 수 있게 만들었습니다. OpenVLA는 RT-2와 같이 행동 한 차원을 256개 구간 가운데 하나로 바꾸고, 그 구간 번호를 텍스트 토큰처럼 하나씩 차례로 생성합니다. 이 방식은 VLM의 출력 방식을 그대로 쓸 수 있다는 장점이 있지만, 행동 하나를 내려면 토큰 7개를 순서대로 만들어야 하고 구간 폭보다 정밀한 값은 표현하지 못합니다. 초당 50번 명령을 보내며 옷을 개는 양팔 로봇에는 맞지 않는 조건입니다.
π0(파이 제로)는 행동 출력 방식을 바꿉니다. VLM이 이미지와 지시를 읽는 부분은 그대로 두고, 로봇 상태와 행동만 처리하는 작은 가중치 묶음인 행동 전문가(action expert) 를 같은 Transformer 안에 추가했습니다. 행동 전문가는 앞으로 50걸음의 연속 행동을 한꺼번에, flow matching으로 생성합니다. 이 모델을 로봇 7종에서 모은 약 1만 시간의 시연과 공개 데이터로 사전학습한 뒤, 빨래 개기·식탁 치우기·상자 조립처럼 5분에서 20분 걸리는 과제에 맞게 사후학습합니다.
📄 π0: A Vision-Language-Action Flow Model for General Robot Control — Kevin Black, Noah Brown, Danny Driess 외 (저자 24명, 알파벳순) / Physical Intelligence, 2024-10 공개 (v4 2026-01)
프로젝트 페이지는 physicalintelligence.company/blog/pi0이고, arxiv 식별자는 2410.24164입니다. 이 글은 v4를 기준으로 합니다.
초록 요약
로봇 학습이 실제 환경에서 쓸 만큼 범용적이 되려면 데이터, 일반화, 강건성에서 큰 장애물을 넘어야 합니다. 저자들은 여러 로봇과 과제의 데이터로 학습한 범용 로봇 정책, 곧 로봇 기반 모델(robot foundation model)이 이 문제를 풀 수 있다고 보고, 복잡하고 정교한 조작 과제에 맞는 정책을 설계합니다.
모델은 인터넷 규모로 사전학습한 VLM에 flow matching 구조를 더해, VLM이 가진 의미 지식을 물려받습니다. 한 팔 로봇, 양팔 로봇, 이동형 조작기를 포함한 여러 로봇의 크고 다양한 데이터로 학습합니다. 평가는 세 방향으로 합니다. 지시만 주고 바로 과제를 시키는 경우, 사람이나 상위 VLM 정책이 주는 언어 명령을 따르는 경우, 미세조정으로 새 기술을 익히는 경우입니다. 빨래 개기, 식탁 치우기, 상자 조립 같은 과제를 다룹니다.

그림 1 — 사전학습 VLM과 여러 로봇의 데이터로 학습하고, 행동 전문가가 flow matching으로 연속 행동을 냅니다.
그림 1은 π0의 구성을 한 장에 담았습니다. 사전학습된 VLM을 몸체 여러 종의 정교한 조작 데이터로 학습하고, 연속 행동을 flow matching으로 만드는 별도의 행동 전문가를 붙입니다. 학습된 모델은 지시만으로 바로 쓰거나, 품질이 높은 데이터로 미세조정해 옷 여러 벌 개기나 상자 조립 같은 다단계 과제에 씁니다.
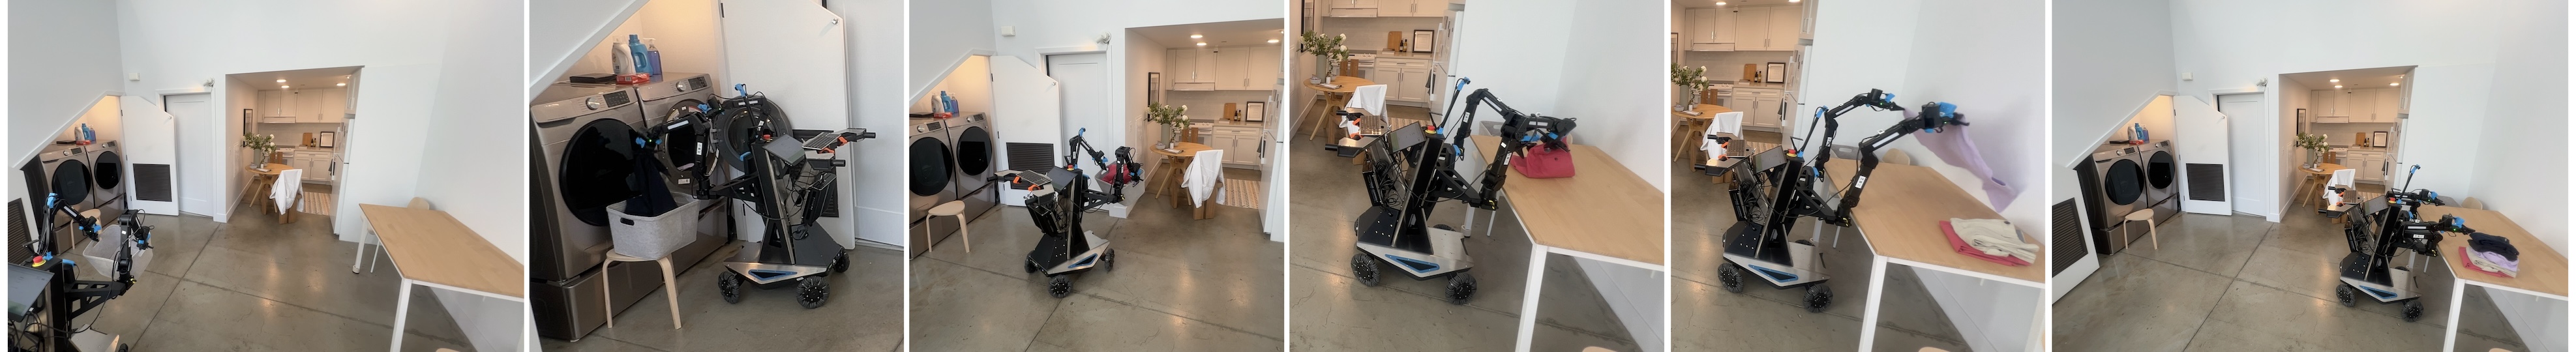
그림 2 — 건조기에서 빨래를 꺼내 바구니에 담고, 접이 탁자로 옮겨 한 벌씩 개는 π0 정책입니다.
그림 2의 정책은 로봇 구성 7종·과제 68개의 데이터로 사전학습한 모델을 빨래 과제에 미세조정한 것입니다. 건조기에서 빨래를 꺼내 바구니에 담고, 바구니를 탁자로 가져가 옷을 한 벌씩 갭니다.
1. 문제 — 범용 로봇 정책의 세 가지 조건
범용 모델을 먼저 학습하는 이유
자연어 처리와 컴퓨터 비전에서는 여러 과제가 섞인 큰 데이터로 사전학습한 범용 모델이 좁은 과제 전용 모델보다 대체로 성능이 좋습니다. 사진에서 새를 알아보는 모델을 만들 때도, 새 사진만으로 학습하기보다 다양한 이미지-텍스트 쌍으로 사전학습한 뒤 새 인식에 맞게 미세조정하는 편이 효과적입니다.
저자들은 로봇에도 같은 방식이 통한다고 봅니다. 다양한 로봇 데이터로 먼저 학습하면 다른 과제, 다른 로봇, 로봇 외 출처의 데이터까지 쓸 수 있어 데이터 부족 문제가 줄어듭니다. 다양한 데이터에는 좁은 데이터에 없는 장면, 실수를 고치는 동작, 실패에서 회복하는 동작이 들어 있으므로 일반화와 강건성도 좋아집니다.
세 가지 조건
저자들은 이런 범용 로봇 정책을 만드는 데 필요한 조건을 셋으로 정리합니다.
| 조건 | 내용 | π0의 대응 |
|---|---|---|
| 규모 | 대규모 사전학습의 이점은 작은 규모에서는 잘 나타나지 않음 | 약 1만 시간의 자체 시연 + 공개 데이터 |
| 모델 구조 | 다양한 데이터를 흡수하면서 섬세한 연속 동작을 표현해야 함 | VLM + flow matching 행동 전문가 |
| 학습 방법 | 사전학습·사후학습 데이터 구성이 성능을 좌우함 | 다양한 데이터로 사전학습 → 품질 높은 데이터로 사후학습 |
저자들은 세 번째 조건을 가장 중요하다고 적습니다. 대형 언어 모델도 사전학습과 사후학습 데이터를 어떻게 고르느냐에 크게 의존했기 때문입니다.
기존 방법과의 비교
| 방법 | 대표 모델 | 사전학습 VLM | 행동 출력 | 행동 묶음 |
|---|---|---|---|---|
| 자기회귀 이산화 VLA | RT-2, OpenVLA | 사용 | 차원별 구간 토큰을 하나씩 생성 | 지원 안 함 |
| 확산 기반 정책 | Diffusion Policy, Octo | 사용 안 함 | 확산 모델로 연속 행동 생성 | 지원 |
| π0 | — | PaliGemma | flow matching으로 연속 행동 생성 | 50걸음 |
π0는 VLM을 쓴다는 점에서는 RT-2·OpenVLA와 같고, 연속 행동 묶음을 생성 모델로 만든다는 점에서는 Diffusion Policy와 같습니다. 행동 묶음(action chunking)은 ACT에서 가져왔고, 최대 50Hz 제어가 가능합니다. 저자들은 모델 구조뿐 아니라 사전학습 데이터 구성, 사전학습·사후학습 단계, 실제 로봇 실험까지 묶은 틀 전체를 이 논문의 기여로 봅니다.
2. 전체 구조

그림 3 — 사전학습 데이터 혼합으로 VLM 백본과 행동 전문가를 학습하고, 여러 로봇을 제어합니다.
그림 3은 학습 흐름입니다. 자체 수집한 정교한 조작 데이터와 공개 데이터를 섞은 사전학습 혼합으로 flow matching VLA를 학습합니다. 모델은 PaliGemma로 초기화한 큰 VLM 백본(backbone)과, 로봇 상태·행동을 처리하는 작은 행동 전문가로 이루어집니다. 학습된 π0는 행동 공간이 서로 다른 여러 로봇을 제어합니다.
이미지와 언어는 VLM 백본 가중치가, 로봇 상태와 잡음 섞인 행동은 행동 전문가 가중치가 처리합니다. 두 가중치 묶음은 한 Transformer 안에 있고, 자기 주의(self-attention) 층에서만 서로의 정보를 봅니다. 행동 전문가가 낸 속도를 따라 잡음을 10번 조금씩 옮기면 행동 묶음 하나가 완성됩니다. 아래에서 입력, 행동 전문가, 주의 마스크, 학습, 추론 순서로 설명합니다.
3. 모델 입력 — 관측과 행동 묶음
관측의 구성
π0가 모델링하는 분포는 입니다. 는 시점 의 관측이고, 는 그 시점부터 앞으로 걸음의 행동을 모은 행동 묶음(action chunk) 입니다.
| 기호 | 내용 | 모양 |
|---|---|---|
| 번째 카메라 이미지 | 로봇마다 2장 또는 3장 | |
| 언어 지시를 토큰으로 자른 열 | 지시 길이만큼의 토큰 | |
| 로봇의 관절 각도 벡터(자기수용 상태, proprioceptive state) | 18차원 | |
| 한 시점의 행동 벡터 | 18차원 | |
| 행동 묶음 | 50 × 18 |
이미지와 상태는 각자의 부호기를 거친 뒤 선형 투영으로 언어 토큰과 같은 임베딩 공간에 들어갑니다. 이미지 부호기가 카메라 이미지를 언어 토큰과 같은 공간에 넣는 방식은 LLaVA 같은 표준 VLM과 같습니다.
논문은 "토큰"이라는 말을 넓게 씁니다. 언어 토큰 같은 이산 값뿐 아니라 이미지 조각이나 로봇 행동 같은 연속 값도, Transformer의 시퀀스에서 한 칸을 차지하면 토큰이라고 부릅니다. 행동 묶음의 50걸음 하나하나가 행동 토큰 하나입니다.
서로 다른 로봇을 한 모양에 맞추는 방법
로봇마다 관절 수가 다릅니다. UR5e 한 팔은 7차원, 양팔 로봇은 14차원, 전방향 이동 베이스를 단 양팔 로봇은 행동이 17차원입니다. π0는 모든 로봇의 상태 벡터와 행동 벡터를 데이터셋에서 가장 큰 로봇의 차원인 18차원에 맞춥니다. 18차원은 6자유도 팔 두 개, 집게 두 개, 이동 베이스, 위아래로 움직이는 몸통을 담는 크기입니다. 차원이 작은 로봇은 남는 칸을 0으로 채웁니다. 카메라가 3개보다 적은 로봇은 빈 이미지 칸을 가려서 모델이 보지 않게 합니다.
| 칸 번호 | 1–7 | 8–14 | 15–18 |
|---|---|---|---|
| UR5e 한 팔 (7차원) | 실제 값 | 0 | 0 |
| 양팔 로봇 (14차원) | 실제 값 | 실제 값 | 0 |
7차원·14차원 로봇의 18차원 채우기 예시입니다. 칸 배치는 설명을 위해 임의로 정한 것이고, 논문은 칸 순서를 적지 않았습니다.
4. 행동 전문가
두 가중치 묶음을 가진 하나의 Transformer
π0의 구조는 Transfusion에서 출발합니다. Transfusion은 Transformer 하나를 여러 목적 함수로 학습하는데, 연속 값을 내는 토큰은 flow matching 손실로, 이산 값을 내는 토큰은 교차 엔트로피 손실로 학습합니다. 저자들은 여기에 더해 로봇 전용 토큰(상태와 행동)에 별도의 가중치 를 쓰면 성능이 좋아진다는 것을 발견했습니다.
그 결과가 전문가 두 개짜리 혼합 전문가(mixture of experts) 구조입니다. 토큰마다 두 가중치 묶음 가운데 하나로 보내집니다.
| 토큰 | 보내지는 가중치 | 초기화 |
|---|---|---|
| 이미지 | VLM 백본 | PaliGemma 사전학습 가중치 |
| 언어 지시 | VLM 백본 | PaliGemma 사전학습 가중치 |
| 로봇 상태 | 행동 전문가 | 무작위 |
| 잡음 섞인 행동 | 행동 전문가 | 무작위 |
VLM 사전학습 때 본 적 있는 입력(이미지·언어)은 PaliGemma 가중치가 맡고, 본 적 없는 입력(상태·행동)은 새 가중치가 맡습니다. 층마다 두 묶음은 각자의 순방향 신경망과 투영 행렬을 쓰고, 자기 주의 연산에서만 한 시퀀스로 합쳐져 서로의 키와 값을 봅니다.
크기
PaliGemma는 공개된 3B 파라미터 VLM이고, 언어 모델 부분은 Gemma 2B입니다. 행동 전문가는 층 수와 헤드 구성은 Gemma와 같게 두고, 폭과 순방향 신경망 크기만 줄였습니다. 두 전문가는 자기 주의 층에서만 만나므로 폭이 달라도 됩니다.
| 설정 | VLM 백본 (Gemma 2B) | 행동 전문가 |
|---|---|---|
| 폭(width) | 2048 | 1024 |
| 깊이(depth) | 18 | 18 |
| 순방향 신경망 크기(mlp_dim) | 16,384 | 4096 |
| 헤드 수 | 18 | 18 |
| 키·값 헤드 수 | 1 (다중 질의 주의) | 1 |
| 헤드 차원 | 256 | 256 |
| 파라미터 | 약 3B (PaliGemma 전체) | 약 300M |
행동 전문가의 깊이·헤드 설정은 논문이 "폭과 mlp_dim만 줄였다"고 적은 데서 따른 것입니다.
행동 전문가는 추론할 때 10번 실행되므로, 크기를 줄이면 추론 시간이 그만큼 줄어듭니다. 전체 파라미터는 3.3B입니다.
flow matching 시각의 입력
잡음 섞인 행동 는 행동 전문가에 들어가기 전에, 지금이 flow matching의 어느 시각 인지와 함께 임베딩됩니다.
| 기호 | 크기 | 역할 |
|---|---|---|
| = 18 | 잡음 섞인 행동 한 걸음 | |
| = 1024 × 18 | 행동을 폭 로 올림 | |
| = 1024 | 를 사인 함수 위치 부호화로 바꾼 벡터 | |
| concat | 2048 | 두 벡터를 이어 붙임 |
| = 1024 × 2048 | 두 정보를 섞음 | |
| = 1024 × 1024 | 최종 임베딩 |
는 Transformer 논문의 위치 부호화와 같은 사인 함수 부호화입니다. 같은 행동 값이라도 (잡음이 대부분)일 때와 (거의 완성)일 때 다른 임베딩이 되므로, 모델은 지금 얼마나 잡음을 걷어내야 하는지 알 수 있습니다. 출력 쪽은 50개 행동 토큰 위치의 Transformer 출력만 선형 투영해 속도 로 씁니다.
5. 블록 단위 인과 주의 마스크
세 블록
π0는 입력 시퀀스를 세 블록으로 나누고 블록 사이의 주의 방향을 제한합니다.
| 블록 | 토큰 | 담당 가중치 |
|---|---|---|
| 1 | 이미지 + 언어 | VLM 백본 |
| 2 | 로봇 상태 | 행동 전문가 |
| 3 | 잡음 섞인 행동 50개 | 행동 전문가 |
블록 안에서는 모든 토큰이 서로를 봅니다(양방향 주의). 블록 사이에서는 뒤 블록이 앞 블록을 볼 수 있지만, 앞 블록은 뒤 블록을 보지 못합니다.
마스크 예시
아래 표는 이미지 토큰 2개, 언어 토큰 2개, 상태 토큰 1개, 행동 토큰 3개로 줄인 시퀀스의 마스크입니다. 행이 질의(보는 쪽), 열이 키(보이는 쪽)이고, ○는 주의 가능, ×는 차단입니다.
| 질의 ↓ / 키 → | 이미지1 | 이미지2 | 언어1 | 언어2 | 상태 | 행동1 | 행동2 | 행동3 |
|---|---|---|---|---|---|---|---|---|
| 이미지1 | ○ | ○ | ○ | ○ | × | × | × | × |
| 이미지2 | ○ | ○ | ○ | ○ | × | × | × | × |
| 언어1 | ○ | ○ | ○ | ○ | × | × | × | × |
| 언어2 | ○ | ○ | ○ | ○ | × | × | × | × |
| 상태 | ○ | ○ | ○ | ○ | ○ | × | × | × |
| 행동1 | ○ | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 행동2 | ○ | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 행동3 | ○ | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
토큰 개수는 모양을 보여 주기 위한 임의의 예시 값입니다. 실제 행동 토큰은 50개입니다.
블록을 나눈 이유
- 블록 1이 뒤를 보지 못하는 이유 — 이미지와 언어 토큰은 PaliGemma가 사전학습 때 본 입력입니다. 여기에 새 입력(상태·행동)이 섞이면 사전학습 때와 다른 계산이 되므로, 사전학습 분포와의 차이를 줄이려고 뒤 블록을 보지 못하게 했습니다.
- 상태가 따로 블록인 이유 — 로봇 상태는 flow matching 적분 10걸음 동안 바뀌지 않습니다. 상태 토큰이 행동 블록을 보지 않게 하면 상태의 키와 값이 10걸음 내내 같으므로, 한 번 계산해 저장(캐시)해 둘 수 있습니다.
- 행동 블록 안이 양방향인 이유 — 행동 50개가 서로를 모두 보므로, 50걸음을 한꺼번에 일관된 궤적으로 만듭니다. 언어 모델처럼 앞 걸음부터 차례로 생성하지 않습니다.
6. flow matching 학습
손실 함수
행동 토큰은 조건부 flow matching(conditional flow matching) 손실로 학습합니다. 아래 첨자는 로봇 시점, 위 첨자는 flow matching 시각 입니다.
경로는 선형 가우시안 경로 입니다. 고해상도 이미지와 동영상 생성에서 이 단순한 경로가 좋은 성능을 냈다는 선행 연구를 따랐습니다. 실제 학습 한 걸음은 네 단계입니다.
- 데이터에서 관측 와 정답 행동 묶음 를 뽑습니다.
- 같은 모양(50 × 18)의 표준 정규 잡음 과 시각 를 뽑습니다.
- 잡음 섞인 행동 을 만듭니다.
- 모델 출력 가 정답 속도 에 가까워지도록 제곱 오차를 줄입니다.
이면 순수한 잡음, 이면 정답 행동입니다. DDPM은 가 클수록 잡음이 많지만 π0의 는 반대로 클수록 정답에 가깝습니다.
1차원 계산 예시
행동 한 차원만 떼어 계산해 봅니다.
| 항목 | 값 |
|---|---|
| 정답 행동 | 0.6 |
| 뽑은 잡음 | −1.0 |
| 뽑은 시각 | 0.3 |
| 잡음 섞인 행동 | −0.52 |
| 정답 속도 | 1.6 |
정답 행동·잡음·시각은 설명을 위한 임의의 예시 값이고, 나머지는 그 값으로 계산한 값입니다.
모델은 입력으로 −0.52와 , 그리고 이미지·지시·상태를 받아 1.6을 내도록 학습합니다. 정답 속도 1.6은 와 상관없이 잡음 −1.0에서 정답 0.6까지의 직선 방향입니다. 모델은 잡음이 무엇이었는지 모르므로, 같은 −0.52가 여러 정답·잡음 조합에서 나올 수 있다는 점까지 포함해 평균적인 속도를 배웁니다. 이 평균 속도를 따라가면 데이터 분포의 행동이 나온다는 것이 Flow Matching 논문의 결과입니다.
학습 시각 분포
원래 flow matching 논문은 를 0과 1 사이에서 균등하게 뽑습니다. 이미지 생성 연구 일부는 중간 시각을 더 자주 뽑는 분포를 씁니다. 잡음이 거의 없는 시각에서는 입력을 그대로 내면 되고, 잡음뿐인 시각에서는 데이터 평균만 맞히면 되므로 중간 시각이 학습하기 가장 어렵다는 이유입니다.
저자들은 로봇 행동이 이 가정과 다르다고 봅니다. 텍스트 라벨이 주어졌을 때 평균 이미지를 맞히기는 쉽지만, 로봇 관측이 주어졌을 때 평균 행동 를 맞히기는 어렵습니다. 관측은 텍스트 라벨보다 훨씬 많은 정보를 담고 있어 가능한 행동의 범위를 좁게 제한하기 때문입니다. 그래서 잡음이 많은 시각(작은 )을 더 자주 뽑는 분포를 설계했습니다.

그림 14 — 잡음이 많은 작은 τ를 더 자주 뽑고, 차단값 s보다 큰 τ는 뽑지 않습니다.
Beta(1.5, 1)의 밀도는 입니다. 아래 표는 를 넣어 시각별 밀도를 계산한 값입니다.
| 0 | 0.25 | 0.5 | 0.75 | 0.9 | 0.99 | 0.999 | |
|---|---|---|---|---|---|---|---|
| 밀도 | 1.500 | 1.299 | 1.060 | 0.749 | 0.472 | 0.142 | 0 |
논문의 식으로 계산한 값입니다.
같은 식으로 누적 확률을 구하면 인 표본이 약 64.7%, 인 표본이 약 35.1%입니다. 균등 분포라면 각각 50%, 25%입니다. 보다 큰 를 뽑지 않는 이유는 적분 간격 가 보다 크면 그 구간이 쓰이지 않기 때문입니다. 면 , 곧 적분을 최대 1000걸음까지 할 수 있습니다.
7. 추론
오일러 적분 10걸음
추론은 잡음 에서 시작해, 학습한 속도를 에서 까지 적분합니다. 적분은 전진 오일러 방법입니다.
실험에서는 10걸음, 곧 을 씁니다. 아래 표는 앞의 1차원 예시에서 모델이 매 걸음 정답 속도 1.6을 정확히 낸다고 가정한 계산입니다.
| 걸음 | 현재 값 | 속도 | 다음 값 | |
|---|---|---|---|---|
| 1 | 0.0 | −1.00 | 1.6 | −0.84 |
| 2 | 0.1 | −0.84 | 1.6 | −0.68 |
| 5 | 0.4 | −0.36 | 1.6 | −0.20 |
| 10 | 0.9 | 0.44 | 1.6 | 0.60 |
정답 0.6·잡음 −1.0은 임의의 예시 값이고, 속도는 모델이 정답 속도를 정확히 맞혔다고 가정한 값입니다.
선형 경로에서는 속도가 일정하므로 10걸음이면 정확히 0.6에 도착합니다. 실제 모델의 속도는 걸음마다 조금씩 달라지지만, 경로가 직선에 가까울수록 적은 걸음으로도 정확해집니다.
키·값 캐시
행동 묶음 하나를 만들 때 필요한 계산은 네 가지입니다.
- 이미지 부호기로 카메라 이미지를 부호화합니다.
- 관측 (이미지·언어·상태) 토큰으로 순방향 계산을 한 번 합니다.
- 행동 토큰 50개로 순방향 계산을 합니다.
- 3번을 적분 걸음마다, 모두 10번 반복합니다.
주의 마스크 덕분에 관측 토큰은 행동 토큰을 보지 않으므로, 2번에서 계산한 관측 토큰의 키와 값을 저장해 두고 10걸음 동안 다시 씁니다. 반복 계산은 행동 전문가가 처리하는 50개 토큰뿐입니다.
| 모델 부분 | 추론 시간 |
|---|---|
| 이미지 부호기 | 14 ms |
| 관측 순방향 계산 | 32 ms |
| 행동 순방향 계산 × 10 (flow) | 27 ms |
| 네트워크 지연 (로봇 밖에서 추론할 때) | 13 ms |
| 로봇 안 추론 합계 | 73 ms |
| 로봇 밖 추론 합계 | 86 ms |
표 I — 카메라 이미지 3장 기준, NVIDIA GeForce RTX 4090에서 잰 추론 시간입니다.
행동 순방향 계산 10번이 27 ms로, 관측 순방향 계산 한 번(32 ms)보다 짧습니다. 행동 전문가를 작게 만든 효과입니다. 이동형 로봇은 Wi-Fi로 연결된 외부 컴퓨터에서 추론해 네트워크 지연이 더해집니다.
행동 묶음의 실행
모델이 50걸음을 한꺼번에 내므로, 다시 추론하기 전까지 최대 50걸음을 실행할 수 있습니다. 실제로는 그보다 자주 추론합니다.
| 로봇 | 제어 주기 | 한 묶음에서 실행하는 걸음 | 추론 간격 |
|---|---|---|---|
| UR5e, Franka | 20Hz | 16 | 0.8초 |
| 나머지 로봇 | 50Hz | 25 | 0.5초 |
ACT의 시간 앙상블(겹치는 예측을 가중 평균하는 방법)도 초기에 시도했지만 정책 성능이 떨어져, 여러 추론 결과를 합치지 않고 행동 묶음을 개루프로 실행합니다.
8. 학습 데이터와 학습 단계
사전학습 혼합
학습 예시 하나는 한 시점의 쌍이므로, 데이터 양은 시점(timestep) 수로 셉니다.
| 구분 | 규모 |
|---|---|
| 공개 데이터 (OXE, Bridge v2, DROID) | 학습 혼합의 9.1% |
| 자체 데이터 전체 | 903M 시점 |
| 한 팔 로봇 | 106M 시점 |
| 양팔 로봇 | 797M 시점 |
| 자체 데이터 과제 수 | 68개 |
| 자체 데이터 로봇 구성 | 7종 |
논문은 이 데이터를 약 1만 시간이라고 적습니다. 공개 데이터의 로봇은 대개 카메라 한두 대에 2~10Hz의 낮은 제어 주기를 쓰지만, 물체와 환경이 매우 다양합니다.
π0의 "과제"는 기존 연구보다 넓은 단위입니다. 기존 연구는 "pick up the cup"과 "pick up the plate"를 서로 다른 과제로 셌지만, π0의 "식탁 치우기(bussing)" 과제 하나에는 여러 종류의 접시·컵·식기를 통에 넣고 쓰레기를 휴지통에 버리는 동작이 모두 들어갑니다. 그래서 과제 수 68보다 실제 행동의 폭이 훨씬 넓습니다.
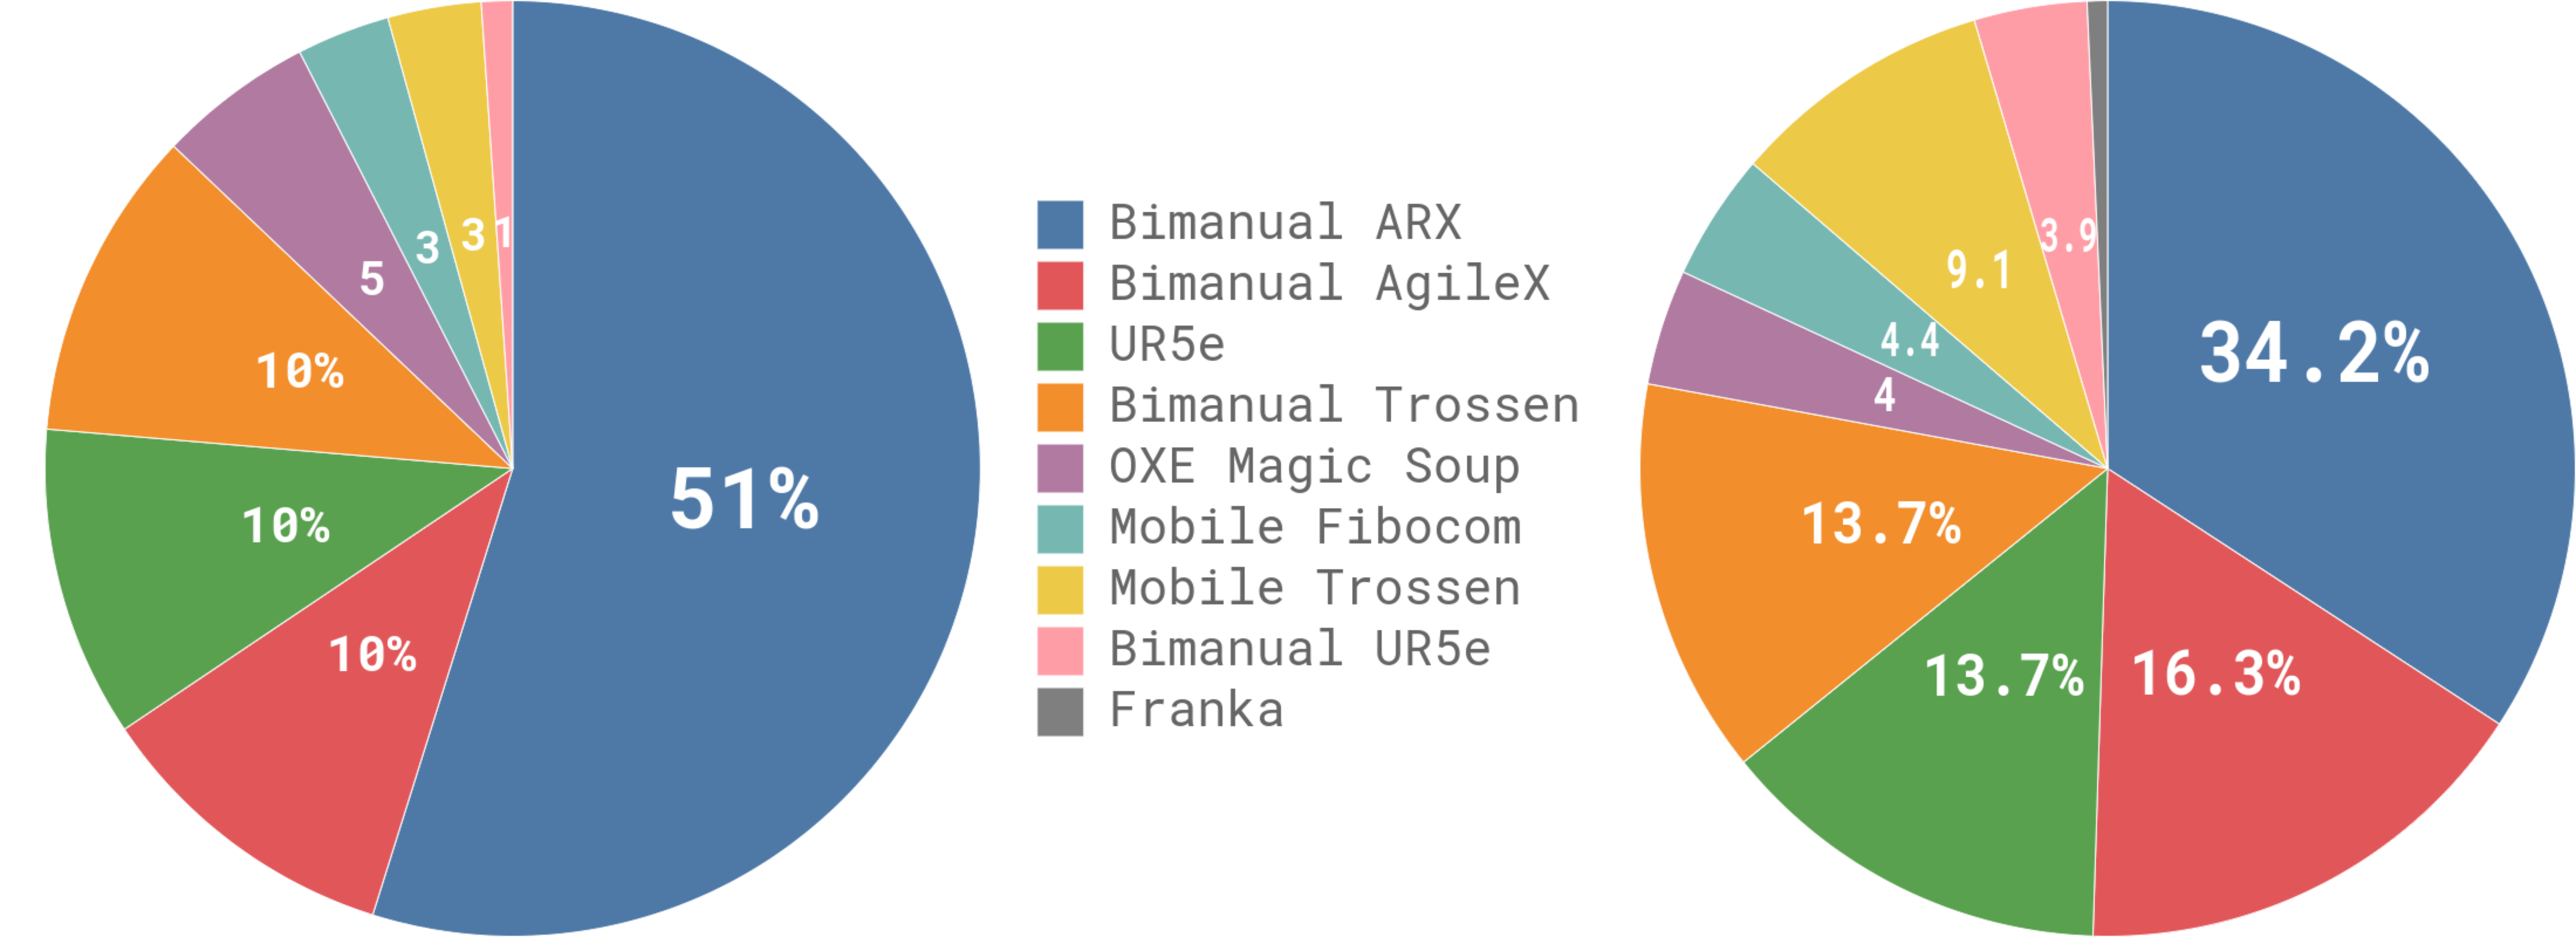
그림 4 — 왼쪽은 데이터셋별 시점 수 비율, 오른쪽은 사전학습 혼합에서의 가중치입니다.
| 데이터 | 시점 수 비율 (왼쪽) | 혼합 가중치 (오른쪽) |
|---|---|---|
| Bimanual ARX | 51% | 34.2% |
| Bimanual AgileX | 10% | 16.3% |
| UR5e | 10% | 13.7% |
| Bimanual Trossen | 10% | 13.7% |
| OXE Magic Soup | 5 | 4 |
| Mobile Fibocom | 3 | 4.4 |
| Mobile Trossen | 3 | 9.1 |
| Bimanual UR5e | 1 | 3.9 |
| Franka | 표기 없음 | 표기 없음 |
그림 4의 원그래프에 적힌 값을 옮겼습니다. 작은 조각은 원그래프에 % 기호 없이 숫자만 적혀 있습니다.
과제·로봇 조합의 가중치
데이터 크기가 고르지 않아, 어려운 빨래 개기 과제처럼 데이터가 많은 조합이 혼합을 차지하게 됩니다. 이를 줄이려고 과제-로봇 조합마다 표본 수 에 대해 의 가중치를 줍니다.
| 조합의 표본 수 | 100,000 | 1,000,000 | 10,000,000 |
|---|---|---|---|
| 가중치 | 141.3 | 380.2 | 1023.3 |
표본 수는 임의의 예시 값이고, 가중치는 계산한 값입니다.
표본 수가 100배 차이 나는 두 조합의 가중치 차이는 약 7.24배로 줄어듭니다. 데이터가 많은 조합도 여전히 더 많이 뽑히지만, 데이터 양에 비례해서 뽑히지는 않습니다.
로봇 구성

그림 5 — 6자유도·7자유도 팔을 단 한 팔·양팔 조작기와, 전방향·비전방향 이동형 조작기입니다.
| 구성 | 팔 | 카메라 | 상태 차원 | 행동 차원 |
|---|---|---|---|---|
| UR5e | UR5e 한 팔, 평행 집게 | 손목 1 + 어깨 너머 1 = 2 | 7 | 7 |
| Bimanual UR5e | UR5e 두 팔 | 3 | 14 | 14 |
| Franka | Franka 한 팔 | 2 | 8 | 8 |
| Bimanual Trossen | 6자유도 Trossen ViperX 두 팔 (ALOHA 기반) | 손목 2 + 베이스 1 = 3 | 14 | 14 |
| Bimanual ARX · Bimanual AgileX | 6자유도 ARX 또는 AgileX 두 팔 | 손목 2 + 베이스 1 = 3 | 14 | 14 |
| Mobile Trossen · Mobile ARX | Mobile ALOHA 기반, 6자유도 두 팔 + 비전방향 베이스 | 손목 2 + 베이스 1 = 3 | 14 | 16 |
| Mobile Fibocom | 6자유도 ARX 두 팔 + 전방향 베이스 | 논문에 적히지 않음 | 14 | 17 |
두 줄은 기구학적 성질이 비슷한 두 플랫폼을 한 구성으로 묶었으므로, 표의 줄은 7개입니다. 비전방향 베이스는 행동 2차원을, 전방향 베이스는 이동 2차원과 회전 1차원을 더합니다.
사전학습과 사후학습
두 단계는 데이터에 요구하는 성질이 다릅니다.
| 단계 | 목표 | 데이터 요구 | 규모 |
|---|---|---|---|
| 사전학습(pre-training) | 넓게 쓸 수 있는 물리적 능력 | 과제를 최대한 많이, 과제 안에서도 다양한 행동 | 위 혼합 전체 |
| 사후학습(post-training) | 특정 과제를 능숙하고 유창하게 실행 | 일관되고 유창한 전략을 담은 데이터 | 과제에 따라 5시간 ~ 100시간 이상 |
저자들은 두 데이터가 서로 다른 역할을 한다고 설명합니다. 품질 높은 데이터만으로 학습하면 실수 장면이 거의 없어 실수에서 회복하는 법을 배우지 못합니다. 품질 낮은 사전학습 데이터만으로 학습하면 효율적이고 강건하게 움직이는 법을 배우지 못합니다. 둘을 함께 쓰면 모델은 되도록 품질 높은 데이터처럼 움직이고, 실수했을 때는 사전학습에서 본 회복 동작을 씁니다.
사전학습에는 과제 이름과 함께 약 2초 길이의 구간마다 붙인 세부 라벨(segment annotation)도 언어 지시로 씁니다.
상위 정책
식탁 치우기처럼 의미 추론과 전략이 필요한 과제는 "bus the table" 같은 큰 과제를 "pick up the napkin", "throw the napkin into the trash" 같은 하위 과제로 나누는 상위 정책의 도움을 받을 수 있습니다. π0는 언어 지시를 입력으로 받으므로, 상위 VLM이 하위 과제 문장을 만들어 π0에 넘기면 됩니다. SayCan 같은 LLM·VLM 계획 방법과 같은 방식입니다.
9. 실험 1 — 사전학습 직후 기본 모델 평가
과제
사후학습 없이 사전학습만 마친 모델에 언어 지시만 주고 다섯 과제를 시킵니다.

그림 6 — 셔츠 개기, 쉬운 식탁 치우기, 어려운 식탁 치우기, 장바구니 담기, 토스터에서 토스트 꺼내기입니다.
| 과제 | 로봇 | 내용 | 점수 기준 |
|---|---|---|---|
| 셔츠 개기 | Bimanual ARX | 펼쳐 놓은 티셔츠 개기 | 성공/실패. 소매를 접고 길이 방향으로 반 접으면 성공. 티셔츠 5벌 × 2회, 최대 15000걸음(약 5분) |
| 쉬운 식탁 치우기 | UR5e | 쓰레기는 휴지통, 식기는 식기 통에 | 물체 7개, 맞게 넣은 물체당 1점 |
| 어려운 식탁 치우기 | UR5e | 물체가 더 많고, 쓰레기 위에 식기를 올려 두는 등 배치가 까다로움. 사전학습에 없는 물체 포함 | 물체 12개, 물체당 1점 |
| 장바구니 담기 | UR5e | 감자칩·마시멜로·고양이 사료 등을 봉투에 | 물건 7개, 담은 물건당 1점 |
| 토스트 꺼내기 | Bimanual Trossen | 토스터에서 토스트 꺼내 접시에 | 토스트 2장 × (꺼내기 1점 + 접시에 놓기 1점) = 4점 |
점수는 과제별 만점으로 나눈 정규화 점수를 에피소드 10회에 걸쳐 평균합니다. 완전히 성공하면 1.0, 일부만 하면 비율만큼 받습니다.
비교 모델
| 모델 | 파라미터 | 학습 데이터 | 학습 걸음 |
|---|---|---|---|
| π0 | 3.3B | 전체 혼합 | 700k |
| π0 (계산량 맞춤, parity) | 3.3B | 전체 혼합 | 160k |
| π0-small | 470M | 전체 혼합 | 논문에 적히지 않음 |
| OpenVLA | 7B | 전체 혼합 | 160k |
| OpenVLA (UR5e 전용) | 7B | UR5e 데이터만 | 논문에 적히지 않음 |
| Octo | 93M | 전체 혼합 | 320k |
시간 제약으로 OpenVLA와 Octo를 π0만큼 오래 학습하지 못해, 기준선보다 걸음 수가 같거나 적은 160k 걸음 버전의 π0를 함께 비교합니다. OpenVLA는 행동 묶음과 고주파 제어를 지원하지 않아 이 혼합이 매우 어렵다고 저자들은 적습니다. UR5e 데이터만으로 미세조정한 OpenVLA는 UR5e 과제에서 더 강한 기준선이 되도록 추가했습니다. Octo는 VLA가 아니지만 확산 과정으로 행동을 생성하므로 flow matching VLA와 비교할 대상이 됩니다.
결과

그림 7 — 모든 과제에서 계산량을 맞춘 π0도 모든 기준선보다 높고, 전체 학습한 π0가 가장 높습니다.
| 과제 | π0 | π0 (parity) | π0-small | OpenVLA | OpenVLA (UR5e) | Octo |
|---|---|---|---|---|---|---|
| 셔츠 개기 | 약 1.0 | 약 0.9 | 약 0.5 | 약 0 | — | 약 0 |
| 쉬운 식탁 치우기 | 약 0.97 | 약 0.81 | 약 0.44 | 약 0 | 약 0.34 | 약 0.05 |
| 어려운 식탁 치우기 | 약 0.88 | 약 0.5 | 약 0.33 | 약 0 | — | 약 0 |
| 장바구니 담기 | 약 0.79 | 약 0.34 | 약 0.27 | 약 0 | — | 약 0 |
| 토스트 꺼내기 | 약 0.75 | 약 0.4 | 약 0 | 약 0 | — | 약 0 |
논문은 막대그래프만 싣고 수치를 적지 않았으므로, 그림 7에서 읽은 대략값입니다. UR5e 전용 OpenVLA는 UR5e 과제 가운데 쉬운 식탁 치우기에서만 막대가 보입니다.
π0는 셔츠 개기와 쉬운 식탁 치우기에서 거의 완벽한 점수를 냈습니다. 160k 걸음만 학습한 π0도 모든 기준선보다 높고, VLM 초기화가 없는 π0-small도 OpenVLA와 Octo보다 높습니다.
- OpenVLA — 자기회귀 이산화 구조가 행동 묶음을 지원하지 않아 이 과제들에서 실패합니다. UR5e 전용 OpenVLA는 조금 낫지만 π0에 크게 못 미칩니다.
- Octo — 행동 묶음은 지원하지만 표현 용량이 제한적입니다.
- π0-small과의 비교 — VLM 사전학습의 중요성을 보여 주지만, 공정한 비교는 어렵습니다. π0-small은 파라미터가 적은데, 사전학습 없이 큰 모델을 학습하기도 어렵기 때문입니다.
10. 실험 2 — 언어 명령 따르기
과제와 조건
기본 π0를 언어 명령 평가 영역에 미세조정한 뒤, VLM 초기화가 없는 π0-small과 비교합니다. 실험 1에서 가장 강한 기준선이 π0-small이었기 때문입니다. 이 비교로 VLM 사전학습이 언어 명령 이해를 얼마나 돕는지 봅니다. 다만 π0-small은 모델 크기도 작아, 크기 차이의 영향을 따로 떼어 낼 수는 없다고 저자들은 밝힙니다.

그림 8 — 위부터 식탁 치우기, 식탁 차리기, 장바구니 담기입니다.
| 과제 | 내용 | 물체 수 | 에피소드당 명령 수 |
|---|---|---|---|
| 식탁 치우기 | 식기는 통에, 쓰레기는 휴지통에 | 12 | 약 30 |
| 식탁 차리기 | 통에서 매트·접시·식기·냅킨·컵을 꺼내 차리고 언어 지시대로 조정 | 7 | 약 20 |
| 장바구니 담기 | 커피콩·보리·마시멜로·고양이 사료·스파게티·김·아몬드를 종이봉투에 | 7 | 약 14 |
명령은 집을 물체와 놓을 자리를 말하는 약 2초 길이 구간 단위이고, 과제 하나에 이런 구간이 여러 개 이어집니다. 점수는 물체를 제자리에 옮겼는지와 명령을 따랐는지로 매깁니다.
| 조건 | 받는 명령 |
|---|---|
| -flat | 전체 과제 설명 한 문장만 ("bag the groceries") |
| -human | 전문가인 사람이 주는 중간 명령 (어떤 물체를 어디에) |
| -HL | 상위 VLM 정책이 주는 중간 명령 (사람 개입 없이 자율) |
결과

그림 9 — 왼쪽은 언어 명령을 따른 비율, 오른쪽은 조건별 과제 점수입니다.
| 과제 | 명령 따른 비율 π0-small | 명령 따른 비율 π0 |
|---|---|---|
| 식탁 치우기 | 약 0.70 | 약 0.94 |
| 장바구니 담기 | 약 0.31 | 약 0.70 |
| 식탁 차리기 | 약 0.31 | 약 0.90 |
| 과제 | π0-small-flat | π0-small-human | π0-flat | π0-human | π0-HL |
|---|---|---|---|---|---|
| 식탁 치우기 | 약 0.64 | 약 0.71 | 약 0.92 | 약 0.97 | 약 0.95 |
| 장바구니 담기 | 약 0.34 | 약 0.15 | 약 0.75 | 약 0.87 | 약 0.72 |
| 식탁 차리기 | 약 0.17 | 약 0.11 | 약 0.38 | 약 0.72 | 약 0.84 |
논문은 수치를 적지 않았으므로 그림 9에서 읽은 대략값입니다. 과제당 10회 평균입니다.
π0는 세 과제 모두에서 π0-small보다 명령을 훨씬 잘 따릅니다. 저자들은 이 차이를 더 큰 사전학습 VLM 초기화의 효과로 봅니다. 명령을 잘 따르는 능력은 중간 명령이 주어졌을 때의 과제 점수로 이어집니다. π0는 사람의 중간 명령(-human)으로 점수가 크게 오르고, 상위 VLM 정책(-HL)으로도 올라갑니다. 반면 π0-small은 명령을 따르는 능력이 부족해, 중간 명령을 받아도 전체적으로 점수가 오르지 않습니다.
11. 실험 3 — 새로운 정교한 과제 학습
과제와 난이도
사전학습 데이터와 크게 다른 새 과제에, 과제마다 데이터 양을 바꿔 미세조정합니다. 과제는 사전학습 과제와 얼마나 다른지에 따라 난이도를 나눕니다.

그림 10 — 사전학습과 비슷한 과제부터, 새 물체와 새 동작이 필요한 과제까지입니다.
| 과제 | 로봇 | 사전학습과의 관계 | 난이도 | 점수 기준 |
|---|---|---|---|---|
| 그릇 쌓기 | UR5e | 식탁 치우기처럼 식기를 집어 옮김. 평가에 처음 보는 그릇 포함 | 쉬움 | 3점: 작은 그릇 2개를 큰 그릇에 쌓기 각 1점 + 정돈 1점 |
| 수건 개기 | Bi-ARX | 사전학습의 셔츠 개기와 비슷함 | 쉬움 | 3점: 첫 반 접기 1점 + 두 번째 반 접기 1점 + 정돈 1점 |
| 전자레인지에 반찬통 넣기 | Bi-ARX | 통 다루기는 비슷하지만 전자레인지는 사전학습에 없음. 평가에 처음 보는 통 포함 | 중간 | 4점: 문 열기·통 집기·넣기·문 닫기 각 1점 |
| 종이 타월 교체 | Bi-UR5e | 사전학습에 비슷한 물체가 없음 | 어려움 | 4점: 헌 심 잡기·빼기·새 롤 잡기·거치대에 끼우기 각 1점 |
| 서랍에 물건 넣기 | Franka | 사전학습에 Franka로 하는 비슷한 과제가 없음 | 어려움 | 5점: 서랍 열기 1점 + 물건 3개 넣기 각 1점 + 닫기 1점 |
비교 방법
| 방법 | 출발점 | 미세조정 데이터 |
|---|---|---|
| π0 | 사전학습한 π0 | 과제별 1·5·10시간 |
| π0 (scratch) | π0 구조, 로봇 데이터 사전학습 없음 | 같음 |
| OpenVLA | 공개 저장본 (OXE로 사전학습) | 한 가지 데이터 양만 |
| Octo | 공개 저장본 (OXE로 사전학습) | 한 가지 데이터 양만 |
| ACT | 처음부터 학습 | 과제별 데이터만 |
| Diffusion Policy (DP) | 처음부터 학습 | 과제별 데이터만 |
π0와 π0 (scratch)를 비교하면 로봇 사전학습의 효과를, π0 (scratch)와 다른 방법을 비교하면 VLM 초기화를 포함한 구조의 효과를 볼 수 있습니다. OpenVLA와 Octo는 성능이 크게 낮아, 실제 로봇 평가에 드는 시간 때문에 데이터 양 한 가지로만 평가했습니다. 모든 기준선은 그릇 쌓기와 반찬통 과제에만 넣었습니다.
결과

그림 11 — 쉬운 과제는 적은 데이터로도 배우고, 사전학습 모델이 처음부터 학습한 모델보다 높은 경우가 많습니다.
| 과제 | 데이터 | π0 | π0 (scratch) | DP | ACT | OpenVLA | Octo |
|---|---|---|---|---|---|---|---|
| 전체 평균 | 1시간 | 약 0.57 | 약 0.38 | 약 0.20 | — | — | — |
| 5시간 | 약 0.86 | 약 0.79 | 약 0.32 | — | — | — | |
| 10시간 | 약 0.87 | 약 0.76 | 약 0.38 | — | — | — | |
| 그릇 쌓기 | 1시간 | 약 0.90 | 약 0.73 | 약 0.13 | 약 0.30 | — | — |
| 5시간 | 약 1.0 | 약 0.87 | 약 0.57 | 약 0.47 | 약 0.13 | 약 0.08 | |
| 10시간 | 약 1.0 | 약 0.93 | 약 0.60 | 약 0.90 | — | — | |
| 수건 개기 | 1시간 | 약 0.15 | 약 0 | 약 0 | — | — | — |
| 5시간 | 약 1.0 | 약 0.80 | 약 0.10 | — | — | — | |
| 10시간 | 약 0.95 | 약 0.60 | 약 0.30 | — | — | — | |
| 반찬통 넣기 | 1시간 | 약 0.88 | 약 0.68 | 약 0.65 | 약 0.53 | — | — |
| 5시간 | 약 0.58 | 약 0.75 | 약 0.62 | 약 0.62 | 약 0.07 | 약 0 | |
| 10시간 | 약 0.75 | 약 0.78 | 약 0.68 | 약 0.73 | — | — | |
| 종이 타월 교체 | 1시간 | 약 0.82 | 약 0.37 | 약 0.22 | — | — | — |
| 5시간 | 약 0.80 | 약 0.57 | 약 0.32 | — | — | — | |
| 10시간 | 약 0.70 | 약 0.57 | 약 0.30 | — | — | — | |
| 서랍에 물건 넣기 | 1시간 | 약 0.10 | 약 0.14 | 약 0 | — | — | — |
| 5시간 | 약 0.94 | 약 0.94 | 약 0 | — | — | — | |
| 10시간 | 약 0.94 | 약 0.92 | 약 0.06 | — | — | — |
논문은 수치를 적지 않았으므로 그림 11에서 읽은 대략값입니다. "—"는 그 조건을 평가하지 않은 칸입니다. 과제당 10회 평균입니다.
π0는 대체로 다른 방법보다 높습니다. 기존 방법 가운데서는 목표 과제 데이터로 처음부터 학습한 ACT와 Diffusion Policy가 가장 강했습니다. OXE로 사전학습한 OpenVLA와 Octo는 이 과제들에서 사전학습의 이점을 거의 살리지 못했습니다. 반찬통 과제에서 5시간 데이터로 학습한 π0는 기준선과 비슷했지만, 1시간 버전은 기준선보다 확실히 높았습니다.
사전학습의 효과는 사전학습 데이터와 비슷한 과제에서 더 크게 나타났고, 사전학습 모델이 처음부터 학습한 모델보다 최대 2배 높은 경우도 있었습니다. 다만 그림을 보면 서랍에 물건 넣기처럼 두 π0의 곡선이 거의 겹치는 과제도 있습니다.
12. 실험 4 — 복잡한 다단계 과제
과제
미세조정과 언어를 함께 써서 여러 단계가 이어지는 어려운 과제를 시킵니다. 과제 하나를 끝내는 데 5분에서 20분이 걸리고, 일부는 상위 정책의 안내가 필요합니다.

그림 12 — (a) 고정 로봇 빨래 개기 (b) 이동 로봇 빨래 개기 (c) 식탁 치우기 (d) 상자 조립 (e) 달걀 담기 (f) 음식 포장입니다.
| 과제 | 로봇 | 사전학습에 있음 | 내용 | 점수 기준 |
|---|---|---|---|---|
| 빨래 개기 | Bi-ARX (고정) | 있음 | 통 안에 구겨진 옷을 꺼내 개고, 앞서 갠 옷 위에 쌓기 | 4점: 꺼내 탁자에 놓기·펴기·개기·모서리에 두거나 쌓기 각 1점. 셔츠 3벌 + 반바지 2벌 × 2회 |
| 이동 빨래 개기 | Mobile Fibocom | 있음 | 방향과 위치를 제어하며 빨래 개기 | 빨래 개기와 같음 |
| 건조기 비우기 | Mobile Fibocom | 있음 | 바구니를 들고 건조기로 가서 옷을 바구니에 옮기기 | 5점: 접근·바구니 올려놓기·문 열기·옷 모두 담기·문 닫기 각 1점 |
| 식탁 치우기 | UR5e | 없음 | 처음 보는 물체가 빽빽한 식탁 정리. 큰 접시는 집게를 비틀어 집고, 쓰레기 묻은 접시는 들어서 쓰레기를 털고 통에 넣음 | 물체 12개, 물체당 1점 |
| 상자 조립 | Bi-Trossen | 없음 | 납작한 상자를 접어 조립. 한쪽을 누르며 다른 쪽을 접고, 탁자 면도 받침으로 씀 | 5점: 상자 집기·반 접기·오른쪽 날개·왼쪽 날개·가운데 정돈 각 1점 |
| 음식 포장 | Bi-AgileX | 없음 | 접시의 음식을 포장 용기에 넣고 양팔로 닫기 | 5점: 접시 집기 1점 + 음식 3개 넣기 각 1점 + 닫기 1점 |
| 달걀 담기 | Bi-Trossen | 없음 | 그릇의 달걀 6개를 달걀판에 넣고 양팔로 닫기 | 7점: 달걀당 1점 + 달걀판 닫기 1점 |
이 과제들은 다른 방법으로는 풀지 못해, π0의 학습 조건끼리 비교합니다.
| 조건 | 사전학습 | 미세조정 |
|---|---|---|
| π0 (fine-tuned) | 함 | 함 |
| π0 (out-of-box) | 함 | 안 함 |
| π0 (scratch) | 안 함 | 함 |
결과

그림 13 — 위는 사전학습에 있던 과제, 아래는 사전학습에 없던 과제의 10회 평균 점수입니다.
| 과제 | π0 (fine-tuned) | π0 (scratch) | π0 (out-of-box) |
|---|---|---|---|
| 빨래 개기 | 약 0.83 | 약 0.22 | 약 0.30 |
| 식탁 치우기 | 약 0.88 | 약 0.71 | 약 0.48 |
| 이동 빨래 개기 | 약 0.93 | 약 0.32 | 약 0.55 |
| 건조기 비우기 | 약 0.72 | 약 0.38 | 약 0.16 |
| 상자 조립 | 약 0.64 | 약 0.32 | 약 0 |
| 음식 포장 | 약 0.70 | 약 0.46 | 약 0 |
| 달걀 담기 | 약 0.84 | 약 0.88 | 약 0 |
논문은 수치를 적지 않았으므로 그림 13에서 읽은 대략값입니다. 그림 13 위쪽 그래프는 식탁 치우기를 "사전학습에 있던 과제" 묶음에 넣었지만, 본문 과제 설명은 이 과제가 사전학습에 없다고 적습니다.
사전학습과 미세조정을 모두 한 π0는 모든 과제에서 최대 점수의 50%를 넘었습니다. 사전학습에 없던 세 과제는 사전학습만 한 모델로는 점수가 0에 가깝지만, 사전학습 후 미세조정하면 처음부터 학습한 모델보다 대체로 높습니다. 저자들은 어려운 과제일수록 사전학습 모델의 개선 폭이 크다고 해석합니다. 과제마다 절대 점수가 다른 것은 과제 난이도와 사전학습에 비슷한 데이터가 얼마나 있었는지의 차이로 봅니다.
본문은 "전체 사전학습·미세조정 방법이 모든 과제에서 가장 좋았다"고 적지만, 그림 13의 달걀 담기에서는 처음부터 학습한 모델의 막대가 조금 더 높습니다. 그림 캡션은 "대체로(typically) 앞선다"고 적어 그림과 맞습니다.
13. 비교 모델 π0-small의 구조
VLM 사전학습의 효과를 보려고 만든 π0-small(약 470M 파라미터)은 VLM 백본 없이 처음부터 학습해도 큰 데이터셋에 맞출 수 있게 설계했습니다.
| 항목 | π0 | π0-small |
|---|---|---|
| 언어 지시 부호화 | Gemma 언어 모델 백본 | DistilBERT |
| 행동 전문가와 관측의 연결 | 혼합 전문가 구조, 한 시퀀스에서 자기 주의 | 관측 부호기 출력에 교차 주의 (부호기-복호기 구조) |
| 이미지 부호기 | PaliGemma 부호기 | 더 작은 사전학습 ViT (R26-S-32 ResNet-ViT 혼합) |
| 이미지 부호기 가중치 공유 | 논문에 적히지 않음 | 카메라마다 따로 |
| 관측 Transformer 사전학습 | 인터넷 데이터로 사전학습 | 안 함 |
| 행동 전문가 구조 | Gemma 구조 | DiT 구조, AdaLN-Zero 층으로 입력 |
| 공통점 | 사전학습 ViT 이미지 부호기, 관측 부호기와 행동 전문가의 가중치 분리, 같은 관측 형식, flow matching 10걸음 | 같음 |
14. 저자가 밝힌 한계
첫째, 사전학습 데이터를 어떻게 구성해야 하는지 아직 충분히 알지 못합니다. 쓸 수 있는 데이터를 모두 합쳤지만, 어떤 종류의 데이터를 추가하면 더 도움이 되는지, 가중치를 어떻게 줘야 하는지는 풀리지 않은 문제입니다.
둘째, 평가한 과제가 모두 안정적으로 동작하지는 않고, 거의 완벽한 성능에 필요한 데이터의 양과 종류를 미리 예측하는 방법도 없습니다.
셋째, 매우 다른 데이터, 특히 다른 과제와 다른 로봇의 데이터를 합쳤을 때 긍정적 전이가 얼마나 일어나는지 아직 모릅니다. 결과는 범용 사전학습 로봇 기반 모델이 가능하다는 쪽을 가리키지만, 자율 주행·내비게이션·다리 보행처럼 훨씬 다른 영역까지 확장되는지는 앞으로의 연구로 남깁니다.
저자들은 대형 언어 모델에서 지식 대부분이 사전학습에서 얻어지고 사후학습은 그 지식을 사용자 지시에 맞게 쓰는 방법을 알려 준다는 관찰이, 로봇 기반 모델에서도 비슷하게 나타날 수 있다고 봅니다. 사전학습 모델은 추가 학습 없이도 어느 정도 과제를 하지만, 빨래 개기 같은 복잡한 과제는 품질 높은 데이터로 미세조정해야 합니다. 품질 높은 데이터로만 학습한 모델은 실수에서 회복하지 못하고, 사전학습 모델만 쓰면 사후학습 데이터에 담긴 유창한 전략이 나오지 않습니다.
15. 논문 안에서 맞지 않는 곳
| 위치 | 내용 | 이 글의 처리 |
|---|---|---|
| 3절 개요 vs 그림 4·5-A절 | 개요는 OXE 데이터셋 "전체(entire)"를 쓴다고 적고, 그림 4 캡션과 5-A절은 OXE의 일부인 OXE Magic Soup을 쓴다고 적습니다. | 그림 4의 표기(OXE Magic Soup)를 따르고 두 표현을 함께 적습니다. |
| 5-A절 vs 그림 4 | 본문은 공개 데이터(OXE·Bridge v2·DROID)가 학습 혼합의 9.1%라고 적지만, 그림 4의 혼합 가중치 원그래프에서 OXE Magic Soup은 4이고 9.1은 Mobile Trossen 조각에 적혀 있습니다. 논문만으로는 어느 쪽이 맞는지 알 수 없습니다. | 두 값을 모두 적습니다(8절). |
| 6-D절 vs 그림 13 | 본문은 전체 방법이 "모든 과제에서(across the board)" 가장 좋다고 적지만, 그림 13의 달걀 담기에서는 처음부터 학습한 모델이 조금 더 높습니다. | 그림과 캡션("typically")을 따릅니다(12절). |
| 6-D절 vs 그림 13 | 본문은 식탁 치우기가 사전학습에 없는 과제라고 적지만, 그림 13은 이 과제를 "사전학습에 있던 과제" 그래프에 넣었습니다. | 두 표기를 함께 적습니다(12절). |
자체 데이터 903M 시점과 "약 1만 시간"은 로봇별 제어 주기(20Hz 또는 50Hz)에 따라 환산이 달라집니다. 모든 시점이 50Hz라면 약 5,017시간, 모두 20Hz라면 약 12,542시간이므로 1만 시간은 이 범위 안에 있습니다. 논문이 로봇별 시점 수를 적지 않아 정확한 환산은 할 수 없습니다.
16. 정리 — 계보에서의 위치
- VLM + 행동 전문가 — PaliGemma(3B)에 로봇 상태·행동 토큰 전용 가중치 약 300M을 더한 3.3B 모델입니다. 두 가중치 묶음은 자기 주의 층에서만 연결됩니다.
- flow matching 행동 묶음 — 50걸음 × 18차원의 연속 행동을 선형 경로 flow matching으로 학습하고, 오일러 방법 10걸음으로 생성합니다. 잡음이 많은 시각을 더 자주 뽑는 베타 분포로 학습합니다.
- 블록 단위 인과 마스크 — 이미지·언어 블록은 사전학습 분포를 지키려고 뒤 블록을 보지 않고, 상태 블록은 캐시할 수 있도록 행동 블록을 보지 않습니다. RTX 4090에서 행동 묶음 하나에 73 ms가 걸립니다.
- 데이터와 학습 단계 — 로봇 구성 7종·과제 68개·903M 시점의 자체 데이터와 공개 데이터로 사전학습하고, 과제별로 5시간에서 100시간 이상의 품질 높은 데이터로 사후학습합니다.
- 결과 — 사전학습 직후 평가에서 OpenVLA·Octo보다 크게 높았고, 새 과제 미세조정에서 ACT·Diffusion Policy보다 대체로 높았으며, 빨래 개기·상자 조립 같은 긴 과제에서 최대 점수의 50%를 넘었습니다.
OpenVLA와의 비교
| 항목 | OpenVLA | π0 |
|---|---|---|
| 파라미터 | 7B | 3.3B (VLM 3B + 행동 전문가 300M) |
| 기본 VLM | Prismatic-7B (SigLIP + DINOv2 → Llama 2) | PaliGemma (Gemma 2B) |
| 입력 | 이미지 1장 + 언어 | 이미지 2~3장 + 언어 + 로봇 상태 |
| 행동 표현 | 차원별 256구간 토큰 | 연속 값 |
| 생성 방식 | 토큰을 하나씩 자기회귀 생성 | flow matching, 오일러 10걸음 |
| 한 번에 내는 행동 | 1걸음 | 50걸음 |
| 행동 차원 | 7 | 18 (작은 로봇은 0으로 채움) |
| 로봇 데이터 | OXE 97만 개 궤적 | 자체 903M 시점(약 1만 시간) + OXE Magic Soup·Bridge v2·DROID |
| 학습 단계 | 사전학습 → 필요하면 미세조정 | 사전학습 → 과제별 사후학습 |
| 최대 제어 주기 | RTX 4090에서 약 6Hz | 50Hz (0.5초마다 추론, 25걸음 실행) |
π0가 행동을 연속 값으로 바꾸면서 새로 생긴 질문도 있습니다. 토큰으로 행동을 내는 방식이 느리고 거친 이유가 토큰 방식 자체인지, 아니면 차원별 구간 나누기라는 토큰화 방법 때문인지입니다. 다음 편 FAST는 행동을 주파수 성분으로 압축하는 토크나이저로 이 질문을 다룹니다. 사전학습에 없던 집 안 환경에서의 일반화는 이후 π0.5가 다룹니다.
전체 목록은 VLA 계보 목차에서 볼 수 있습니다.