부품 세 개
앞에서는 VLA 를 "카메라 + 언어 → 행동" 으로만 봤습니다. 이 편에서는 그 내부 구조를 설명합니다. 대부분의 최신 VLA 는 세 부품의 조립입니다.
- VLM(Vision-Language Model) — 보고 알아듣는 부분. 인터넷 규모로 사전학습한 언어·비전 모델입니다.
- action head — 행동을 생성하는 부분. 요즘은 대개 Diffusion Transformer(DiT) 나 action expert 라 불리는 작은 transformer 입니다.
- embodiment adapter — 로봇 몸에 맞추는 부분. 작은 MLP 입니다.
모델마다 이 셋을 어떻게 잇는지가 다를 뿐입니다.
System 2 와 System 1 — 이해와 행동의 분리
최신 VLA 는 느리게 이해하는 부분과 빠르게 행동하는 부분, 두 시스템으로 나뉩니다. System 2 = VLM 은 카메라 영상과 "빨간 컵을 왼쪽에 놓아라" 는 말을 이해하는 부분입니다. 느리게, 낮은 빈도로 돕니다. System 1 = action head 는 그 이해를 받아 실제 관절 명령을 빠르게 생성하는 부분입니다. 사람이 "무엇을 할지 판단" 과 "손을 정확히 움직이기" 를 나눠 처리하는 것과 같습니다.
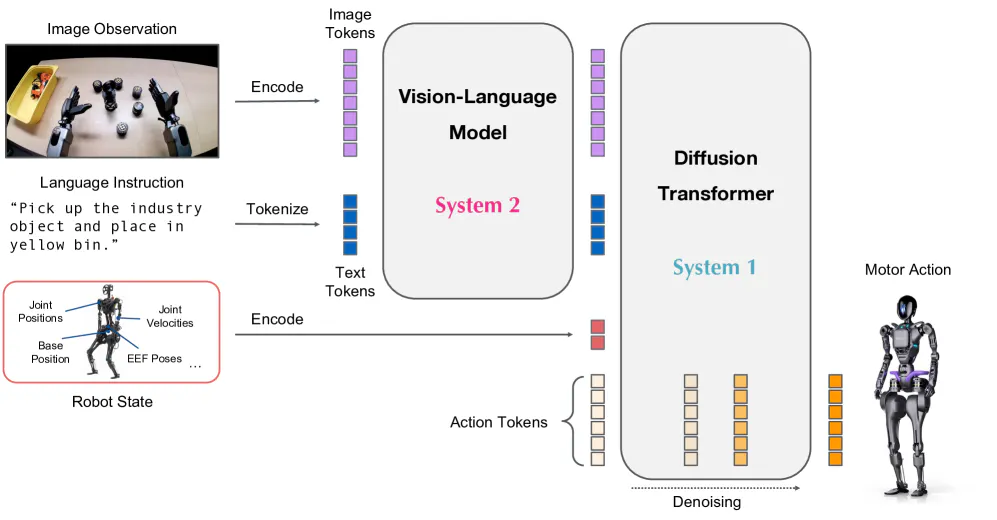
출처: NVIDIA Isaac GR00T N1, arXiv:2503.14734 Fig. 2 · CC BY 4.0
GR00T 의 조립법 — 공유 부분과 로봇별 adapter
GR00T 의 구조는 모든 로봇이 공유하는 부분(VLM + DiT) 과 로봇마다 다른 작은 adapter(MLP) 의 조합입니다. MLP 는 로봇마다 다른 관절 값을 모델 내부의 공통 표현(256차원 latent)으로 바꾸는 일만 합니다. 그래서 새 로봇을 붙일 때 무거운 공유 부분은 그대로 두고 MLP 만 새로 학습하면 됩니다. 수 시간, 약 10달러 수준입니다. 로봇마다 다른 관절 언어를 공통 언어로 옮기는 통역사와 같습니다.
파란 상자는 모든 로봇이 공유하는 부분이고 얼려 둡니다. 주황 상자 둘만 로봇마다 새로 학습합니다.
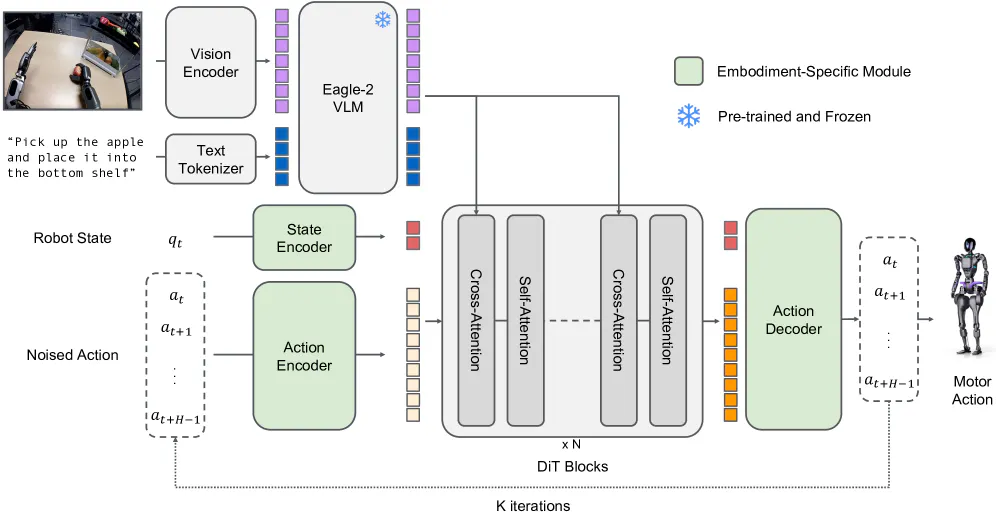
출처: NVIDIA Isaac GR00T N1, arXiv:2503.14734 Fig. 3 · CC BY 4.0
위 그림은 GR00T N1 논문의 원본 구조도로, 앞의 단순화한 도식과 같은 구조를 조금 더 자세히 보여줍니다.
- 눈송이 표시(Eagle-2 VLM) — 사전학습된 채 얼려 둔 공유 부분입니다. 카메라 이미지는 Vision Encoder 로, 지시문은 Text Tokenizer 로 토큰이 되어 VLM 에 들어갑니다. 위 도식의 파란 VLM 상자입니다.
- 가운데 DiT Blocks — 행동을 만드는 System 1 입니다. 블록 안의 Cross-Attention 이 VLM 의 출력 토큰을 참고하는 자리이고, Self-Attention 이 행동 토큰끼리 서로 맞추는 자리입니다. 이 블록을 N 번 쌓았습니다.
- 초록 상자 셋(State Encoder · Action Encoder · Action Decoder) — 로봇마다 다른 embodiment-specific 모듈, 즉 adapter MLP 입니다. 위 도식에서는 State Encoder 와 Action Decoder 둘만 그렸지만, 원본에는 잡음 섞인 행동을 DiT 입력으로 바꾸는 Action Encoder 도 있습니다.
- 왼쪽 아래 Noised Action 과 아래쪽 K iterations 화살표 — 앞의 DiT 용어 상자에서 설명한 잡음 제거 반복입니다. 무작위 숫자로 채운 행동 묶음(a_t … a_t+H−1)이 들어가서 Action Decoder 로 나오고, 그 결과를 다시 입력으로 넣기를 K 번 반복해 실제 관절 명령(Motor Action)이 됩니다. 이 K 는 고정값이 아니라 추론 때 정하는 설정값입니다. 공개 코드에서는
num_inference_timesteps이고 N1.6 은 10, N1.7 은 4 를 기본으로 씁니다. 학습 때는 잡음 정도를 연속으로 바꿔 가며 "고칠 방향" 을 배우기 때문에, 추론에서 몇 번에 나눠 갈지는 나중에 골라도 됩니다. K 를 줄이면 빨라지고 품질이 조금 떨어지며, 1 로 두면 뒤에서 볼 애니메이션처럼 평균으로 무너집니다.
freeze / unfreeze — 무엇을 바꾸고 싶은가
"무엇을 바꾸고 싶은가" 에 따라 어느 부품을 학습(unfreeze)하고 어느 부품을 고정(freeze)할지가 달라집니다.
| 바꾸려는 것 | MLP (adapter) | DiT (action head) | VLM (이해) | 비용 감각 |
|---|---|---|---|---|
| 기존 로봇 + 기존 동작 그대로 | 유지 | 유지 | 유지 | 학습 불필요 |
| 새 로봇, 기존 동작 | 학습 | freeze | freeze | 수 시간, 약 10달러 |
| 새 동작 (사전학습에 없던 동사) | 학습 | 학습 | freeze | 반나절 |
| 특수 카메라 (적외선 등) | 학습 | 학습 | LoRA | 수 일, 비쌈 |
MLP 는 로봇이 바뀔 때, DiT 는 동작 자체가 새로울 때 손댑니다. 접기·붓기·쌓기 같은 흔한 동작은 이미 사전학습에 있어 MLP 만으로 되지만, 용접·저글링처럼 없던 동작은 DiT 까지 열어야 합니다.
새 로봇에는 반드시 어댑터가 필요합니다. 공개 모델은 사전 등록된 몇 개 embodiment 의 MLP 만 내장합니다. 그 외 로봇은 MLP 가 없어 그대로 올리면 의미 없는 출력이 나옵니다. 시연 100개와 adapter 학습이 최소 조건입니다.
한 번에 여러 스텝 — action chunk
action head 가 한 번에 뱉는 것은 한 스텝이 아니라 미래 여러 스텝의 묶음 입니다. 이것이 action chunk 이고, GR00T N1.6 은 16 스텝, N1.7 은 40 스텝입니다.
실효 제어 주기 = 추론 Hz × 한 번에 실행하는 스텝 수 입니다. 아래 그림처럼 어떤 모델이 소형 보드에서 초당 10회밖에 추론하지 못해도, 추론마다 16 스텝을 예측하고 그중 앞 8 스텝을 실행하면 로봇은 80 Hz 로 부드럽게 움직입니다. 나머지 8 스텝은 여유분이고, 로봇이 앞 8 스텝을 실행하는 동안 다음 chunk 를 미리 계산합니다. 내비게이션이 "앞으로 1 km 경로" 를 한 번에 주는 것과 같습니다.
chunk 는 저장 포맷이 아니라 정책의 일부입니다. 데이터 수집 편의로 16 스텝 chunk 를 1 스텝으로 쪼개 실행하면 정책이 무너집니다. 한 실측에서 20 스텝 실행은 10회 중 3회 성공, 1 스텝 실행은 48회 중 0회 성공이었습니다.
행동을 만드는 방법 — 회귀 · token · diffusion · flow matching
policy 의 출력은 언제나 숫자 묶음(위의 실수 112개)입니다. 이 숫자를 신경망이 어떤 방식으로 뽑아내느냐 가 action head 의 전부이고, token · diffusion · flow matching 은 그 뽑는 방식의 이름입니다.
회귀 — mode averaging 문제
가장 단순한 방법은 신경망이 숫자 112개를 바로 출력하고 정답과의 거리(MSE)를 줄이는 것입니다. 이것이 회귀(regression) 이고, 신경망 학습의 가장 기본적인 방식입니다. 그런데 이 방법에는 한 가지 문제가 있고, 나머지 세 방법은 모두 그 문제를 피하려고 나왔습니다.
컵 앞에 장애물이 있습니다. 시연 데이터의 절반은 왼쪽으로 돌아갔고 절반은 오른쪽으로 돌아갔습니다. MSE 로 학습한 신경망은 둘의 평균 인 "정면 직진" 을 내놓고 장애물을 들이받습니다. 데이터에 없는 행동이 나옵니다. 이것이 mode averaging 입니다.
그래서 필요한 것은 점이 아니라 분포 를 배우고, 거기서 하나를 뽑는(sampling) 능력입니다. 세 방법은 전부 "분포에서 샘플링" 을 서로 다른 방식으로 구현한 것입니다.
방법 1 — token: 칸 고르기
실수를 정수 칸(bin)으로 잘라 그중 하나를 고르는 분류 문제로 바꿉니다. 관절 각도 범위를 256칸으로 나누면 각 각도는 0~255 중 하나의 번호가 됩니다. 언어 모델이 어휘에서 다음 단어를 고르듯, 256개 중 하나를 고릅니다.
고르는 방식이 두 단계입니다. 먼저 신경망이 256칸 각각에 확률을 매깁니다. 예를 들어 136번 칸 20%, 137번 칸 55%, 138번 칸 18% 처럼요. 그다음 그 확률대로 무작위로 하나를 고릅니다. 이것을 샘플링 이라 하고, 그래서 같은 입력에도 결과가 조금씩 달라질 수 있습니다. 항상 확률이 가장 높은 칸만 고르지 않는 이유는 봉우리가 둘일 때(왼쪽 우회 45%, 오른쪽 우회 45%) 둘 다 나올 수 있어야 하기 때문입니다. 언어 모델이 같은 질문에 매번 조금 다른 답을 내는 것과 같은 원리입니다.
- 학습 — 정답 칸 번호를 맞히는 분류 문제. 언어 모델 학습과 똑같습니다.
- 추론 — 관절 1 칸 뽑기 → 관절 2 칸 뽑기 → … 정해진 차례로 한 칸씩. 앞에서 뽑은 칸이 뒤 칸의 확률에 조건으로 들어가므로, 관절 1 을 왼쪽 우회 쪽으로 뽑았으면 관절 2 도 그쪽으로 몰립니다. 112개면 112번 순차 호출입니다.
- 비유 — 숫자 128.4 를 "일-이-팔" 세 글자로 받아쓰는 것. 소수점은 버려집니다.
- 장점 — VLM 을 손대지 않고 그대로 씁니다. 언어 토큰과 행동 토큰이 같은 어휘장입니다.
- 단점 — 양자화 오차, 순차 생성이라 느림(OpenVLA 약 6 Hz), 부드러움 보장 없음.
- 대표 — RT-2, OpenVLA, π0-FAST
방법 2 — diffusion: 잡음 정제
정답 행동에 잡음을 조금씩 섞어 완전한 잡음으로 만드는 과정을 거꾸로 배웁니다. 추론 때는 잡음 112개에서 시작해 "여기서 잡음이 얼마나 섞였나" 를 예측해 빼기를 반복하면 행동이 드러납니다.
diffusion 이라는 이름은 물리학의 확산에서 왔습니다. 잉크 한 방울이 물에 퍼져 결국 균일한 잡음이 되는 과정을 거꾸로 돌리면 잡음에서 잉크 방울을 복원할 수 있다는 발상이고, 이미지 생성(Stable Diffusion)에서 먼저 성공한 뒤 로봇 행동 생성에도 쓰이게 됐습니다.
- 학습 — 잡음 섞인 행동 + 시각 → 섞인 잡음을 맞히기.
- 추론 — 잡음 → 정제 반복(원 논문 100 스텝, 실기에서는 10 스텝). 매 스텝 112개를 한꺼번에 갱신합니다.
- 비유 — 흐린 사진을 점점 선명하게 복원하기. 조각가가 돌덩이에서 형체를 깎아 내기.
- 장점 — 연속값 그대로, 봉우리 여러 개도 잘 표현, chunk 전체가 한 덩어리라 부드럽습니다.
- 단점 — 정제 스텝 수만큼 신경망을 반복 호출합니다.
- 대표 — Diffusion Policy, Octo
방법 3 — flow matching: 속도장 따라 이동
diffusion 과 목적지는 같습니다. 무작위 숫자에서 출발해 여러 번 고쳐 진짜 행동에 도착합니다. 다른 점은 무엇을 배우느냐 입니다. diffusion 은 "지금 섞여 있는 잡음이 얼마인가" 를 배우고, flow matching 은 "지금 위치에서 어느 방향으로 얼마나 가야 하는가", 즉 속도 를 배웁니다.
행동 공간의 모든 지점에 "여기서는 이 방향으로 이만큼 가라" 는 속도가 하나씩 정해져 있고, 이 속도들의 모음을 속도장(velocity field) 이라 부릅니다. flow matching 은 이 속도장을 신경망에 배우게 하는 방법입니다. 지도 위 모든 지점에 화살표가 하나씩 그려진 것과 같습니다.
학습 과정. 시연에서 진짜 행동 하나(x₁)를 꺼내고, 무작위 숫자 하나(x₀)를 만들어 둘을 직선으로 잇습니다. 그 직선 위의 아무 지점 하나를 고르고(t 가 0 이면 잡음 쪽 끝, 1 이면 정답 쪽 끝, 0.3 이면 잡음에서 30% 간 지점), 신경망에게 "이 지점의 화살표는 정답 쪽을 가리켜야 한다" 고 가르칩니다. 직선이니 화살표 방향은 항상 x₁ − x₀ 로 같습니다. 이것을 수만 번 반복하면 신경망이 속도장 전체를 익힙니다.
추론 과정. 무작위 숫자에서 출발해, 그 자리의 화살표를 신경망에게 묻고, 그 방향으로 조금 이동합니다. 새 자리에서 다시 묻고 또 조금 이동합니다. 이것을 10번쯤 하면 정답 행동 근처에 도착합니다. 아래 애니메이션의 flow matching 패널에서 파란 선이 이 이동 경로입니다.
- 학습 — t ∈ [0, 1] 하나 뽑고 x_t = (1−t)·x₀ + t·x₁ 에서 v = x₁ − x₀ 맞히기. 말로 풀면 "잡음과 정답 사이 t 지점에서, 화살표는 정답 방향".
- 추론 — x ← x + v·Δt 를 10 스텝 정도(π0 기본 10). 말로 풀면 "현재 위치에 화살표 × 보폭을 더해 한 발 이동". 112개 숫자를 한꺼번에 움직입니다.
- 장점 — 배울 것이 "직선 화살표" 하나라 수식이 단순하고, diffusion 처럼 잡음을 얼마나 섞을지 정하는 schedule 이 필요 없으며, 적은 스텝으로 실용 품질이 나옵니다.
- 대표 — π0, SmolVLA, GR00T N1
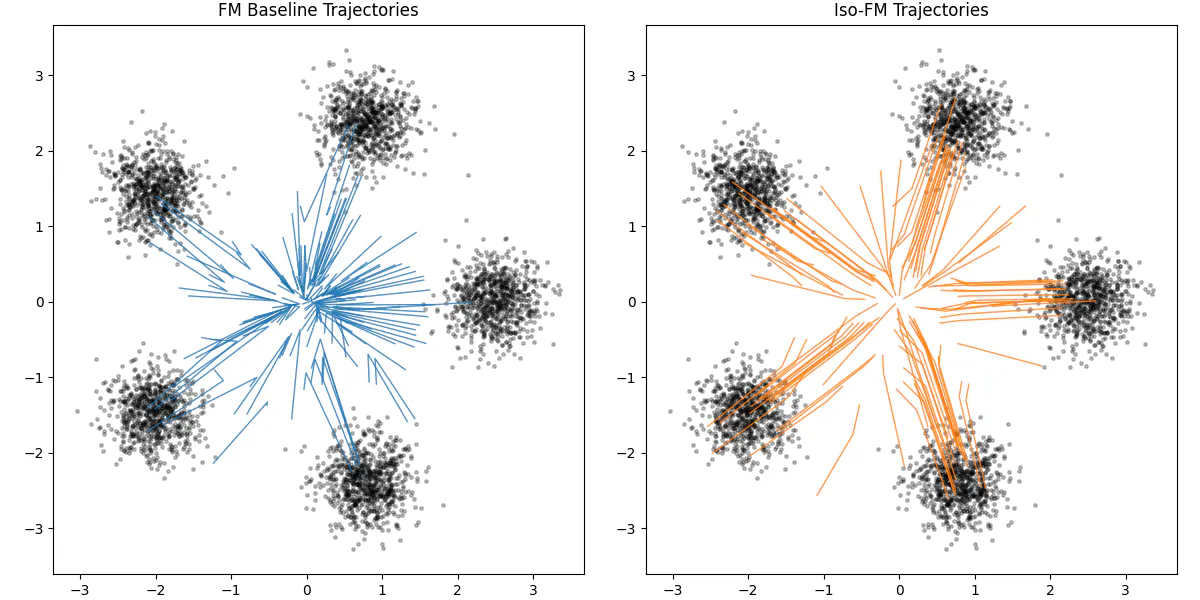
출처: Khan, arXiv:2604.04491 Fig. 1 · CC BY 4.0
위 그림은 flow matching 이 잡음을 데이터로 옮기는 경로를 보여줍니다. 검은 점 무리 여섯 개가 데이터, 즉 정답 행동의 봉우리들이고, 가운데가 잡음의 시작점입니다. 선 하나가 잡음 점 하나가 속도장을 따라 데이터로 이동한 경로입니다. 왼쪽은 기본 flow matching, 오른쪽은 경로를 더 곧게 펴도록 학습을 바꾼 변형입니다. 이 시리즈에서 볼 것은 두 가지입니다. 경로가 평균으로 뭉치지 않고 여섯 봉우리로 갈라져 도착한다는 것, 그리고 경로가 대체로 직선에 가까워 적은 스텝으로도 도착한다는 것입니다. 아래 애니메이션의 flow matching 패널이 이것을 봉우리 두 개로 줄인 것입니다.
네 방식 비교 애니메이션
네 방식을 같은 조건에서 나란히 돌려 보면 차이가 한눈에 들어옵니다. 아래 애니메이션은 실수 112개 대신 행동을 2차원(x, y) 하나로 줄인 간단한 예제입니다. 회색 점이 시연 데이터, 가운데 원이 장애물입니다.
한 줄 정리. token 은 "분류 문제로 바꾸기", diffusion 과 flow matching 은 "잡음을 행동으로 옮기기" 입니다. 뒤의 둘은 같은 계열이고, 앞의 하나만 계열이 다릅니다. 스텝을 1 로 줄이면 diffusion 과 flow 둘 다 평균으로 무너져 회귀와 같아집니다. 여러 번 나눠 가야 봉우리로 갈라집니다.
π0 가 이를 공개적으로 실증했습니다. PaliGemma 3B VLM 에 flow matching action expert 를 얹어 50 스텝 chunk 를 10번의 적분으로 뽑고 조작을 최대 50 Hz 로 구동합니다(arXiv:2410.24164). GR00T 와 π0 계열이 flow matching 을 택한 이유는, 큰 모델로도 제어 루프를 돌릴 만큼 빠르게 행동을 뽑아 주기 때문입니다.
행동 표현의 층위
지금까지 행동을 "관절 각도 숫자" 로만 봤습니다. 그런데 행동은 다른 형태로도 적을 수 있습니다. "컵을 왼쪽에 놓아라" 같은 문장도 행동이고, "잡을 지점은 여기" 같은 좌표도 행동입니다. 사람 말에 가까운 것부터 모터 명령에 가까운 것까지 한 줄로 세우면 아래 표가 됩니다.
| 층위 | 무엇으로 행동을 나타내나 | trade-off |
|---|---|---|
| 추상 — 언어·코드 | "컵을 왼쪽에 놓아라" 같은 자연어 하위 목표, 호출할 코드 이름 | 읽기 쉽고 재사용 강함. 실제 관절까지는 하위 실행기가 또 필요 |
| 중간 — token·affordance·궤적 | 행동을 이산 토큰으로 양자화, 잡을 지점, 목표 궤적 | 언어 모델과 궁합 좋고 안정적. 양자화 손실 |
| 구체 — raw action | 매 스텝의 관절 각도·속도 같은 연속 실수 (chunk + flow matching 이 여기) | 가장 정밀하고 매끄러움. 연속값 예측이 어렵고 고빈도 생성 부담 |
최신 VLA 는 이 표의 두 층을 겹쳐 씁니다. 예를 들어 π0.5 는 먼저 추상 층에서 "다음 하위 작업: 접시를 집어라" 를 텍스트로 내고, 그 문장을 조건으로 구체 층에서 flow matching 이 raw action(관절 명령 50 스텝)을 냅니다. 상위는 언어로 계획하고, 하위는 flow matching 으로 연속 행동을 생성 하는 구조입니다.
분류 출처: action tokenization survey, arXiv:2507.01925
π 계열 — 또 다른 설계 철학
GR00T 가 "공유 부분 + 로봇별 MLP adapter" 로 명시적 분리를 택했다면, Physical Intelligence 의 π0 계열은 관절 상태를 VLM 에 직접 토큰으로 넣는 통합형입니다.
| 버전 | 핵심 변화 | 공개 |
|---|---|---|
| π0 (2024) | PaliGemma + flow matching 최초, 양팔 조작 특화 | 공개 |
| π0.5 (2025) | 웹 데이터 co-training → 열린 환경 일반화, 모바일 조작 | 공개 |
| π0.6 (2025) | Gemma 3 4B backbone, knowledge insulation | 미공개 |
| π*0.6 (2025) | + RECAP: 배포 후 경험으로 개선 (배치 offline RL) | 미공개 |
| π0.7 (2026) | 멀티프레임 영상 기억 (카메라당 최대 6장) | 미공개 |
공개 여부는 작성 시점 기준이고 이후 바뀔 수 있습니다.
두 아이디어가 특히 배울 만합니다. knowledge insulation 은 VLM 과 action expert 사이의 gradient 를 끊어, VLM 은 이해에만, action expert 는 행동에만 집중하게 합니다. RECAP 은 RL with Experience and Corrections via Advantage-conditioned Policies 의 줄임말로, 배포된 로봇의 경험(experience)과 사람의 교정(corrections)을 모아 강화학습으로 정책을 개선하는 방법입니다. "배포된 로봇이 자기 경험으로 스스로 나아진다" 로 소개되는데, 이 문구 때문에 로봇이 돌아다니며 실시간으로 배운다고 오해하기 쉽습니다. 실제로는 실행 중 가중치는 읽기 전용이고, 로봇이 모은 경험을 별도 서버로 보내 일괄 재학습한 뒤 새 checkpoint 를 다시 배포하는 배치 사이클입니다. 데이터 수집 → 오프라인 재학습 → 재배포가 한 바퀴이고, 로봇이 현장에서 배우는 것처럼 보이는 것은 이 바퀴가 반복되기 때문입니다.
행동이 아니라 세계를 예측 — WFM 과 WAM
WFM(World Foundation Model) 은 로봇 행동 대신 물리 세계의 다음 장면을 생성합니다. NVIDIA Cosmos 가 대표이고, 내부는 VLA 와 닮았습니다. 언어 backbone 이 텍스트를 이해하고, DiT 비디오 엔진이 잡음에서 미래 영상을 denoise 로 생성합니다. "행동을 denoise" 하는 게 VLA 라면 "영상을 denoise" 하는 게 WFM 입니다.
WFM 은 물리 시뮬레이터가 아닙니다. 물리 시뮬레이터가 강체·접촉·마찰을 수치로 계산해 로봇의 몸을 굴린다면, WFM 은 시뮬레이터가 만든 회색 장면을 사실적으로 바꾸거나 조명·질감·시점을 다양화해 학습 데이터를 불립니다. 물리 시뮬레이터가 몸의 움직임을, WFM 이 눈에 보이는 장면을 맡는 분업입니다.
WAM(World Action Model) 은 여기서 더 나아가 미래 영상과 로봇 행동을 한 모델에서 동시에 예측합니다.
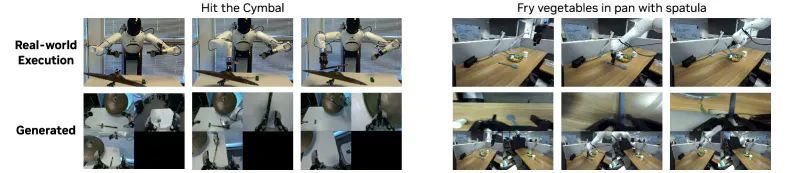
출처: Ye et al., arXiv:2602.15922 Fig. 1 · CC BY 4.0
VLA 와의 결정적 차이는 backbone 입니다. VLA 는 언어 모델을, WAM 은 비디오 생성 모델 을 뼈대로 씁니다. 웹 규모 영상으로 사전학습한 비디오 모델은 "물체를 밀면 어떻게 움직이는가" 같은 세계 물리를 이미 알고 있고, 여기에 행동을 얹어 학습하면 그 물리 지식이 로봇 정책으로 전이됩니다.
| 구분 | VLA (GR00T, π 계열) | WAM (DreamZero) |
|---|---|---|
| backbone | 언어·비전 모델 | 비디오 확산 모델 |
| 사전학습 데이터 | 정적 이미지-텍스트 | 웹 규모 비디오 |
| 출력 | 행동만 | 미래 영상 + 행동 |
| 안 배운 동작 | 약함, 시연 의존 | 상대적으로 강함 |
| 추론 속도 | 빠름 | 느림 (14B 반복 denoising, 약 7 Hz) |
"VLA 는 끝났다" 는 헤드라인. 2026년 NVIDIA 의 Jim Fan 이 키노트에서 "VLAs are dead, long live World Action Models" 라고 말해 화제가 됐습니다. 하지만 같은 시기에 NVIDIA 자신이 VLA 인 GR00T N1.7 을 출시했습니다. Physical Intelligence 의 π0.7 도 VLA 를 버리지 않고, 작은 world model 을 VLA 앞에 붙여 "다음에 어떤 장면이 되어야 하는지" 를 먼저 그려 보게 한 뒤 그 목표에 맞춰 행동을 내도록 했습니다. 즉 VLA 가 사라지는 것이 아니라, VLA 와 world model 과 강화학습 후학습을 한 시스템 안에서 같이 쓰는 방향 으로 가고 있습니다.
checkpoint 관리 — 가중치의 단계별 분기
VLA 가중치는 한 번에 만들어지지 않습니다. generalist 에서 출발해 단계적으로 특화하며, 각 단계의 checkpoint(가중치 스냅샷)를 보존해 다음 fine-tune 의 출발점으로 재사용합니다.
실무에서 지키는 규칙입니다.
- chain 은 단방향 — 한 번 특화된 가중치에서 generalist 를 되살리는 것은 사실상 불가능합니다. 새 작업을 배우며 이전 능력을 잊는 catastrophic forgetting 때문입니다. generalist checkpoint 는 반드시 따로 보존합니다.
- 학습은 이전 checkpoint 로 되돌아가는 반복 — 어떤 정책이 특정 동작에 과적합해 무너지면 그 방향으로 더 학습하지 말고 이전의 더 일반적인 checkpoint 로 되돌아가 다시 분기합니다.
- 공개 가중치가 chain 의 어느 단계인지 — generalist 면 새 로봇에 쓸 수 있지만, 데모용 specialist 면 그 환경 밖에서는 못 씁니다. OpenVLA · GR00T · π0 계열이 generalist checkpoint 를 공개하는 이유가 이것입니다.
모방학습의 한계 — loss 가 낮아도 성공률이 안 오르는 이유
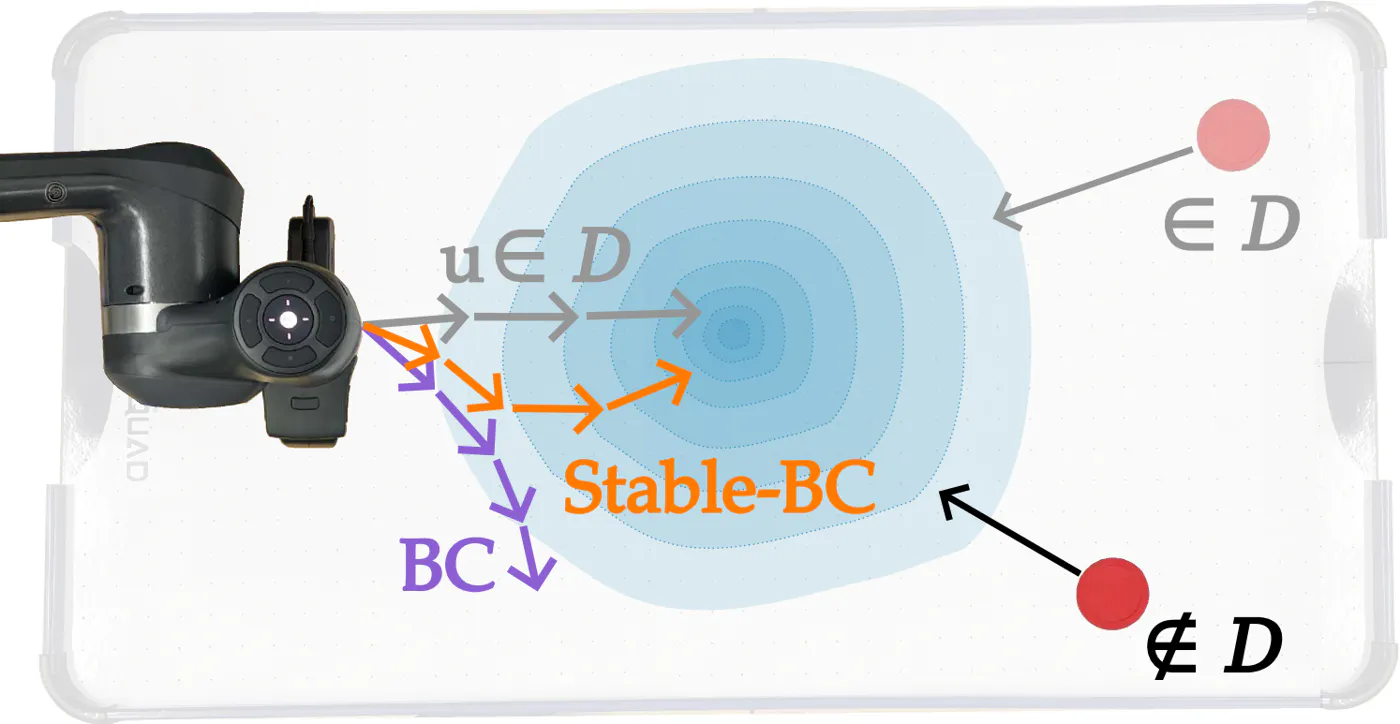
behavior cloning 으로 VLA 를 학습하면 training loss 를 7배 낮춰도 실제 성공률은 전혀 오르지 않는 일이 흔합니다. 과적합이 아니라 covariate shift 때문입니다.
출처: Mehta et al. (Stable-BC), arXiv:2408.06246 · CC BY 4.0
BC 는 "전문가가 있던 상태 → 전문가 행동" 쌍만 배웁니다. 실행 중 정책이 스스로 조금 어긋나면 시연에 없던 새 상태에 진입하는데, 그 상태에서 어떻게 회복하는지는 데이터에 없습니다. 회복 신호가 없으니 오차가 누적되고 무너집니다.
쉽게 말하면 로봇이 시연을 완벽히 외웠다고 해도, 실제로 움직이면 시연과 아주 조금은 다르게 움직입니다. 그 조금의 차이 때문에 로봇은 시연에 한 번도 없던 자세에 놓이게 됩니다. 시연에는 그 자세에서 어떻게 해야 하는지가 없으니 다음 행동도 조금 어긋나고, 그다음은 더 어긋납니다. 이렇게 작은 오차가 쌓여 결국 실패합니다. loss 는 시연을 얼마나 잘 외웠는지만 재기 때문에 이 문제를 못 잡습니다. validation loss 도 같은 시연에서 뽑은 것이라 마찬가지입니다.
처방은 "더 좋은 validation set" 이 아니라 정책이 실제로 방문하는 분포를 학습에 넣는 것 입니다.
세 가지는 경쟁 기법이 아니라 같은 문제를 점점 더 강하게 푸는 한 흐름입니다. 그래서 DAgger 와 RL 은 선택 사항이 아니라 covariate shift 때문에 꼭 필요한 단계이고, SFT 다음에 RFT 가 옵니다. 진단 규칙 하나. loss 가 거의 0 인데 성공률이 평탄하면 더 학습할 것이 아니라 접근 자체를 의심하고, 평가는 loss 가 아니라 rollout 성공률로만 합니다.
요약
- VLA 는 VLM(System 2) + action head(System 1) + embodiment adapter 세 부품의 조립이고, 새 로봇에는 어댑터만, 새 동작에는 action head 까지 학습합니다.
- action head 는 숫자 묶음을 뽑는 방식입니다. 회귀는 평균의 함정에 빠지고, token 은 분류로 바꾸고, diffusion 과 flow matching 은 잡음을 행동으로 옮깁니다. chunk 는 정책의 일부입니다.
- WFM 은 세계를, WAM 은 세계와 행동을 함께 예측합니다. "VLA 는 끝났다" 가 아니라 VLA + world model + RL 후학습으로 수렴하는 중입니다.
- 모방학습의 한계은 covariate shift 이고, 처방은 DAgger 와 RL 입니다. 평가는 rollout 성공률로 합니다.
다음 편에서는 로봇 자체를 다룰 때 만나는 용어에 대한 이야기입니다.
다음 편 → 5편 로봇을 다루는 언어와 아직 안 풀린 문제