모델을 구분하는 다섯 가지 질문
Physical AI 에는 RT-2, OpenVLA, Diffusion Policy, π0, GR00T, Cosmos, DreamZero 처럼 모델이 많습니다. 이름을 하나씩 외우기보다 다섯 가지 질문 을 기준으로 나누면 이해하기 쉽습니다. 어떤 모델이든 이 다섯 질문에 하나씩 답한 결과이기 때문입니다.
다섯 질문은 서로 독립입니다. 그래서 "VLA 인가 diffusion 인가" 같은 질문은 성립하지 않습니다. 하나는 ②의 답이고 하나는 ⑤의 답입니다. 이 편의 앞부분에서는 다섯 질문을 순서대로 설명합니다. ⑤는 4편에서 그림과 애니메이션으로 따로 다루므로 여기서는 간단히만 다룹니다.
① 어디서 배우나 — foundation model
첫 번째 질문은 "내 시연 데이터만으로 처음부터 학습하나, 아니면 남이 크게 사전학습해 둔 모델 위에서 조금만 적응하나" 입니다. 2023년까지는 전자가 보통이었고, 지금은 후자가 주류입니다.
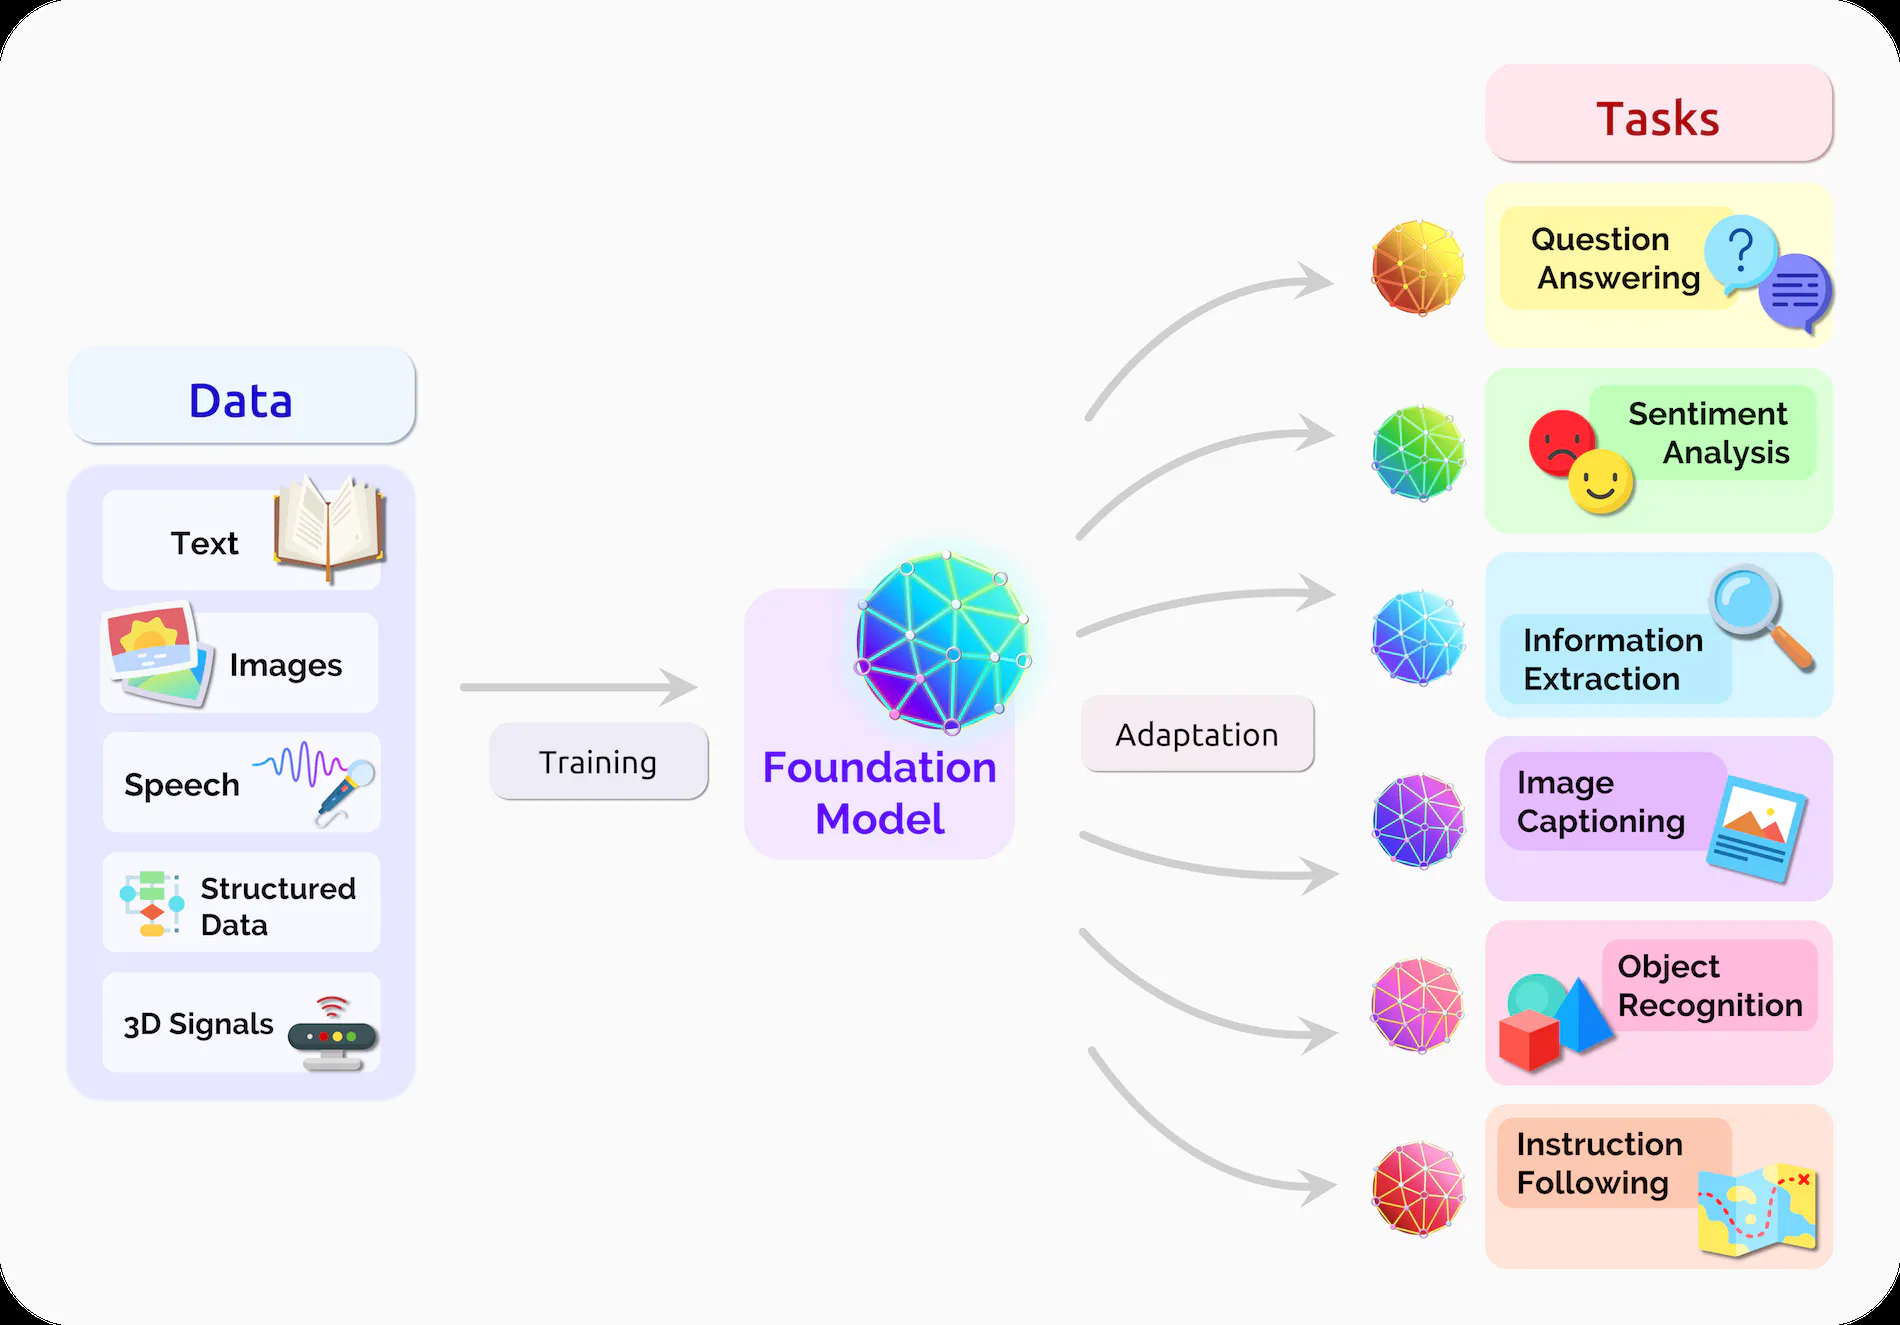
출처: Bommasani et al. (Stanford CRFM), arXiv:2108.07258 Fig. 2 · CC BY 4.0
로봇에서 이 방식이 통하려면 사전학습 데이터가 있어야 합니다. 1편의 데이터 피라미드에서 본 대로 로봇 데이터는 귀하므로, 인터넷 이미지·텍스트로 먼저 배운 VLM 에서 출발해, 여러 로봇의 시연(Open X-Embodiment)을 추가로 학습시킵니다. 그 결과가 다음 질문의 VLA 입니다.
② 무엇을 예측하나 — 행동, 세계, 또는 둘 다
두 번째 질문은 모델의 출력 입니다. 대부분은 행동을 예측하지만, 행동 대신 세계의 다음 장면을 예측하는 계열이 따로 있습니다.
세 모델의 입력은 같습니다. 이미지와 언어 지시입니다. 다른 것은 출력입니다.
- VLA (Vision-Language-Action) 는 관절 명령을 냅니다. 로봇을 직접 움직이는 policy 이고, 이 시리즈에서 주로 다루는 모델입니다.
- WFM (World Foundation Model) 은 행동 대신 다음 장면 영상을 냅니다. NVIDIA Cosmos 가 대표입니다. 로봇을 움직이지는 못하지만, 시뮬레이션 데이터를 만들거나 policy 가 낼 결과를 미리 그려 보는 데 씁니다.
- WAM (World Action Model) 은 미래 영상과 관절 명령을 같이 냅니다. DreamZero 가 대표입니다. 영상을 예측하며 배운 물리 지식이 행동에도 옮겨 가기를 노린 구조입니다.
모든 VLA 는 RFM 이지만 모든 RFM 이 VLA 는 아닙니다. WFM 과 WAM 도 RFM 입니다. 한 모델이 텍스트·영상·소리·행동을 모두 이해하고 생성하려는 흐름을 omnimodel 이라 부르는데, 아직 벤더별 용어라 "여러 modality 를 다룬다" 는 뜻 정도로 이해하시면 됩니다. WFM 과 WAM 의 내부 구조는 4편에서 설명합니다.
③ 뇌를 몇 개로 나누나 — System 2 와 System 1
세 번째 질문은 구조 입니다. 신경망 하나가 보고·알아듣고·움직이기를 통째로 하느냐, 아니면 느리게 이해하는 부분과 빠르게 움직이는 부분을 나누느냐입니다.
위 그림은 신경망 하나가 인지부터 행동까지 통째로 맡는 구조입니다. 초기 OpenVLA 와 RT-2 가 이렇습니다. 단순하고 end-to-end 이지만, 큰 모델의 느린 추론 속도가 빠른 제어를 제한하고, 내부 동작을 확인하기 어렵습니다.
아래 그림은 둘로 나눈 구조입니다. System 2 는 VLM 입니다. 카메라 영상과 언어 지시를 이해하고, 느리게 몇 Hz 로 돕니다. System 1 은 action head 입니다. System 2 가 넘긴 이해 토큰과 관절 상태를 받아 관절 명령을 빠르게 수십 Hz 로 만듭니다. 두 부분이 서로 다른 속도로 돌 수 있고 부품을 따로 바꿀 수 있는 대신, 둘 사이에 무엇을 넘길지 설계가 필요합니다. GR00T, π0, Helix, Gemini Robotics 가 이렇습니다.
System 1 과 System 2 라는 이름은 심리학에서 왔습니다. 사람도 "무엇을 할지" 는 천천히 생각하고, "손을 어떻게 움직일지" 는 생각 없이 빠르게 처리합니다. 로봇의 두 부분에 같은 이름을 붙인 것입니다. 2025년 이후 대형 모델은 거의 둘로 나눕니다. 4편에서 GR00T 의 구조를 보면 System 2 가 VLM, System 1 이 action head 입니다.
계층을 더 잘게 나누는 관점도 있습니다. 상위 계획자 가 목표를 하위 작업으로 쪼개고 하위 실행자 가 관절을 움직이는 hierarchical 구조인데, 이 시리즈에서는 "둘로 나눈다" 에 포함된 것으로 봐 주셔도 됩니다.
④ 행동 전에 말로 생각하나 — embodied chain-of-thought
네 번째 질문은 추론 입니다. 보자마자 행동을 내느냐, 아니면 행동 전에 계획 → 하위 작업 → 그리퍼 위치 → 대상 물체 위치를 글로 먼저 쓰고 나서 행동하느냐입니다. 후자를 embodied chain-of-thought(ECoT)라 부릅니다. chain-of-thought 는 언어 모델에 "단계별로 생각해 보자" 고 시키면 수학 문제를 더 잘 푼다는 2022년 발견에서 온 이름이고, 그 앞에 붙은 embodied 는 "몸이 있는", 즉 로봇 버전이라는 뜻입니다.
효과는 있습니다. 다만 무엇을 쓰게 하느냐가 중요합니다. "컵을 집는다 → 손을 뻗는다" 처럼 말로만 계획을 쓰게 하면 성공률이 48% 였고, 거기에 "물체는 화면의 [280, 190, 350, 260] 에 있고 그리퍼는 (312, 208) 에 있다" 처럼 지금 보이는 화면의 좌표까지 쓰게 하면 66% 로 올랐습니다. 말로만 생각하면 모델이 화면을 제대로 안 보고 그럴듯한 문장만 만들 수 있는데, 좌표를 쓰려면 화면을 볼 수밖에 없기 때문입니다. 이렇게 추론을 실제 관측과 연결하는 것을 grounding 이라 부릅니다.
대신 추론 토큰이 수십 배로 늘어 느려집니다. 그래서 매 스텝이 아니라 몇 스텝마다 한 번만 다시 추론하는 절충을 씁니다.
근거: Embodied Chain-of-Thought Reasoning, arXiv:2407.08693
③과 ④는 다른 축입니다. GR00T 는 뇌를 둘로 나누지만 말로 생각하지는 않습니다. VLM 의 중간 표현을 그대로 action head 에 넘기고 텍스트를 생성하지 않습니다. 반대로 ECoT 는 뇌 하나(OpenVLA)에 추론 토큰을 앞세운 것입니다. π0.5 와 Gemini Robotics 는 둘 다 합니다.
⑤ 행동 숫자를 어떻게 뽑나 — action head
마지막 질문은 관절 명령이라는 숫자 묶음을 어떤 방식으로 생성하느냐 입니다. 회귀, token, diffusion, flow matching 네 가지가 있고 4편에서 그림으로 설명합니다. 여기서는 흔한 혼동 하나만 풀어 둡니다.
VLA 와 diffusion policy 를 서로 다른 종류의 모델처럼 나란히 놓고 비교하는 글이 많습니다. 그런데 이 둘은 같은 층위의 이름이 아닙니다. VLA 는 ①②의 답입니다. foundation model 위에서 행동을 예측하는 모델이라는 뜻입니다.
한편 diffusion 은 ⑤의 답입니다. 행동 숫자를 잡음 정제로 뽑는 방법이라는 뜻입니다. 즉, VLA 와 diffusion policy 는 서로 다른 질문에 대한 답이므로 한 모델이 두 가지 특징을 동시에 가질 수 있습니다. 예를 들어 π0 와 GR00T 는 foundation model 위에서 행동을 예측하는 VLA 이면서, 그 행동 숫자는 diffusion 계열인 flow matching 으로 뽑습니다.
| ①② 배경 \ ⑤ head | token | diffusion | flow matching |
|---|---|---|---|
| 내 시연만, 처음부터 | — | Diffusion Policy (2023) | 드묾 |
| foundation model 위에서 = VLA | RT-2 · OpenVLA (2023~24) | Octo | π0 · GR00T N1 · SmolVLA (2024~) |
그런데도 "VLA 와 diffusion policy 는 다른 길" 이라는 말이 남아 있는 이유는 시간 순서로 보면 이해됩니다.
- 2023년 — VLA 라 불리던 모델(RT-2, OpenVLA)은 모두 행동을 token 으로 뽑았습니다. 같은 해에 나온 Diffusion Policy 는 VLM 없이 내 시연만으로 배우는 작은 모델이었습니다. 당시에는 "VLA 는 token, diffusion 은 소형 모델" 로 자연스럽게 나뉘어 있었고, 그래서 둘을 다른 길이라 불렀습니다.
- 2024년 후반 — π0 가 VLA 에 flow matching 을 붙였고, GR00T 가 뒤따랐습니다. VLA 도 diffusion 계열로 행동을 뽑게 된 것입니다.
- 지금 — "VLA 인가 diffusion 인가" 는 더 이상 구분이 아닙니다. 위 표처럼 두 질문의 조합으로 봐야 합니다.
여기까지가 설계 선택지 입니다. 다음은 그 선택지 위에서 연구가 어디까지 왔는지입니다. 모델 계보, 벤치마크, 학습 데이터, sim-to-real gap 순서로 봅니다.
모델 계보 타임라인
최근 VLA 는 대체로 하나의 계보를 따릅니다. 큰 흐름만 알아 두면 새 모델이 나와도 어느 모델의 후속인지 보입니다.
이 흐름에서 특히 cross-embodiment 가 2025~26년의 핵심 축입니다. 로봇 한 대에 1만 시간을 쏟는 대신 수십 개 로봇을 먼저 함께 학습해 두면, 새 로봇에는 소량만 적응시켜도 됩니다.
모델 비교 — 벤치마크와 데이터셋
"이 VLA 가 저 VLA 보다 낫다" 를 말하려면 공정한 비교 기준이 필요합니다. 표준화된 시뮬레이션 작업 세트를 벤치마크라 하고, 로봇 조작 쪽에서는 LIBERO, CALVIN, RoboCasa 가 널리 쓰입니다.
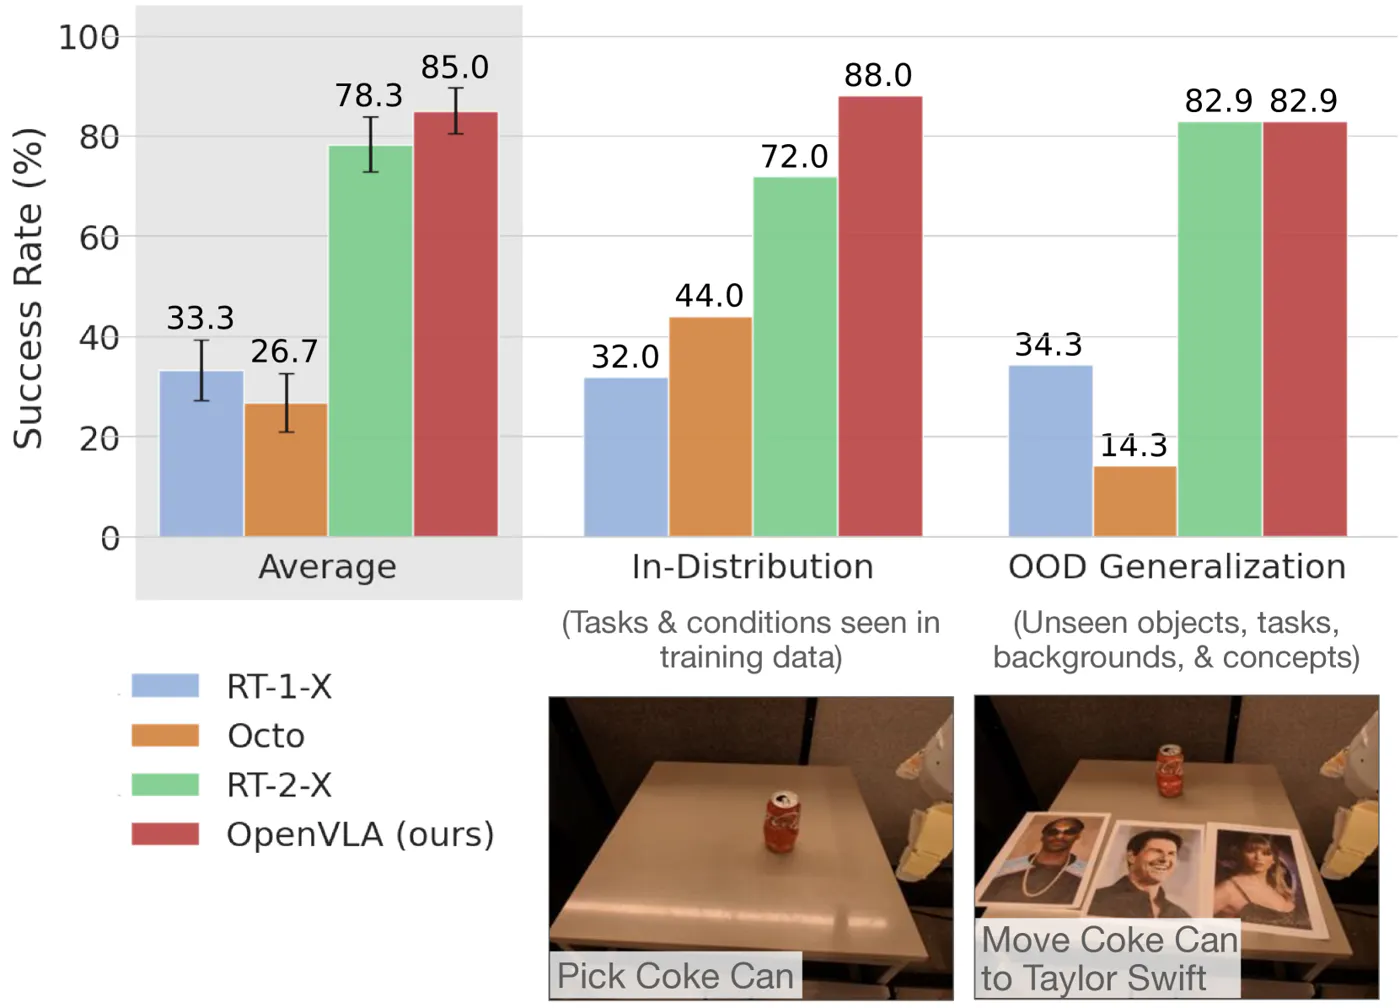
출처: Kim et al. (OpenVLA), arXiv:2406.09246 Fig. 3 · CC BY 4.0
성공률 하나로 끝나지 않습니다. 위 그래프의 수치는 특정 로봇·특정 과제·특정 환경에서 잰 값입니다. 연구자가 정말 궁금한 것은 이 policy 가 처음 보는 물체·처음 보는 배치·다른 로봇 에서도 되는가이고, 그래서 성능은 여러 환경 × 여러 embodiment 의 교차검증으로 읽습니다. 학습하지 않은 작업에서의 성능(zero-shot)이 그 기준입니다.
| 환경 | 물리 엔진 | 주 용도 |
|---|---|---|
| Isaac Sim / Isaac Lab | NVIDIA PhysX | 4족·휴머노이드 강화학습, 최대 4,096 환경 동시 |
| LIBERO | MuJoCo | 조작 벤치마크 (spatial / object / goal) |
| RoboCasa | robosuite (MuJoCo) | 테이블탑 조작 policy 평가 |
| MuJoCo 단독 | MuJoCo | 경량 물리, 빠른 반복 실험 |
학습 데이터는 어디서 — GPU 병렬 시뮬레이션
로봇 데이터를 대량으로 얻는 가장 현실적인 방법은 시뮬레이션입니다. Isaac Lab 같은 도구는 같은 로봇 수천 개를 GPU 한 장에서 동시에 실행해 강화학습 데이터를 대량으로 만듭니다. 공개 연구에 따르면 워크스테이션 GPU 한 장에서 4,096개 환경을 병렬로 돌려 4족 로봇의 평지 보행 정책을 4분 미만, 험지 정책을 약 20분에 학습합니다.
근거: Rudin et al., arXiv:2109.11978
시뮬레이션의 함정 — sim-to-real gap
시뮬레이션에서 90% 성공하던 정책이 실제 로봇에서 30% 로 떨어지는 일이 흔합니다. 이 격차가 sim-to-real gap 입니다. 성격이 다른 두 갭이 겹친 것이라, 나눠서 봐야 고칠 곳이 보입니다.
| 갭 | 무엇이 다른가 | 증상 | 잘 듣는 처방 |
|---|---|---|---|
| perception gap — 보이는 것 | 렌더링·조명·질감·센서 잡음이 실제 카메라와 다름. 시뮬레이션 이미지가 너무 깨끗함 | 실제 조명·배경에서 물체를 못 알아봄 | domain randomization · transfer learning |
| action-dynamics gap — 움직이는 것 | 마찰·질량·접촉·구동기 지연 같은 물리가 다름 | 인지는 맞는데 잡다가 미끄러지거나 타이밍이 어긋남 | calibration · domain randomization |
한 가지 더 있습니다. 물리가 똑같아도, 정책에 입력을 넣고 출력을 꺼내는 파이프라인 이 시뮬레이션과 다르면 실패합니다.
정책은 시뮬레이션에서 정해진 형식의 숫자만 알아듣습니다. 실물 로봇 코드가 그 형식을 조금이라도 다르게 만들면, 정책은 차이를 알 방법이 없어 엉뚱한 명령을 내고 로봇은 넘어집니다.
| 형식 | 학습 데이터의 약속 | 실물 코드가 어긋난 예 |
|---|---|---|
| 단위 | 관절 각도는 라디안 | 도(°)로 넣음 |
| 관절 값 배치 | 1번 칸 = 왼쪽 고관절, 2번 칸 = 왼쪽 무릎, … | 1번 칸에 오른쪽 고관절 값을 넣음 |
| 과거 길이 | 최근 6번의 관측을 이어 붙임 | 5번만 붙임 |
| 출력 배율 | 신경망 출력 × 0.25 = 관절 목표 | × 0.5 |
그래서 배포 전에 시뮬레이션 코드와 실물 코드의 관측·행동 형식이 같은지부터 맞춥니다. 배포 실패의 다수가 알고리즘이 아니라 여기서 옵니다.
요약
- 로봇 두뇌는 다섯 질문의 조합입니다. 어디서 배우나(foundation model), 무엇을 예측하나(행동 · 세계 · 둘 다), 뇌를 몇 개로 나누나(System 1/2), 행동 전에 말로 생각하나(ECoT), 행동 숫자를 어떻게 뽑나(action head).
- "VLA 와 diffusion policy" 는 경쟁 관계가 아닙니다. VLA 는 ①②의 답, diffusion / flow matching 은 ⑤의 답입니다.
- 데이터는 GPU 병렬 시뮬레이션에서 나오고, 그 대가가 sim-to-real gap 입니다. 보이는 것의 갭과 움직이는 것의 갭은 처방이 다릅니다.
다음 편에서는 범용 모델을 내 로봇에 적용하는 fine-tuning 에 대한 이야기입니다.