들어가며
12편 Diffusion Policy는 행동 16걸음을 한 번에 생성하고 그중 8걸음을 실행하는 방식으로 로봇 동작을 매끄럽게 만들었습니다. 13편은 비슷한 시기에 같은 방향의 설계를 다른 이름으로 제안한 논문입니다. 이 논문은 행동을 여러 걸음씩 묶어 예측하는 방식을 행동 묶음 예측(action chunking) 이라고 부르고, 이 이름이 이후 VLA 논문에서 그대로 쓰입니다.
논문은 시판 로봇 팔과 3D 프린트 부품으로 약 2만 달러짜리 양팔 원격조작 장치 ALOHA 를 만들고, 이 장치로 모은 시연을 학습하는 모방 학습 알고리즘 ACT(Action Chunking with Transformers) 를 제안합니다. 과제는 투명한 지퍼백 열기, 리모컨에 배터리 끼우기, 소스 컵 뚜껑 따기처럼 몇 밀리미터 오차로 실패하는 정밀 양팔 조작입니다.
📄 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware — Tony Z. Zhao, Vikash Kumar, Sergey Levine, Chelsea Finn / Stanford University·Meta·UC Berkeley, 2023-04 arxiv 공개
하드웨어 조립 설명서, 소프트웨어, 과제 영상은 프로젝트 페이지 tonyzhaozh.github.io/aloha에 공개돼 있습니다. arxiv 식별자는 2304.13705입니다.
초록 요약
케이블 타이 끼우기나 배터리 끼우기 같은 정밀 조작은 정확한 위치 결정, 접촉하는 힘의 조절, 카메라 영상을 계속 보며 동작을 고치는 닫힌 루프 제어가 함께 필요합니다. 보통은 비싼 로봇, 정밀한 센서, 꼼꼼한 보정으로 이런 과제를 풉니다. 저자들은 값싸고 덜 정밀한 하드웨어로도 학습을 통해 같은 과제를 해낼 수 있는지를 묻습니다.
저자들은 직접 만든 원격조작 장치로 실제 시연을 모으고, 카메라 영상에서 곧바로 행동을 내는 종단간(end-to-end) 모방 학습 시스템을 만듭니다. 정밀 조작의 모방 학습에는 두 가지 어려움이 있습니다. 정책의 작은 오차가 시간이 지나며 쌓이고, 사람 시연은 같은 상황에서도 매번 조금씩 다릅니다. ACT는 행동열 전체에 대한 생성 모델을 학습해 이 두 문제를 다룹니다. 그 결과 실제 로봇이 어려운 과제 6개를 학습했고, 그중 반투명 소스 컵 뚜껑 열기와 배터리 끼우기는 10분 분량의 시연만으로 80–90% 성공률을 냈습니다.

그림 1 — 왼쪽: 사람이 작은 로봇(리더)을 손으로 움직이면 큰 로봇(팔로워)이 같은 관절 각도로 따라 움직입니다. 오른쪽: 원격조작과 학습한 정책으로 수행한 정밀·접촉·동적 과제 예시.
1. 배경 — 정밀 조작과 행동 복제의 오차 누적
정밀 조작의 예
소스 컵 뚜껑 열기를 순서대로 보면 정밀 조작의 성격이 드러납니다. 컵은 탁자 위에 똑바로 서 있습니다. 오른쪽 집게가 컵 가장자리를 가볍게 쳐서 넘어뜨리고, 넘어진 컵을 벌려 둔 왼쪽 집게 안으로 밀어 넣습니다. 왼쪽 집게가 살살 닫혀 컵을 들어 올리면, 오른쪽 손가락 하나가 아래에서 다가가 뚜껑을 들어 올립니다. 단계마다 밀리미터 단위로 위치가 맞아야 하고, 컵과 뚜껑은 반투명해 카메라로 위치를 보기도 어렵습니다.
이런 과제에서 컵이 넘어진 뒤 어디로 굴러갈지, 뚜껑이 어떻게 휘어질지를 물리 모델로 정확히 계산하기는 매우 어렵습니다. 반면 "컵이 지금 보이는 자리에 따라 손을 옮긴다"는 정책은 컵의 움직임을 미리 계산하지 않고 영상을 보며 바로 반응하면 됩니다. 저자들이 카메라 영상에서 행동을 바로 내는 정책을 학습하기로 한 이유가 이 차이입니다.
행동 복제와 오차 누적
정책은 행동 복제(behavior cloning) 로 학습합니다. 시연에서 "이 관측을 봤을 때 사람이 한 행동"의 짝을 모아 지도 학습하는 방식으로, 6편 BC-Z와 12편 Diffusion Policy도 같은 틀입니다.
행동 복제의 대표적인 약점은 오차 누적(compounding error) 입니다. 1. 정책이 시연과 아주 조금 다른 행동을 냅니다.
2. 로봇이 시연에 한 번도 나오지 않은 자세에 놓입니다.
3. 학습 때 본 적 없는 관측이라 다음 행동도 조금 더 어긋납니다.
4. 이 어긋남이 걸음마다 더해져 로봇이 과제를 이어 갈 수 없는 상태에 이릅니다.
ALOHA는 초당 50번 행동을 냅니다. 8–14초짜리 과제면 한 에피소드에 행동 결정이 400–700번 들어가고, 결정 하나하나가 위 과정의 출발점이 될 수 있습니다. 정밀 조작은 허용 오차가 몇 밀리미터라서 이 누적에 특히 약합니다.
기존 해법의 한계
| 방식 | 대표 방법 | 한계 |
|---|---|---|
| 전문가가 정책 실행 중 개입해 수정 데이터 추가 | DAgger 계열 | 원격조작 장치로 수정하기가 시간이 많이 들고 부자연스러움 |
| 시연 수집 중 잡음을 섞어 복구 동작을 담음 | DART | 정밀 조작에서는 섞은 잡음 자체가 과제 실패로 이어짐 |
| 오프라인에서 합성 수정 데이터 생성 | 선행 연구들 | 저차원 상태가 주어지는 환경이나 쥐기 같은 특정 과제에 한정 |
저자들은 고차원 카메라 영상과 함께 쓸 수 있는 방법으로, 행동을 한 걸음씩이 아니라 여러 걸음씩 예측해 결정 횟수 자체를 줄이는 방향을 택합니다.
2. ALOHA — 저가 양팔 원격조작 장치
설계 원칙
| 원칙 | 내용 |
|---|---|
| 저가 | 대부분의 로봇 연구실 예산 안, 산업용 로봇 팔 한 대 수준 |
| 범용 | 실제 물체를 쓰는 다양한 정밀 조작에 적용 |
| 사용 편의 | 직관적이고 믿을 만하며 쓰기 쉬움 |
| 수리 용이 | 고장 나면 연구자가 직접 고칠 수 있음 |
| 조립 용이 | 구하기 쉬운 재료로 빠르게 조립 |
로봇과 집게
로봇은 Trossen Robotics의 ViperX 6자유도 팔 두 대입니다. 가격, 수리, 조립 원칙 때문에 다섯 손가락 로봇 손 대신 두 손가락 평행 집게를 씁니다.
| 항목 | 값 |
|---|---|
| 작업 하중 | 750 g |
| 팔을 편 길이 | 1.5 m |
| 위치 정확도 | 5–8 mm |
| 가격 | 약 5600달러 |
| 모터 | Dynamixel (고장 시 개별 교체) |
위치 정확도 5–8 mm가 이 논문의 전제입니다. 로봇 자체의 오차가 과제 허용 오차보다 크므로, 로봇은 카메라 영상을 보고 스스로 오차를 고치며 움직여야 합니다.
기본 제공 손가락은 정밀 조작에 맞지 않아, 가운데가 뚫린 3D 프린트 손가락을 새로 만들고 미끄럼 방지 테이프를 붙였습니다. 손가락 사이로 물체가 보이므로 섬세한 동작을 할 때 시야가 가려지지 않고, 얇은 비닐도 단단히 쥘 수 있습니다.
관절 공간 대응 원격조작
사람의 손 위치를 VR 컨트롤러나 카메라로 읽어 로봇 끝 위치로 옮기는 방식을 작업 공간 대응(task-space mapping) 이라고 합니다. ALOHA는 이 방식을 쓰지 않고, 같은 회사의 더 작은 로봇 팔 WidowX(약 3300달러)를 사람이 직접 손으로 움직입니다. 이 작은 로봇을 리더(leader), 큰 ViperX를 팔로워(follower) 라고 부르고, 리더의 관절 각도를 팔로워에 그대로 전달합니다. 이것이 관절 공간 대응(joint-space mapping) 입니다.
두 로봇은 크기만 다르고 관절 구조가 거의 같으므로, 리더의 관절 6개 각도를 읽어 팔로워의 관절 6개에 같은 각도를 명령하므로 역기구학 계산이 필요 없습니다. 저자들이 개발 중에 확인한 장점은 두 가지입니다.
| 장점 | 이유 |
|---|---|
| 특이점 근처에서도 동작 | 정밀 조작은 로봇이 특이점(singularity), 곧 특정 방향으로 움직일 수 없는 자세 근처에서 자주 일어남. 여유 자유도가 없는 6자유도 팔에서는 시판 역기구학 풀이가 이 근처에서 자주 실패하지만, 관절 각도를 그대로 옮기면 역기구학 계산 자체가 없어 관절 한계 안에서 늘 동작하고 계산량과 지연도 줄어듦 |
| 손떨림 감쇠 | 리더 로봇의 무게 때문에 사람이 너무 빨리 움직일 수 없고 작은 떨림이 줄어듦. VR 컨트롤러를 들고 할 때보다 정밀 과제 성능이 좋았음 |
조작 편의를 위해 두 가지를 더했습니다. 리더 로봇에 끼우는 3D 프린트 "손잡이와 가위" 기구는 모터를 손으로 돌리는 데 드는 힘을 줄이고, 집게를 열고 닫는 두 값이 아니라 연속으로 조절하게 해 줍니다. 고무줄 하중 보상 기구는 리더 쪽 중력을 일부 상쇄해 30분이 넘는 원격조작 세션을 가능하게 합니다.

그림 2 — 왼쪽: 정면·위·양 손목 카메라의 시점과 양팔 작업 공간. 가운데: 손잡이와 가위 기구, 가운데가 뚫린 집게. 오른쪽: ViperX 6자유도 로봇 사양.
카메라와 주기
로봇 틀은 20 × 20 mm 알루미늄 프로파일에 강철 케이블을 교차로 걸어 보강했습니다. 카메라는 Logitech C922x 웹캠 4대로, 각각 480 × 640 색 영상을 보냅니다. 두 대는 팔로워 손목에 달려 집게 주변을 가까이서 보고, 나머지 두 대는 정면과 위에 고정됩니다. 원격조작과 데이터 기록은 50 Hz로 합니다.
부록 B는 카메라가 초당 30장으로 영상을 보낸다고 적습니다. 제어와 기록 주기 50 Hz보다 낮은 값인데, 논문은 두 주기를 어떻게 맞췄는지 따로 설명하지 않습니다.
비용과 원격조작 능력
ViperX 두 대와 WidowX 두 대의 가격을 더하면 17800달러입니다. 부록 A는 ALOHA 전체를 18000달러, 카메라 같은 선택 부품을 더하면 20000달러로 적습니다.
| 시스템 | 구성 | 추정 비용 (논문 기준) |
|---|---|---|
| DexPilot | 보정한 Intel Realsense 4대 + Allegro 손 + KUKA LBR iiwa7 R800, 팔·손 1세트 | 약 10만 달러 |
| Robotic Telekinesis 계열 | 색 카메라 1대로 손 자세 추정, 팔·손 1세트 | 약 1만 8천 달러 |
| Shadow Teleoperation System | 양손 로봇 손 2개를 UR10에 장착, 추적·촉각 장갑 | 최소 40만 달러 |
| ALOHA | 양팔 평행 집게 | 1만 8천 달러 (카메라 등 포함 2만 달러) |
저자들은 가장 능력이 좋은 Shadow Teleoperation System의 시연 영상 3개에서 사용 사례 15개를 찾아 ALOHA로 재현했습니다. 비어 퐁, 젠가, 루빅스 큐브, 쓰레받기와 빗자루, 물병 뚜껑 돌려 열기, 액체 따르기, 벨크로 케이블 타이 풀기, 달걀과 전구 집기, USB·RJ45 꽂고 뽑기, 피펫 쓰기, 글씨 쓰기, 알루미늄 케이스 돌려 열기, 손안에서 바오딩 공 돌리기입니다. 이 가운데 14개를 비슷한 물체와 비슷한 시간으로 재현했고, 손이 없는 ALOHA로는 바오딩 공 돌리기만 하지 못했습니다.

그림 8 — ALOHA로 원격조작한 과제 예시. 물체는 모두 실제 생활용품을 고치지 않고 그대로 썼습니다.
원격조작으로 가능한 과제는 세 부류로 나뉩니다. 케이블 타이 끼우기, 지갑에서 카드 꺼내기, 지퍼백 열고 닫기 같은 정밀 과제, 288핀 RAM을 메인보드에 꽂기, 책장 넘기기, NIST 조립 보드 #2의 체인과 벨트 조립 같은 접촉 과제, 탁구채로 공 튀기기, 공을 채 위에 올려 균형 잡기, 비닐봉지를 공중에서 휘둘러 펼치기 같은 동적 과제입니다. 저자들은 케이블 타이 끼우기, RAM 꽂기, 탁구공 튀기기가 예산이 5–10배인 기존 원격조작 시스템에서도 보고되지 않은 기술이라고 적습니다.
3. 행동 묶음 예측
학습 데이터의 관측과 행동
ACT를 학습하기 전에 관측과 행동이 무엇인지부터 정해 둡니다.
| 항목 | 내용 | 크기 |
|---|---|---|
| 관측 — 영상 | 카메라 4대의 현재 색 영상 | 4 × 480 × 640 × 3 |
| 관측 — 관절 | 팔로워 두 대의 현재 관절 위치 (팔 한 대당 관절 6개 + 집게 1개) | 14 |
| 행동 | 다음 시점에 두 팔이 가야 할 목표 관절 위치 | 14 |
행동으로는 팔로워가 아니라 리더의 관절 위치 를 기록합니다. 팔로워 모터 안의 PID 제어기가 리더 각도를 따라가는데, 리더와 팔로워 각도의 차이가 곧 모터가 내는 힘의 크기를 정합니다. 팔로워 각도만 기록하면 물체를 얼마나 세게 누르고 있었는지가 데이터에서 사라집니다. 행동을 이전 위치 대비 변화량이 아니라 목표 위치 자체로 둔 것도 저자들이 실험으로 고른 설계로, 변화량을 쓰면 성능이 떨어졌다고 적습니다.
한 걸음 예측과 묶음 예측
일반적인 정책은 현재 상태 를 보고 행동 하나 를 냅니다. 행동 묶음 예측 정책은 현재 상태를 보고 앞으로 걸음의 행동 를 한 번에 냅니다.
행동 하나가 숫자 14개이므로, 묶음 크기 이면 정책은 한 번에 개의 숫자를 냅니다.
| 걸음 | 왼팔 관절 1 | 왼팔 관절 2 | … | 오른팔 집게 |
|---|---|---|---|---|
| 0.021 | −0.874 | … | 0.63 | |
| 0.023 | −0.871 | … | 0.63 | |
| … | … | … | … | … |
| 0.140 | −0.612 | … | 0.18 |
표의 숫자는 행동 묶음의 모양을 보여 주기 위한 임의의 예시 값입니다. 실제 표는 100줄 × 14칸입니다.
이름은 심리학·신경과학의 행동 묶음(action chunking) 개념에서 왔습니다. 사람이 여러 개별 동작을 한 단위로 묶어 기억하고 한 번에 실행한다는 개념입니다. 로봇 과제로 옮기면 "사탕 포장지 모서리 잡기"나 "배터리를 홈에 밀어 넣기"가 묶음 하나에 해당합니다.
결정 횟수의 감소
가장 단순한 구현은 걸음마다 관측을 한 번 받고, 행동 개를 만든 뒤 순서대로 실행하는 것입니다.
| 시점 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|---|
| 정책 호출 | 관측 → 행동 0–3 생성 | 관측 → 행동 4–7 생성 | ||||||
| 실행하는 행동 | 0번 | 1번 | 2번 | 3번 | 4번 | 5번 | 6번 | 7번 |
그림 4 윗줄과 같은 설정을 표로 옮긴 것입니다.
이렇게 하면 정책이 결정을 내리는 횟수가 분의 1로 줄어듭니다. 논문은 이것을 과제의 실효 구간(effective horizon) 이 배 줄어든다고 표현합니다. 예를 들어 500걸음짜리 에피소드에서 이면 정책 호출은 5번이고, 1절의 오차 누적 과정이 시작될 수 있는 지점도 500곳에서 5곳으로 줄어듭니다(계산한 값).
시연 속 멈춤의 표현
묶음 예측에는 다른 효과도 있습니다. 사람 시연에는 동작 도중 잠깐 멈추는 구간이 있습니다. 현재 상태만 보고 한 걸음을 내는 정책은 같은 자세에서 "멈춘다"와 "움직인다"를 둘 다 본 셈이라, 언제 멈춤을 끝낼지 알 수 없습니다. 멈춤이 계속될지는 자세가 아니라 멈춘 지 얼마나 지났는지에 달려 있기 때문입니다. 이렇게 현재 상태만으로 결정되지 않는 행동을 비마르코프(non-Markovian) 행동이라고 합니다.
묶음 안에서는 "3걸음 멈춘 뒤 움직인다"가 행동열 하나로 함께 학습되므로, 멈춤이 한 묶음 안에 들어가는 한 이 문제가 줄어듭니다. 과거 관측 여러 장을 입력으로 넣어도 같은 효과를 노릴 수 있지만, 그 방식은 모델이 과거 관측의 우연한 특징을 행동의 원인으로 오해하는 인과 혼동(causal confusion) 문제를 새로 만든다고 저자들은 적습니다.
4. 시간 앙상블
매 걸음 호출과 겹치는 묶음
걸음마다 한 번씩만 관측을 받으면, 새 관측이 걸음마다 한꺼번에 반영돼 묶음이 바뀌는 순간 로봇 동작이 끊깁니다. 저자들은 정책을 매 걸음 호출해서 이 문제를 풉니다. 그러면 서로 다른 시점에 만든 묶음이 겹쳐, 같은 시점의 행동이 여러 개 생깁니다.
| 시점 3의 행동을 만든 호출 | 그 호출에서 시점 3은 몇 번째 행동인가 | 오래된 순서 |
|---|---|---|
| 시점 0의 호출 | 4번째 | 0 (가장 오래됨) |
| 시점 1의 호출 | 3번째 | 1 |
| 시점 2의 호출 | 2번째 | 2 |
| 시점 3의 호출 | 1번째 | 3 (가장 새로움) |
일 때 시점 3에 겹치는 예측 4개. 그림 4 아랫줄의 굵은 세로 칸과 같은 구성입니다.
시간 앙상블(temporal ensembling) 은 같은 시점에 대한 이 예측들을 가중 평균해 실제로 실행할 행동 하나를 정합니다. 가중치는 지수 함수입니다.
는 시점 에 대해 번째로 오래된 예측이고, 이 가장 오래된 예측의 가중치입니다. 이 클수록 오래된 예측의 몫이 커지고, 이 작을수록 가중치가 고르게 퍼져 새 예측이 빨리 반영됩니다.
가중치 계산 예시
아래 표는 시점 3의 왼팔 관절 1에 대해 네 호출이 각각 0.50, 0.52, 0.55, 0.60(오래된 것부터)을 예측했을 때 두 가지 으로 실행할 행동을 계산한 것입니다.
| 합으로 나눈 가중치 | 실행하는 행동 | ||
|---|---|---|---|
| 0.01 | 1.000, 0.990, 0.980, 0.970 | 0.254, 0.251, 0.249, 0.246 | 0.542 |
| 0.5 | 1.000, 0.607, 0.368, 0.223 | 0.455, 0.276, 0.167, 0.102 | 0.524 |
예측값 0.50–0.60은 임의의 예시 값이고, 가중치와 결과는 그 값으로 계산한 값입니다.
에서는 가장 오래된 예측 0.50의 몫이 절반 가까이라 결과가 0.524로 오래된 예측 쪽에 가깝고, 에서는 네 예측이 거의 같은 몫이라 새 예측 0.60이 더 반영된 0.542가 됩니다. 논문은 실험에 쓴 값을 적지 않았습니다. 저자들의 공개 코드에서는 이 값이 0.01로 들어가 있습니다.
그림 4의 예시는 가중치를 [0.5, 0.3, 0.2, 0.1]로 적어 모양을 보여 줍니다. 이 네 값은 합이 1.1이라, 식에 따라 합으로 나눠 쓰는 설명용 값으로 읽어야 합니다.
일반 평활화와의 차이
흔한 평활화는 이번 행동을 앞뒤 시점의 행동과 평균해, 원래 가야 할 위치에서 벗어나는 치우침이 생깁니다. 시간 앙상블은 같은 시점을 겨냥한 예측끼리만 평균하므로 이런 치우침이 없습니다. 추가 학습 비용도 없고, 매 걸음 정책을 호출하는 추론 계산만 늘어납니다. ACT 모델의 추론은 약 0.01초라 50 Hz 제어 주기 0.02초 안에 들어갑니다.
알고리즘 2 — ACT 추론
입력: 학습한 정책 π_θ, 에피소드 길이 T, 가중치 계수 m
시점별 FIFO 버퍼 B[0:T]를 준비 (B[t]에는 시점 t에 대한 예측들이 쌓임)
for t = 1, 2, ..., T:
    z = 0 으로 두고 π_θ(â_{t:t+k} | o_t, z)로 행동 묶음 예측
    예측한 행동들을 버퍼 B[t:t+k]에 시점별로 추가
    A_t = B[t]  (시점 t에 대한 예측 전부)
    a_t = Σ_i w_i A_t[i] / Σ_i w_i,  w_i = exp(-m·i) 를 실행
5. 조건부 VAE로 사람 시연 학습
사람 시연의 흔들림
사람은 같은 관측에서도 매번 다른 궤적으로 과제를 풉니다. 정밀도가 덜 중요한 구간일수록 궤적의 차이가 더 큽니다. 테이프 조각을 공중에서 건네는 동작을 예로 들면, 건네는 위치는 에피소드마다 다릅니다. 사람에게 그 위치를 맞출 시각적·촉각적 기준이 없기 때문입니다. 이 과제에서 정책이 배워야 하는 것은 "건네는 정확한 위치"가 아니라 "두 집게가 부딪히지 않고, 왼쪽 집게는 늘 테이프를 잡을 수 있는 자리로 간다"는 규칙입니다.
한 사람이 모든 시연을 모아도 이런 흔들림은 남습니다. 저자들은 정책을 생성 모델로 학습해 정밀도가 중요한 구간에 집중하게 만듭니다.
조건부 VAE의 구성
생성 모델로는 조건부 변분 오토인코더(Conditional Variational AutoEncoder, CVAE) 를 씁니다. 구성 요소는 둘입니다.
| 구성 요소 | 입력 | 출력 | 쓰는 때 |
|---|---|---|---|
| CVAE 인코더 | 현재 관절 위치 + 시연의 행동 묶음 | 스타일 변수 분포의 평균과 분산 | 학습 때만 |
| CVAE 디코더 (= 정책) | 현재 영상 4장 + 관절 위치 + | 예측 행동 묶음 | 학습·배포 모두 |
스타일 변수(style variable) 는 32차원 벡터로(부록 그림 10), "이 시연이 어떤 방식으로 움직였는가"를 담습니다. 학습 중에 인코더는 정답 행동 묶음을 보고 를 만들고, 디코더는 영상과 를 함께 받아 그 행동 묶음을 복원합니다. 같은 장면에서 시연자가 A 방식과 B 방식을 섞어 썼다면, 인코더가 방식의 차이를 에 담으므로 디코더는 두 방식을 평균 낸 어중간한 행동을 배울 필요가 없습니다.
인코더 입력에서 영상은 뺐습니다. 학습을 빠르게 하려는 선택으로, 인코더는 관절 위치와 행동 묶음만 봅니다.
배포할 때는 정답 행동이 없으므로 인코더를 버리고 를 사전 분포의 평균인 영벡터 로 둡니다. 그러면 같은 관측에 늘 같은 행동 묶음이 나오고, 저자들은 이 결정론적 출력이 정책 평가에도 유리하다고 적습니다.
손실 함수
학습 목표는 시연 행동 묶음의 로그 가능도를 최대화하는 것이고, 표준 VAE 목적 함수의 두 항으로 구현합니다.
| 항 | 뜻 |
|---|---|
| 디코더가 복원한 행동 묶음과 시연 행동 묶음의 차이 | |
| 인코더가 만든 분포가 표준 정규 분포에서 얼마나 벗어났는지 (KL 발산) | |
| 두 번째 항의 가중치. 클수록 에 담기는 정보가 줄어듦. 실험 값 10 | |
| 영상을 뺀 관측, 곧 관절 위치 |
두 번째 항 덕분에 배포 때 으로 둬도 학습 때 본 분포의 한가운데라 디코더가 정상적인 행동을 냅니다.
복원 항은 흔히 쓰는 L2(평균제곱오차) 대신 L1 손실을 씁니다. 저자들은 L1이 행동열을 더 정밀하게 모델링했다고 적습니다. L2는 오차를 제곱해 더하므로 큰 오차 몇 개가 손실의 대부분을 차지하고, L1은 오차 크기를 그대로 더합니다.
알고리즘 1 — ACT 학습
입력: 시연 데이터셋 D, 묶음 크기 k, 가중치 β
o_t: 시점 t의 관측, a_t: 행동, ō_t: 영상을 뺀 관측
인코더 q_φ(z | a_{t:t+k}, ō_t), 디코더 π_θ(â_{t:t+k} | o_t, z) 초기화
for n = 1, 2, ...:
    D에서 o_t, a_{t:t+k} 표본 추출
    q_φ(z | a_{t:t+k}, ō_t)에서 z 표본 추출
    π_θ(â_{t:t+k} | o_t, z)로 â_{t:t+k} 예측
    L_reconst = 복원 손실(â_{t:t+k}, a_{t:t+k})
    L_reg = D_KL(q_φ(z | a_{t:t+k}, ō_t) || N(0, I))
    L = L_reconst + β·L_reg 로 θ, φ를 ADAM 갱신
논문의 알고리즘 1은 복원 손실을 MSE(L2)로 적었지만, 4-C절 본문은 L1을 썼다고 적고 저자들의 공개 코드도 L1 손실을 계산합니다. 위 알고리즘은 본문을 따라 "복원 손실"로 적었고, 실제로 쓴 손실은 L1입니다.
6. 모델 구조
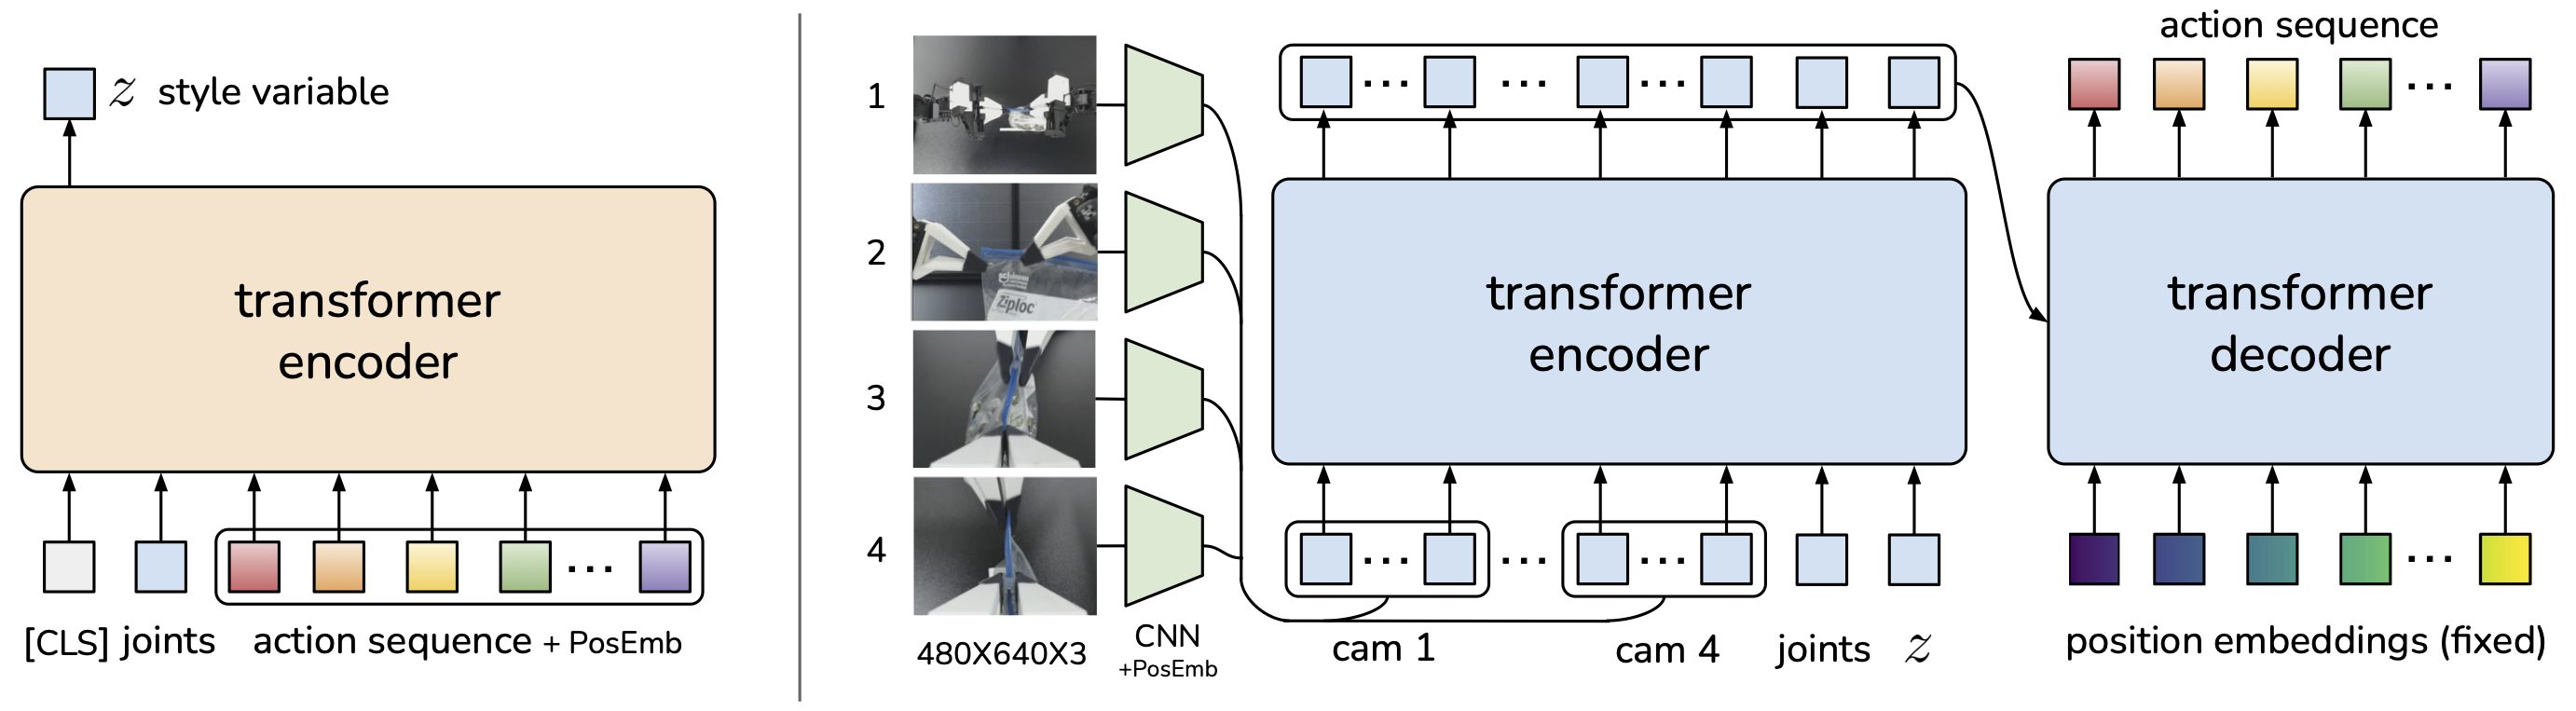
그림 3 — 왼쪽: 관절 위치와 행동 묶음을 받아 스타일 변수 z를 만드는 CVAE 인코더(배포 때 버림). 오른쪽: 영상 4장·관절·z를 합치는 Transformer 인코더와 행동 묶음을 내는 Transformer 디코더.
인코더와 디코더를 모두 Transformer로 만든 이유는 Transformer가 여러 입력을 한 열로 합쳐 처리하는 일과 새 열을 생성하는 일에 모두 맞기 때문입니다. 1편 Transformer의 부호기·복호기 구조를 그대로 가져왔고, 영상 특징에 위치 정보를 더하는 방식은 물체 검출 모델 DETR을 따릅니다.
CVAE 인코더
CVAE 인코더는 BERT처럼 입력열 맨 앞에 학습하는 [CLS] 토큰 을 붙인 Transformer 인코더입니다.
| 입력 위치 | 내용 | 원래 크기 → 임베딩 크기 |
|---|---|---|
| 1 | [CLS] 토큰 (무작위 초기화 후 학습) | 512 |
| 2 | 관절 위치 | 14 → 512 (선형층) |
| 3 … | 행동 묶음 개, 사인파 위치 임베딩 더함 | 14 → 512 (선형층) |
입력열 길이는 로, 이면 102입니다. Transformer를 통과한 출력 중 [CLS] 자리의 벡터 하나만 꺼내 선형층에 넣어 분포의 평균과 분산을 얻고, 재매개변수화(reparameterization) 로 를 뽑습니다. 재매개변수화는 를 "평균 + 표준편차 × 표준 정규 잡음"으로 계산해, 표본 추출 과정을 거쳐서도 기울기가 인코더까지 전달되게 하는 표준 기법입니다.
CVAE 디코더 (정책)
아래 도식은 정책의 입력에서 출력까지 텐서 크기를 따라간 것입니다.
| 단계 | 계산 | 크기 |
|---|---|---|
| ResNet18 | 480 × 640 영상을 가로세로 각각 32분의 1로 줄이고 채널 512개 | 15 × 20 × 512 |
| 펼치기 | 15 × 20 = 300칸을 한 줄로 | 300 × 512 |
| 위치 정보 | 각 칸의 원래 가로·세로 위치를 사인파 값으로 만들어 더함 | 300 × 512 |
| 카메라 4대 이어 붙이기 | 300 × 4 | 1200 × 512 |
| 관절 위치· 추가 | 선형층으로 각각 512차원으로 바꿔 뒤에 붙임 | 1202 × 512 |
| Transformer 인코더 | 카메라 4대의 영상 칸, 관절, 가 서로를 참고 | 1202 × 512 |
| Transformer 디코더 | 고정 위치 임베딩 개가 질의, 인코더 출력이 키·값 | × 512 |
| MLP | 512차원 → 14차원 | × 14 |
영상 칸을 펼치면 "어느 칸이 영상의 어디였는지"가 사라지므로 2D 사인파 위치 임베딩을 더합니다. 1편의 위치 부호화를 가로·세로 두 방향으로 만든 것입니다. 디코더의 질의로 들어가는 고정 위치 임베딩 개는 "묶음 안의 1번째 행동, 2번째 행동, …"을 뜻하는 자리표이고, 디코더는 이 자리마다 인코더 출력을 교차 주의로 참고해 해당 걸음의 행동을 만듭니다.
Transformer 인코더는 여러 카메라 시점, 관절 위치, 스타일 변수의 정보를 합치고, Transformer 디코더는 그 결과로 앞뒤가 이어지는 행동열을 만듭니다.

그림 10 — 학습(데이터 추출 → z 추론 → 행동 묶음 예측)과 배포 때의 상세 구조. 배포 때는 노란색 CVAE 인코더를 쓰지 않습니다.
그림 10은 ResNet18 출력을 15 × 20 × 728로 적고 728 → 512 선형층을 그렸지만, 4-C절 본문은 15 × 20 × 512로 적습니다. ResNet18의 마지막 합성곱 층은 채널이 512개이고 저자들의 공개 코드도 512를 쓰므로, 이 글은 512로 적었습니다.
규모와 조절값
| 항목 | 값 |
|---|---|
| 파라미터 수 | 약 80M |
| 학습 | 과제마다 처음부터 학습, RTX 2080 Ti 11 GB 1장에서 약 5시간 |
| 추론 시간 | 같은 장비에서 약 0.01초 |
| 배포 체크포인트 | 검증 손실이 가장 낮은 것 |
| 조절값 | 값 |
|---|---|
| 학습률 | 1e-5 |
| 배치 크기 | 8 |
| 인코더 층 수 | 4 |
| 디코더 층 수 | 7 |
| 순방향 신경망 차원 | 3200 |
| 은닉 차원 | 512 |
| 주의 헤드 수 | 8 |
| 묶음 크기 | 100 |
| 10 | |
| 드롭아웃 | 0.1 |
표 III — ACT 조절값.
묶음 크기 100은 50 Hz에서 2초 분량입니다. 12편 Diffusion Policy는 10 Hz에서 16걸음(1.6초)을 생성했습니다. 비슷한 시간 길이를 ACT는 더 높은 제어 주기에서 더 많은 걸음으로 나눠 예측합니다.
7. 과제와 데이터
실물 과제 6개

그림 5 — 실물 과제 6개의 초기 배치(init.)와 하위 과제 단계(#1–#4).
| 과제 | 목표 | 하위 과제 |
|---|---|---|
| Slide Ziploc | 탁자에 선 지퍼백 열기. 왼팔이 봉지 몸통을 잡고 오른팔이 슬라이더를 집어 밀어 엶 | 잡기 → 집기 → 열기 |
| Slot Battery | 리모컨에 배터리 끼우기. 오른팔이 배터리를 홈에 놓고 손끝으로 가장자리를 눌러 넣는 동안, 스프링 반발로 리모컨이 밀리지 않게 왼팔이 누름 | 잡기 → 놓기 → 끼우기 |
| Open Cup | 반투명 소스 컵 뚜껑 열기. 컵을 넘어뜨려 왼쪽 집게로 밀어 넣고, 들어 올린 뒤 오른손가락으로 뚜껑을 들어 올림 | 넘어뜨리기 → 잡기 → 뚜껑 열기 |
| Thread Velcro | 벨크로 케이블 타이의 한쪽 끝을 다른 끝의 고리에 끼우기. 왼팔이 들고 오른팔이 공중에서 꼬리를 잡은 뒤 두 팔이 함께 끼움 | 들기 → 잡기 → 끼우기 |
| Prep Tape | 상자 가장자리에 테이프 조각 걸기. 오른팔이 테이프를 잘라 공중에서 왼팔에 건네고, 두 팔이 상자에 붙임 | 잡기 → 자르기 → 건네기 → 걸기 |
| Put On Shoe | 고정된 마네킹 발에 신발 신기고 벨크로 끈 붙이기 | 들기 → 끼우기 → 받치기 → 고정 |
하위 과제 이름은 표 I·II 열 이름(Grasp, Pinch, Open 등)을 옮긴 것입니다.
몇 과제의 치수를 보면 정밀도가 구체적으로 보입니다. Thread Velcro의 고리는 3 mm × 25 mm이고 케이블 타이는 위치에 따라 2 mm × 10–25 mm입니다. 첫 번째 잡기에서 몇 밀리미터만 어긋나도 공중의 두 번째 잡기에서 오차가 커져, 끼우는 단계에서는 10 mm 넘게 벗어납니다.
물체 인식도 어렵습니다. 지퍼백은 대부분 투명하고 얇은 파란 봉합선만 보이며, 봉지 주름과 안에 든 반짝이는 사탕 포장지가 배치할 때마다 달라집니다. 테이프와 소스 컵은 투명하거나 반투명해 깊이 카메라에도 맞지 않습니다. 검은 탁자 위의 검은 벨크로 타이와 검은 테이프 커터는 대비가 낮고, 위쪽 카메라에서 벨크로 타이는 영상의 아주 작은 부분만 차지합니다.
시뮬레이션 과제 2개

그림 6 — 왼쪽: 빨간 정육면체를 다른 팔에 건네는 Cube Transfer. 오른쪽: 빨간 막대를 파란 소켓에 공중에서 끼우는 Bimanual Insertion.
재현성을 위해 MuJoCo로 두 과제를 만들었습니다. Transfer Cube는 오른팔이 탁자의 빨간 정육면체를 집어 왼팔 집게 안에 넣는 과제로, 정육면체와 왼쪽 집게 사이 여유가 약 1 cm라 작은 오차에도 부딪혀 실패합니다. Bimanual Insertion은 왼팔이 소켓을, 오른팔이 막대를 집어 공중에서 막대가 소켓 안쪽 핀에 닿도록 끼우는 과제로, 끼우는 구간의 여유가 약 5 mm입니다.
초기 배치는 실물 과제에서 15 cm 흰 기준선을 따라, 시뮬레이션 과제에서 2차원 영역 안에서 무작위로 바꿉니다.
데이터 수집
| 항목 | 값 |
|---|---|
| 에피소드 길이 | 과제에 따라 8–14초 = 50 Hz에서 400–700걸음 |
| 실물 과제 시연 수 | 과제당 50개 (Thread Velcro만 100개) |
| 실물 과제 데이터 분량 | 과제당 약 10–20분 (초기화와 조작 실수 포함 실제 소요 30–60분) |
| 시뮬레이션 시연 | 과제마다 스크립트 정책 시연 50개 + 사람 시연 50개 (모두 성공 에피소드) |
| 시뮬레이션 사람 시연 방식 | ALOHA 리더 로봇으로 시뮬레이션 로봇을 조종하며 모니터의 실시간 화면을 봄 |
모든 시연은 한 사람이 모았지만 사람 시연은 본질적으로 매번 다릅니다. 스크립트 정책 시연은 같은 초기 배치에 늘 같은 궤적을 내므로, 시뮬레이션 과제에서 두 데이터를 비교하면 사람 시연의 흔들림이 성능에 주는 영향을 따로 볼 수 있습니다.
8. 비교 방법
| 방법 | 구조 | 행동 출력 | ACT와 다른 점 |
|---|---|---|---|
| BC-ConvMLP | 합성곱 신경망으로 현재 영상을 처리하고 관절 위치와 이어 붙여 행동 예측 | 연속 행동 1걸음 | 가장 단순하고 널리 쓰이는 기준선 |
| BeT | Transformer, 관측 이력을 보고 행동 1걸음 예측 | 구간 분류 + 구간 중심에서의 연속 보정값 | 묶음 예측 없음. 영상은 따로 학습해 고정한 시각 인코더로 처리해 인식과 제어를 함께 최적화하지 않음 |
| RT-1 | Transformer, 고정 길이 과거 관측으로 행동 1걸음 예측 | 구간 분류 | 묶음 예측 없음, 행동 이산화 |
| VINN | 비모수 방법. 새 관측과 시각 특징이 가장 비슷한 시연 관측 k개를 찾아 그 행동을 가중 평균 | 시연 행동 검색 | 배포 때 시연 데이터 전체가 필요 |
ACT는 이산화 없이 연속 행동을 바로 예측합니다. 정밀 조작에 필요한 해상도 때문입니다. VINN의 k(최근접 이웃 수)는 이 논문의 묶음 크기 와 다른 값입니다.
기준선의 조절값은 Cube Transfer로 맞췄습니다. BeT는 원 논문의 이력 길이 10을 100으로 늘리자 성능이 크게 올랐고, 은닉 차원을 키우는 것도 대체로 도움이 됐습니다.
| 방법 | 주요 조절값 |
|---|---|
| BYOL (VINN·BeT의 시각 특징 추출기) | 학습률 3e-4, 배치 128, 100 epoch, 모멘텀 0.9, 가중치 감쇠 1.5e-6 |
| BeT | 학습률 1e-4, 배치 64, 6층, 헤드 6, 은닉 768, 이력 100, 가중치 감쇠 0.1, 보정값 손실 배율 1000, focal loss γ 2, 드롭아웃 0.1, 구간 64개 |
| VINN | k 적응 선택(검증 손실 최소), 상태 가중치 0 또는 10 |
| RT-1 | 학습률 1e-5, 배치 2, 깊이 6, 헤드 8, 헤드 차원 64, 행동 구간 256개, 조건 드롭 확률 0.2, TokenLearner 출력 토큰 8, 가중치 감쇠 0, 이력 6, ViT 헤드 차원 32, ViT 창 7, MBConv 확장률 4·축소율 0.25, ViT 드롭아웃 0.1 |
표 IV–VII을 한 표로 모은 것입니다.
VINN은 묶음 예측이 없을 때 시각 특징 유사도에 관절 위치 차이를 더하면(상태 가중치 10) 성능이 올랐지만, 묶음 예측과 함께 쓰면 오히려 성능이 떨어져 그때는 상태 가중치를 0으로 뒀습니다.
9. 결과
시뮬레이션 2개와 실물 2개
시뮬레이션 과제는 무작위 시드 3개 × 시드당 평가 50회의 평균이고, 칸 안의 두 값은 [스크립트 시연으로 학습 | 사람 시연으로 학습]입니다. 실물 과제는 사람 시연으로 학습한 시드 1개를 25회 평가했습니다.
| 방법 | Cube Transfer (sim) 건드림 | 들어 올림 | 건넴 | Bimanual Insertion (sim) 잡기 | 접촉 | 끼움 |
|---|---|---|---|---|---|---|
| BC-ConvMLP | 34 | 3 | 17 | 1 | 1 | 0 | 5 | 0 | 1 | 0 | 1 | 0 |
| BeT | 60 | 16 | 51 | 13 | 27 | 1 | 21 | 0 | 4 | 0 | 3 | 0 |
| RT-1 | 44 | 4 | 33 | 2 | 2 | 0 | 2 | 0 | 0 | 0 | 1 | 0 |
| VINN | 13 | 17 | 9 | 11 | 3 | 0 | 6 | 0 | 1 | 0 | 1 | 0 |
| ACT | 97 | 82 | 90 | 60 | 86 | 50 | 93 | 76 | 90 | 66 | 32 | 20 |
| 방법 | Slide Ziploc (real) 잡기 | 집기 | 열기 | Slot Battery (real) 잡기 | 놓기 | 끼우기 |
|---|---|---|---|---|---|---|
| BC-ConvMLP | 0 | 0 | 0 | 0 | 0 | 0 |
| BeT | 8 | 0 | 0 | 4 | 0 | 0 |
| RT-1 | 4 | 0 | 0 | 4 | 0 | 0 |
| VINN | 28 | 0 | 0 | 20 | 0 | 0 |
| ACT | 92 | 96 | 88 | 100 | 100 | 96 |
표 I — 성공률(%). 두 표는 원문의 한 표를 과제 묶음별로 나눈 것입니다.
각 칸은 해당 하위 과제까지 성공한 비율이라, 오른쪽 열로 갈수록 값이 줄어드는 것이 보통입니다. Slide Ziploc에서 ACT의 "집기"(96)가 "잡기"(92)보다 높은 것은 원문 표의 값 그대로입니다.
시뮬레이션 네 조건(과제 2개 × 데이터 2종)에서 ACT의 최종 성공률은 가장 좋은 기존 방법보다 59%, 49%, 29%, 20% 높습니다. 표 I로 계산하면 Cube Transfer 스크립트 86−27(BeT), 사람 50−1(BeT), Insertion 스크립트 32−3(BeT), 사람 20−0으로 네 값 모두 일치합니다. 기존 방법들은 앞 두 하위 과제에서는 진전이 있지만 최종 성공률은 30% 아래에 머뭅니다. 실물 과제 Slide Ziploc과 Slot Battery에서 ACT의 최종 성공률은 88%와 96%이고, 다른 방법들은 첫 단계를 넘지 못했습니다.
저자들은 기존 방법의 낮은 성능을 오차 누적과 시연의 비마르코프 행동 탓으로 봅니다. 에피소드 끝으로 갈수록 동작이 크게 나빠지고, 특정 상태에서 로봇이 끝없이 멈춰 있기도 했습니다. 시뮬레이션에서는 모든 방법이 스크립트 시연보다 사람 시연으로 학습할 때 성능이 떨어졌습니다. 사람 시연의 무작위성과 여러 방식이 섞인 분포가 모방 학습을 어렵게 만들기 때문입니다.
나머지 실물 과제 3개
이 과제들은 지금까지 가장 성공률이 높았던 기준선 BeT와만 비교했습니다. 논문은 이 표를 "나머지 3개 과제"라고 부르지만, 표에는 Open Cup, Thread Velcro, Prep Tape, Put On Shoe 4개가 실려 있고 본문도 4개 결과를 모두 적습니다.
| 방법 | Open Cup 넘어뜨리기 | 잡기 | 뚜껑 열기 | Thread Velcro 들기 | 잡기 | 끼우기 |
|---|---|---|---|---|---|---|
| BeT | 12 | 0 | 0 | 24 | 0 | 0 |
| ACT | 100 | 96 | 84 | 92 | 40 | 20 |
| 방법 | Prep Tape 잡기 | 자르기 | 건네기 | 걸기 | Put On Shoe 들기 | 끼우기 | 받치기 | 고정 |
|---|---|---|---|---|---|---|---|---|
| BeT | 8 | 0 | 0 | 0 | 12 | 0 | 0 | 0 |
| ACT | 96 | 92 | 72 | 64 | 100 | 92 | 92 | 92 |
표 II — 성공률(%). 원문의 한 표를 나눈 것입니다.
ACT는 Open Cup 84%, Thread Velcro 20%, Prep Tape 64%, Put On Shoe 92%이고, BeT는 네 과제 모두 최종 성공이 0입니다.
초록은 소스 컵 열기와 배터리 끼우기가 "80–90%" 성공했다고 적지만, 표 I·II의 최종 성공률은 컵 84%, 배터리 96%입니다. 배터리 값은 초록의 범위보다 높습니다.
Thread Velcro의 실패 분석
Thread Velcro는 단계마다 성공률이 대략 절반씩 줄어 92% → 40% → 20%입니다. 저자들이 관찰한 실패는 두 가지입니다.
- 2단계에서 오른팔이 집게를 너무 일찍 닫아 공중의 케이블 타이 꼬리를 놓침
- 3단계에서 끼우는 위치가 충분히 정밀하지 않아 고리를 빗나감
두 경우 모두 영상에서 케이블 타이의 정확한 위치를 알기 어렵습니다. 검은 케이블 타이와 배경의 대비가 낮고, 케이블 타이가 영상에서 차지하는 면적이 작습니다.

그림 9 — 과제별 관측 영상. 열은 왼쪽부터 위 카메라, 정면 카메라(90도 회전), 왼쪽 손목, 오른쪽 손목.
위와 정면 카메라는 고정돼 있고, 손목 카메라는 로봇과 함께 움직이며 집게 주변을 자세히 보여 줍니다. 정면 카메라는 세로 공간을 더 담으려고 90도 돌려 달았습니다. 모든 카메라는 초점 거리를 고정하고 자동 노출을 켜서 조명 변화에 맞춥니다. 부록 B 본문은 실물 과제 6개의 예시를 싣는다고 적지만, 그림 9와 그 캡션에는 Put On Shoe를 뺀 5개 과제만 있습니다.
10. 제거 실험
제거 실험은 시뮬레이션 두 과제를 스크립트 시연과 사람 시연으로 각각 학습한 네 설정에서 합니다.

그림 7 — (a) 묶음 크기 k에 따른 성공률 (b) 시간 앙상블 유무 (c) CVAE 유무 (d) 5 Hz와 50 Hz 원격조작의 과제 완료 시간. 윗줄의 작은 표는 아래 그래프의 수치입니다.
묶음 크기
은 묶음 예측이 없는 경우이고, 가 에피소드 길이와 같으면 첫 관측 하나로 에피소드 전체 행동을 내는 완전 개루프 제어입니다. 묶음 예측만의 효과를 보려고 시간 앙상블은 끄고, 마다 정책을 따로 학습했습니다.
| 방법 | 10 | 100 | 200 | 400 | |
|---|---|---|---|---|---|
| ACT (시간 앙상블 없음) | 1 | 21 | 44 | 42 | 41 |
| BC-ConvMLP + 묶음 예측 | 1 | 1 | 24 | 25 | 20 |
| VINN + 묶음 예측 | 0 | 6 | 23 | 27.25 | 37 |
그림 7(a) 수치, 네 설정 평균 성공률(%).
ACT는 의 1%에서 의 44%로 크게 오르고, 그보다 크면 조금 내려갑니다. 저자들은 에서의 소폭 하락을 개루프에 가까워져 반응성이 줄고 긴 행동열을 모델링하기 어려워진 탓으로 봅니다.
묶음 예측의 일반성을 보려고 기준선 두 개에도 묶음 예측을 붙였습니다. BC-ConvMLP는 출력 차원을 행동 차원으로 늘렸고, VINN은 검색한 시연에서 다음 개 행동을 가져옵니다. 두 방법 모두 가 커질수록 대체로 성능이 올랐습니다. ACT는 여전히 둘보다 크게 앞서고, 저자들은 묶음 예측이 이 설정의 모방 학습 전반에 도움이 된다고 결론짓습니다.
시간 앙상블
같은 네 설정과 여러 에서, 시간 앙상블이 있을 때와 없을 때의 최고 성공률을 비교했습니다. 두 경우는 조절값을 따로 맞췄습니다.
| 방법 | 시간 앙상블 없음 | 있음 | 차이 |
|---|---|---|---|
| ACT | 44 | 47.3 | +3.3 |
| BC-ConvMLP | 25 | 29 | +4 |
| VINN | 37 | 17 | −20 |
그림 7(b) 수치, 성공률(%).
BC-ConvMLP가 4%p, ACT가 3.3%p 올랐고 VINN은 떨어졌습니다. 저자들은 시간 앙상블이 주로 신경망이 예측한 행동의 모델링 오차를 평균으로 줄여 주는데, VINN은 시연 데이터의 실제 행동을 그대로 가져오므로 줄일 모델링 오차가 없다고 해석합니다.
CVAE
CVAE 목적 함수 없이, 현재 관측에서 행동 묶음을 L1 손실로 바로 예측하는 ACT와 비교했습니다.
| 학습 데이터 | CVAE 있음 | CVAE 없음 |
|---|---|---|
| 스크립트 시연 | 59 | 58 |
| 사람 시연 | 35.3 | 2 |
그림 7(c) 수치, 시뮬레이션 두 과제 평균 성공률(%).
스크립트 시연은 같은 상황에 늘 같은 궤적이라 CVAE를 빼도 거의 차이가 없습니다. 사람 시연에서는 35.3%에서 2%로 떨어집니다. 사람 시연처럼 같은 상황에 여러 행동이 섞인 데이터에서는 5절의 스타일 변수 가 성공률을 좌우합니다.
제어 주기 사용자 연구
마지막으로 정밀 조작에 높은 원격조작 주기가 필요한지를 사용자 연구로 확인했습니다. 같은 장치에서 주기를 50 Hz에서 5 Hz로 낮췄는데, 5 Hz는 대형 신경망으로 모방 학습하는 최근 연구들의 제어 주기와 비슷한 값입니다. 5 Hz 판은 리더 로봇을 초당 5번 읽고, 관절 공간에서 보간한 위치를 50 Hz로 로봇에 보내는 방식으로 구현했습니다.

그림 11 — 사용자 연구에 쓴 케이블 타이와 플라스틱 컵.
| 항목 | 내용 |
|---|---|
| 참가자 | 컴퓨터과학 대학원생 6명 (남 4, 여 2, 22–25세). 3명은 VR 컨트롤러 원격조작 경험 있음, 3명은 없음. 모두 ALOHA는 처음 |
| 과제 1 | 케이블 타이 끼우기. 구멍 4 mm × 1.5 mm, 타이 0.8 mm × 3.5 mm(끝이 뾰족함). 탁자에 누운 타이를 한 집게로 들고 공중에서 다른 끝을 잡은 뒤 두 손으로 끼움 |
| 과제 2 | 겹친 일회용 플라스틱 컵 두 개 분리. 겹쳤을 때 틈 2.5 mm. 위 컵 가장자리를 잡고 흔들거나 다른 집게로 도와 분리 |
| 절차 | 과제 순서와 주기 순서는 참가자마다 무작위, 물체 위치도 탁자 가운데 주변에서 무작위. 조건마다 2분 적응 후 3회 연속 수행 시간 기록 |
| 과제 | 5 Hz 평균 | 50 Hz 평균 |
|---|---|---|
| 케이블 타이 끼우기 | 33초 | 20초 |
| 컵 분리 | 16초 | 10초 |
주기를 50 Hz에서 5 Hz로 낮추면 원격조작 시간이 62% 늘었습니다. 표의 평균으로 계산하면 두 과제에서 각각 65%, 60% 늘어 두 비율의 평균은 62.5%입니다(계산한 값). 반복측정 설계(repeated measures design) 통계 검정으로 50 Hz가 5 Hz보다 낫다는 결과의 p값은 0.001 미만입니다.
11. 논문 안의 수치·번호 불일치
| 위치 | 원문 표기 | 확인한 내용 | 이 글의 표기 |
|---|---|---|---|
| 알고리즘 1 vs 4-C절 | 알고리즘 1: 복원 손실 MSE / 본문: L1 사용 | 공개 코드는 L1 손실을 계산 | L1 |
| 그림 10 vs 4-C절 | 그림 10: ResNet18 출력 15 × 20 × 728 / 본문: 15 × 20 × 512 | ResNet18 마지막 채널 수 512, 공개 코드도 512 | 512 |
| 초록 | 컵·배터리 "80–90%" | 표의 최종 성공률은 컵 84%, 배터리 96% | 표 값을 함께 적음 |
| 5-C절 표 II 캡션 | "나머지 3개 실물 과제" | 표와 본문 모두 4개 과제 | 4개 |
| 부록 B | 본문 "실물 과제 6개" / 그림 9 캡션 "5개" | 그림에는 Put On Shoe가 없는 5개 | 5개로 설명 |
| 4-A절 | 오차 누적 설명에서 "(Figure II)" 참조 | 그림 번호는 아라비아 숫자이고 해당 내용의 그림 없음 | 참조 생략 |
| 그림 4 | 가중치 예시 [0.5, 0.3, 0.2, 0.1] | 합이 1.1이라 정규화 전 설명용 값 | 합으로 나눠 쓴다고 설명 |
그 밖에 본문 수치와 표를 대조한 결과는 일치했습니다. 시뮬레이션 개선폭 59·49·29·20%, 사용자 연구의 62%(평균 비율 62.5%), 에피소드 8–14초 = 400–700걸음, 로봇 가격 합계 17800달러와 부록 A의 18000달러가 모두 서로 맞습니다.
12. 저자가 밝힌 한계
하드웨어
- 두 손의 여러 손가락이 동시에 필요한 과제는 어렵습니다. 한 손으로 약병을 잡고 누름 탭을 누르는 동안 다른 손으로 뚜껑을 돌리는 어린이 보호용 약병 열기가 예입니다.
- 큰 힘이 필요한 과제는 저가 모터의 토크가 부족해 어렵습니다. 무거운 물체 들기, 밀봉된 물병 뚜껑 돌리기, 꽉 끼운 마커 뚜껑 열기가 예입니다.
- 손톱이 필요한 과제도 어렵습니다. 집게 끝을 얇게 설계했지만, 자기 자신에 붙은 포장 테이프 끝을 들어 올리거나 알루미늄 캔을 따지 못합니다.
정책 학습
저자들은 ACT가 학습하지 못한 과제 2개를 모두 보고합니다.
| 과제 | 시연 수 | 결과 | 저자의 해석 |
|---|---|---|---|
| 사탕 포장 벗기기 | 50 | 10회 평가에서 집기 10/10, 양 끝 당기기 8/10, 포장 벗기기 0/10. 사탕 5개에 각각 10번씩 기회를 주는 평가에서는 5개 중 3개 성공 | 양쪽을 당긴 뒤 포장지 이음매가 사탕 둘레 어디에나 생길 수 있고, 사람도 포장지 무늬가 끊긴 곳을 보고서야 찾음. 정책이 이음매가 없는 곳을 계속 벗기려 함 |
| 탁자에 누운 작은 지퍼백 열기 | 50 | 봉지 집기는 꾸준히 성공, 이후 공중에서 하는 세 단계(왼쪽 집게로 당김 부분 잡기, 오른손으로 반대쪽 잡기, 당겨 열기)에서 어려움 | 봉지를 보기 어렵고, 집는 위치의 작은 차이가 봉지 변형을 바꿔 당김 부분의 위치가 크게 달라짐 |
저자들은 사전학습, 더 많은 데이터, 더 나은 인식을 이런 과제의 해결 방향으로 꼽습니다. 단추 채우기처럼 로봇이나 학습 알고리즘의 능력을 넘는 과제가 여전히 있다는 점도 결론에 적습니다.
13. 정리 — VLA 선행 연구에서의 위치
이 논문은 저가 하드웨어와 학습 알고리즘을 함께 설계해, 위치 정확도 5–8 mm인 로봇으로 밀리미터 단위 양팔 조작을 과제당 시연 50개로 학습했습니다.
- ALOHA 는 작은 리더 로봇의 관절 각도를 큰 팔로워 로봇에 그대로 옮기는 원격조작으로, 2만 달러 예산에서 정밀·접촉·동적 과제의 시연을 모을 수 있게 했습니다.
- 행동 묶음 예측 은 행동 100걸음을 한 번에 예측해 정책의 결정 횟수를 줄이고, 오차 누적과 시연 속 멈춤 문제를 함께 줄였습니다.
- 시간 앙상블 은 매 걸음 정책을 호출해 같은 시점을 겨냥한 예측들을 지수 가중 평균하므로, 묶음이 바뀌는 순간에도 동작이 끊기지 않습니다.
- CVAE 스타일 변수 는 같은 상황에서 매번 다른 사람 시연의 방식 차이를 로 분리해, 사람 시연 학습 성공률을 2%에서 35.3%로 올렸습니다.
VLA와의 연결
| 항목 | ACT | Diffusion Policy (12편) | π0 (VLA 계보 5편) | OpenVLA-OFT (VLA 계보 8편) |
|---|---|---|---|---|
| 행동 묶음 | (50 Hz) | 생성, 실행 (10 Hz) | LIBERO 실험에서 | |
| 행동 생성 방식 | CVAE 디코더, L1 회귀 | DDPM 잡음 제거 | flow matching | 병렬 디코딩 + L1 회귀 |
| 겹치는 묶음 처리 | 시간 앙상블 | 앞쪽 일부만 실행 후 다시 생성 | 겹치는 묶음을 평균하지 않고 묶음을 개루프로 실행 | 묶음 전체를 실행한 뒤 다시 계획 |
| 입력 | 영상 4장 + 관절 | 영상 + 로봇 상태 | 여러 영상 + 언어 지시 + 로봇 상태 | 3인칭 영상 + 언어 지시 (선택: 손목 영상, 로봇 상태) |
π0(arxiv 2410.24164)은 참고문헌에서 이 논문을 인용하며 행동 묶음 구조를 쓴다고 밝히고, 행동 묶음 길이를 으로 둡니다. 다만 π0 저자들은 초기에 시간 앙상블을 시도했다가 성능이 떨어져, 겹치는 예측을 평균하지 않고 묶음을 개루프로 실행하는 쪽을 택했다고 적습니다. OpenVLA-OFT(arxiv 2502.19645)는 OpenVLA를 미세조정하는 방법으로 병렬 디코딩, 행동 묶음 예측, 연속 행동 표현, L1 회귀 목적 함수를 함께 씁니다. 연속 행동을 L1으로 회귀한다는 점도 ACT의 선택과 같습니다.
이 논문의 기준선에는 VLA 계보 1편 RT-1도 들어 있습니다. RT-1은 한 걸음씩 256구간으로 이산화한 행동을 내는 구조였고, 이 논문의 실물 과제 두 개에서는 첫 단계를 넘지 못했습니다. 행동을 토큰 하나씩 내던 초기 VLA가 이후 행동 묶음과 연속 행동 생성으로 옮겨 가는 과정은 VLA 계보에서 이어서 다룹니다.
이 글로 VLA 선행 연구 13편이 끝납니다. 전체 목록은 VLA 선행 연구 목차에서 볼 수 있습니다.