들어가며
π0.5 논문해석까지의 VLA는 카메라 영상과 언어 지시를 받아 로봇 행동만 출력했습니다. 같은 시기에 다른 갈래도 자랐습니다. 로봇이 행동하면 장면이 어떻게 바뀔지를 영상으로 함께 예측하는 모델로, DreamZero가 이런 모델을 세계-행동 모델(World Action Model, WAM) 이라고 불렀습니다. 대규모 영상으로 배운 "세상이 어떻게 움직이는가"에 대한 지식을 행동 예측에 그대로 옮길 수 있다는 것이 WAM의 장점입니다.
문제는 비용입니다. 영상까지 생성하니 한 번에 처리할 토큰 열이 길고, 분류기 없는 안내(classifier-free guidance, CFG)를 쓰면 매 단계 순전파가 두 번 필요하며, 뼈대 모델도 VLA보다 큽니다. 공개 모델 기준으로 WAM인 Cosmos 3 Nano는 RoboLab 과제의 36.8%를 성공하고 가장 강한 공개 VLA인 π0.5는 28.0%를 성공합니다. 그런데 B200 GPU에서 Cosmos 3 Nano(FP8)는 로봇 동작 1초당 처리 시간이 π0.5(BF16)의 약 4.7배입니다. WAM을 고르면 지연과 하드웨어 비용을 내야 하고, VLA를 고르면 성공할 수 있던 시도의 4분의 1가량을 포기하게 됩니다.
FLUX 3 Action(이하 F3A)은 이 선택을 좁힌 모델입니다. 이미지 생성 모델로 알려진 Black Forest Labs가 자사의 멀티모달 생성 모델 FLUX 3의 뼈대(backbone)를 로봇 제어로 가져왔습니다. 영상과 행동을 함께 예측하는 구조는 그대로 두면서 파라미터는 Cosmos 3 Nano의 절반 이하인 7B로 줄였고, 증류(distillation)로 안내 순전파와 샘플링 단계를 줄여 VLA와 견줄 만한 속도를 냈습니다.
📄 FLUX 3 Action: A 7B World Action Model for Robot Control — Black Forest Labs, 2026-09 기술 보고서
arxiv 판은 없고 BFL 웹사이트의 기술 보고서가 원문입니다. 가중치는 Hugging Face 컬렉션에, 코드는 black-forest-labs/flux-action에 공개됐습니다. 원문 그림 대부분은 웹 페이지 안의 대화형 차트여서, 이 글의 그림은 원문 페이지를 캡처한 것입니다.
초록 요약
시각 지능은 시각 세계를 이해하고 추론하고 그 안에서 행동하는 능력을 가리키고, 그중 하나가 관측을 보고 에이전트의 다음 행동과 그 결과로 바뀔 환경 상태를 예측하는 행동 예측(action prediction) 입니다. 멀티모달 세계 모델이 발전하면서 로봇 분야의 행동 예측도 빠르게 좋아졌지만, 계획과 일반화에 강한 최신 추론 모델은 지연과 모델 크기 때문에 로봇 제어에 바로 쓰기 어렵습니다.
F3A는 영상 비중이 높은 이미지·영상·음성 데이터로 사전학습한 FLUX 3 뼈대에서 출발한 7B 공개 가중치 WAM입니다. RoboLab-120 리더보드에서 이전 최고 공개 모델의 절반도 안 되는 파라미터로 최고 성공률을 새로 썼고, 속도는 최대 3.95배 빠릅니다. 저자들은 로봇에서는 미세조정 방법이 가중치만큼 중요하다고 보고, 사전학습·중간학습·미세조정·추론 최적화 과정을 모두 공개했습니다. 또 빠른 행동 예측 모델에 최신 추론 모델의 계획 능력을 결합한 혼합 시스템을 분석해, 행동 모델이 빠르면 추론에 드는 비용과 시간이 줄어 1달러당 성공이 최대 53.64% 늘어난다고 보고합니다.
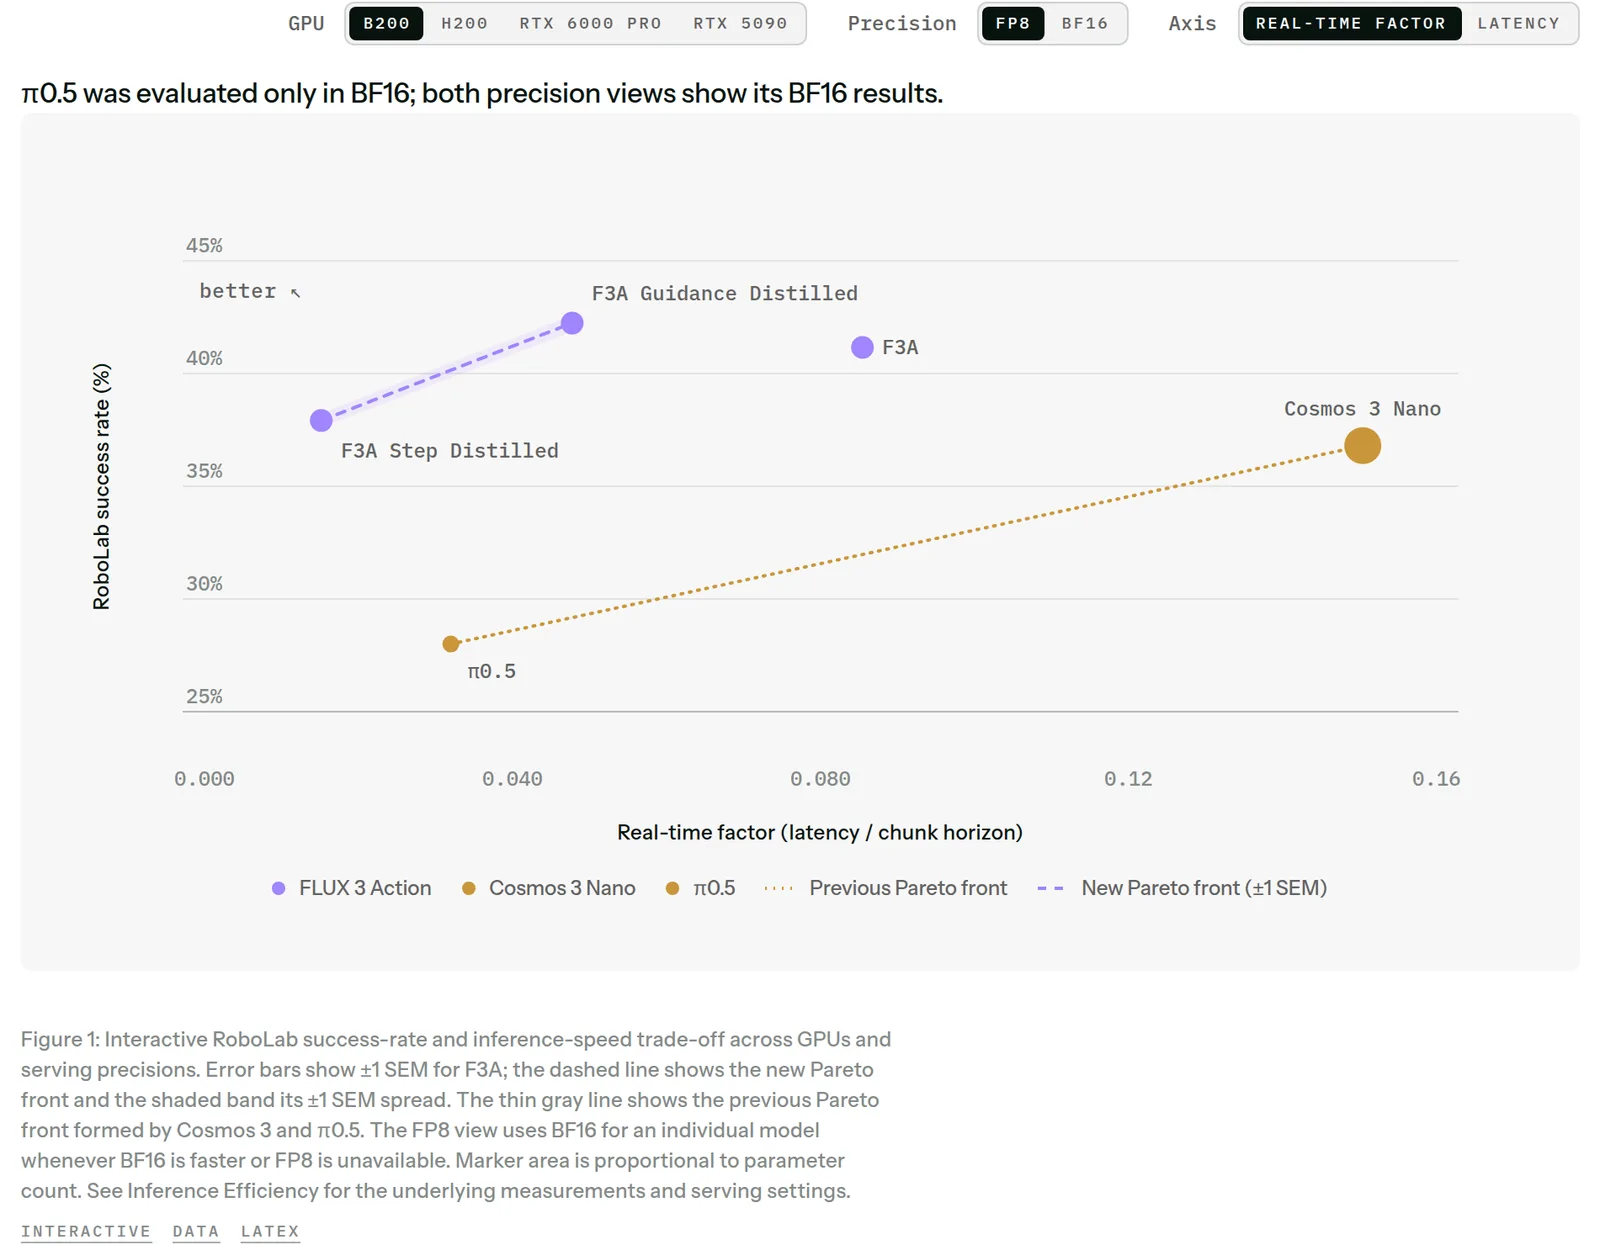
그림 1 — GPU와 정밀도별 RoboLab 성공률(세로)과 실시간 계수(가로). 점선이 F3A가 새로 만든 파레토 전선, 회색 선이 Cosmos 3와 π0.5가 만들던 이전 전선입니다.
B200·FP8 기준으로 안내 증류판 F3A는 실시간 계수 0.048에서 42.24%를 성공합니다. 같은 조건에서 Cosmos 3 Nano는 0.150에서 36.8%, π0.5(BF16)는 0.032에서 28%입니다. 단계 증류판은 0.015에서 37.92%입니다. 실시간 계수는 처리 시간을 행동 묶음이 담는 로봇 동작 시간으로 나눈 값이라 작을수록 여유가 큽니다.
1. 문제 — WAM과 VLA 사이의 선택
공개 정책의 현재 위치
| 모델 | 비공개 여부 | 유형 | 성공률 | 파라미터 |
|---|---|---|---|---|
| FLUX 3 Action | 아니오 | WAM | 42.92% | 7B |
| OASIS WAM | 예 | VLM + WAM | 39.0% | – |
| Cosmos3-Nano-Policy | 아니오 | WAM | 36.8% | 16B |
| Phoenix | 예 | TAMP+FM | 34.4% | – |
| BiMind v0.1 | 예 | VLA | 33.3% | – |
| π0.5 | 아니오 | VLA | 28.0% | 3.3B |
| DreamZero | 아니오 | WAM | 25.7% | 14B |
| Cosmos3-Edge-Policy | 아니오 | WAM | 22.9% | 4B |
| π0-FAST | 아니오 | VLA | 15.5% | 3B |
| GR00T N1.6 | 아니오 | VLA | 7.2% | 3B |
| π0 | 아니오 | VLA | 5.0% | 3.3B |
| paligemma-binning | 아니오 | VLA | 3.4% | 3B |
표 1 — RoboLab-120 전체 성공률. 유형과 가중치 공개 여부는 RoboLab 리더보드 표기를 따랐습니다.
리더보드 상위는 WAM이 차지하고 있습니다. 영상과 행동을 함께 예측하면 대규모 영상 사전학습으로 얻은 세계 이해가 적은 행동 데이터만으로도 행동 예측에 옮겨 가기 때문입니다. 대가는 긴 토큰 열입니다. 게다가 WAM은 안내 기법 때문에 매 순전파 비용이 두 배가 되는 경우가 많고, Cosmos 3는 π0.5보다 파라미터가 4.85배 많습니다.
기존의 가속 방법은 두 가지였습니다. 하나는 영상과 행동 사이의 상호작용을 줄이는 것인데, 이러면 WAM의 구조와 능력 자체가 바뀝니다. 다른 하나는 안내 계산을 GPU 여러 장에 병렬로 나누는 것인데, 하드웨어 비용이 늘고 그래도 큰 모델 크기 때문에 VLA만큼 빨라지지 않습니다.
F3A가 바꾼 두 가지
단일 단계 7B 체크포인트는 RoboLab에서 38.3% ± 0.38로 다른 모든 공개 정책보다 높습니다(Cosmos 3 Nano 36.8%). 그러면서도 영상과 행동을 여전히 함께 예측하는데, 워크스테이션·데이터센터 GPU에서 로봇 동작 1초당 속도가 π0.5보다 1.34~2.28배 빠릅니다. 이 속도 우위는 호출 한 번의 지연이 아니라 실시간 계수 기준이라는 점을 짚어 둘 필요가 있습니다. F3A는 한 번에 2.13초 분량의 동작을 예측하고 π0.5는 1.0초 분량을 예측합니다. 지연이 덜 중요한 상황에서는 안내 증류 체크포인트가 성공률을 42.2% ± 0.36까지 올립니다. FP8 기본·안내 증류 체크포인트는 소비자용·워크스테이션·데이터센터 GPU 전반에서 Cosmos 3 Nano(FP8)보다 1.52~3.95배 빠릅니다.
저자들이 꼽는 요인은 두 가지입니다.
- 작은 뼈대 — 멀티모달 Self-Flow 사전학습이 좋은 표현을 만들어 Cosmos 3 Nano의 절반 이하 크기로도 충분했습니다.
- 영상과 행동을 떼지 않는 증류 — 안내 순전파를 없애고 샘플링 단계를 1회로 줄이는 증류를, 영상과 행동을 분리하지 않은 채 적용했습니다.
추론 모델과의 결합
속도와 정확도의 전선을 밀어냈어도, F3A를 포함한 모든 정책이 혼자서는 풀지 못하는 과제가 남아 있습니다. GPT 6 Astra는 최대 추론 노력(reasoning effort)으로 Su et al.(2026) 벤치마크의 모든 과제를 풉니다. 하지만 추론 호출 한 번이 로봇 동작 1초당 약 35.77초를 더하고, 성공 한 번에 평균 $13.47와 16분이 듭니다.
F3A는 로봇 동작 1초당 21.08밀리초를 쓰고, H200을 시간당 0.09와 2분이 채 들지 않습니다. 그 2분의 대부분은 로봇이 움직이는 동안 기다리는 시간이어서, 추가 비용 없이 다른 시도 47개를 동시에 처리할 수도 있습니다. 한계는 모든 과제를 풀지는 못한다는 점입니다.
그래서 추론 모델이 평소에는 빠른 정책에 제어를 맡기고 필요할 때만 끼어드는 방식을 시험했습니다. π0.5를 정책으로 쓰면 이 위임이 거의 도움이 되지 않았습니다. 가장 좋은 조합도 성공당 13.47), 13.5분(순수 추론 14분)이었습니다. F3A를 쓰면 전체 시도의 90%를 성공하면서 순수 정책은 풀지 못하는 복잡한 과제까지 풀고, 성공당 $8.77·8분으로 가장 좋은 대안보다 29% 싸고 40% 빨랐습니다. 최대 노력의 순수 추론이 여전히 가장 정확하므로 신뢰성과 비용 사이의 절충은 남지만, 정책이 좋아지면 그 절충점이 옮겨 갑니다.
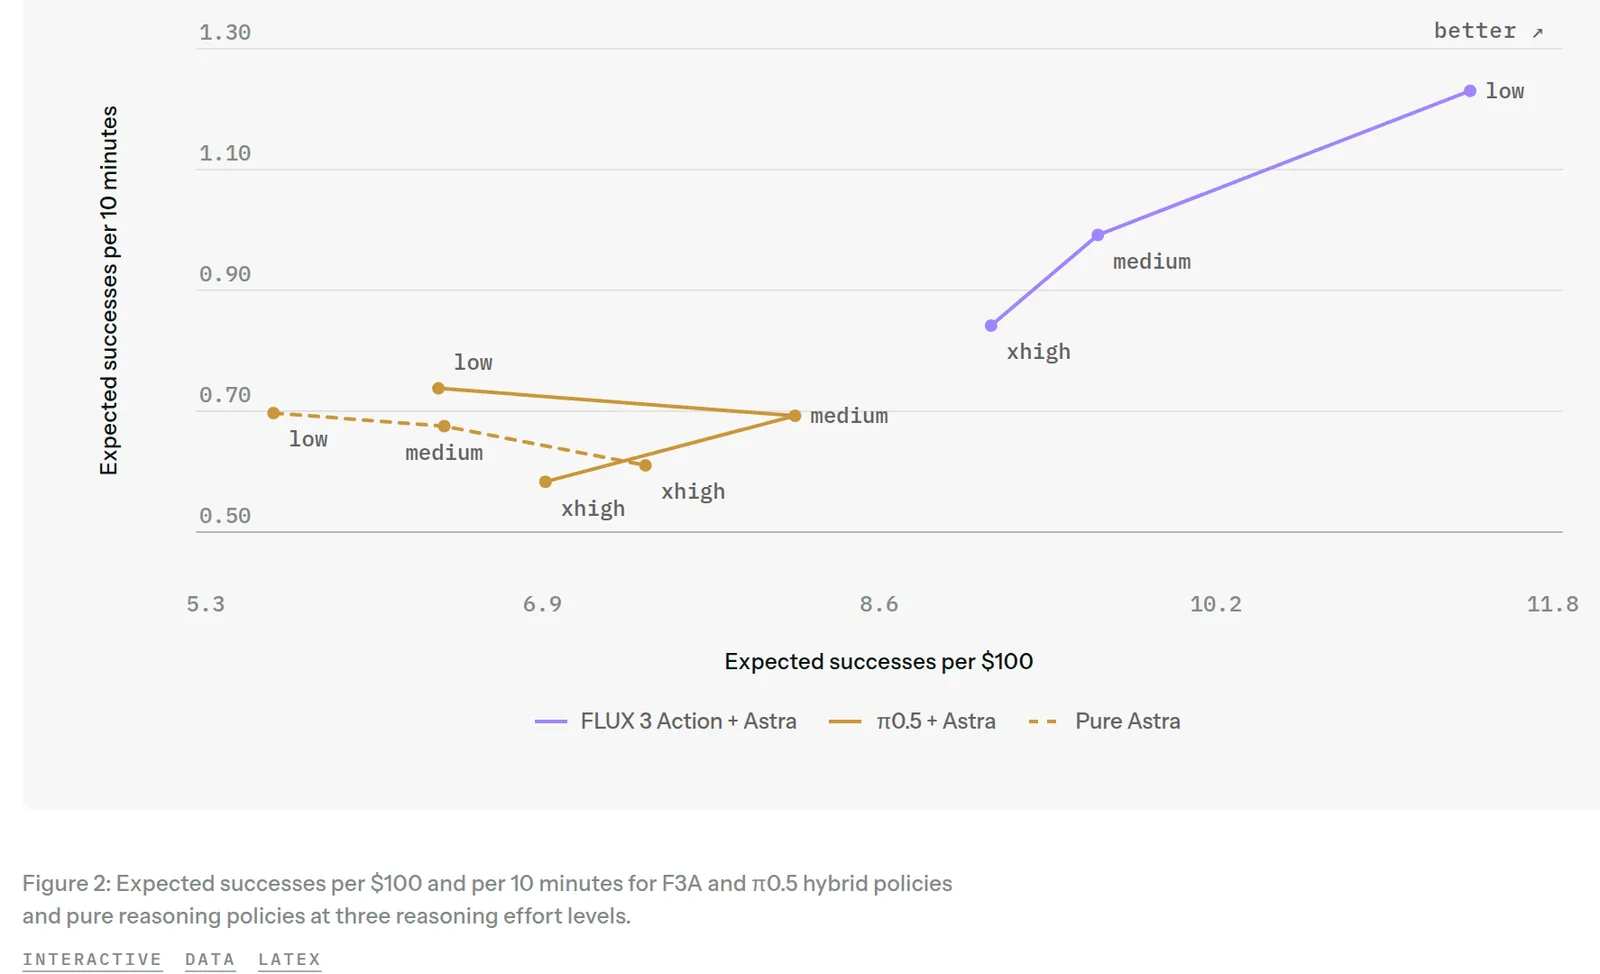
그림 2 — 100달러당·10분당 기대 성공 횟수. F3A+Astra(low)가 100달러당 11.4회, 10분당 1.23회로 두 축 모두 가장 높고, π0.5 조합과 순수 Astra는 100달러당 5.6~8.1회, 10분당 0.58~0.74회에 머뭅니다.
빠른 정책이 좋을수록 시스템이 추론해야 할 일이 줄어듭니다. 저자들은 이 결과를 추론과 빠른 행동 예측을 더 깊이 결합하는 연구의 첫걸음으로 봅니다.
2. 영상 예측에서 행동 예측으로
계보
미래 관측을 예측하는 모델로 의사결정을 하는 생각은 오래됐습니다(Schmidhuber 1990 등). 초기 로봇 연구는 행동을 조건으로 한 영상 예측에 모델 예측 제어(model-predictive control)를 결합했습니다. UniPi는 텍스트 조건 영상 생성기로 과제를 수행하는 영상을 만든 뒤, 역동역학 모델(inverse dynamics model, IDM)로 생성된 프레임에서 실행할 행동을 복원했습니다. UniPi는 로봇이 아닌 대규모 데이터로 영상 모델을 사전학습하면 그 지식이 로봇 정책으로 옮겨 가 처음 보는 과제에 대한 일반화가 좋아진다고 주장했습니다.
이후 연구는 대규모 영상 사전학습은 유지하되, "영상 생성 → IDM"의 두 단계 대신 영상과 행동을 더 단단히 묶었습니다.
| 갈래 | 방식 | 대표 연구 |
|---|---|---|
| 영상 생성 + IDM | 과제 영상을 만든 뒤 프레임에서 행동 복원 | UniPi |
| 세계-행동 모델(WAM) | 한 생성 모델이 미래 프레임과 행동을 함께 예측 | GR-1, GR-2, WorldVLA, Cosmos Policy, LingBot-VA, DreamZero, GigaWorld-Policy, Cosmos 3 |
| 영상-행동 모델(VAM) | IDM을 디코딩된 프레임이 아니라 영상 모델의 잠재 특징에 조건화, 추론 때 영상 합성 생략 | mimic-video |
| 보조 과제 | 영상 예측은 학습 때 보조 과제로만 쓰고 추론 때는 건너뜀 | Li et al. 2025, Zhu et al. 2025, Yuan et al. 2026 |
BFL은 앞선 FLUX-mimic 설계 연구에서 FLUX 3를 별도 행동 디코더가 붙은 VAM으로 시험했습니다. 이번 보고서는 FLUX 3를 영상과 행동을 함께 예측하는 WAM으로 씁니다.
구조
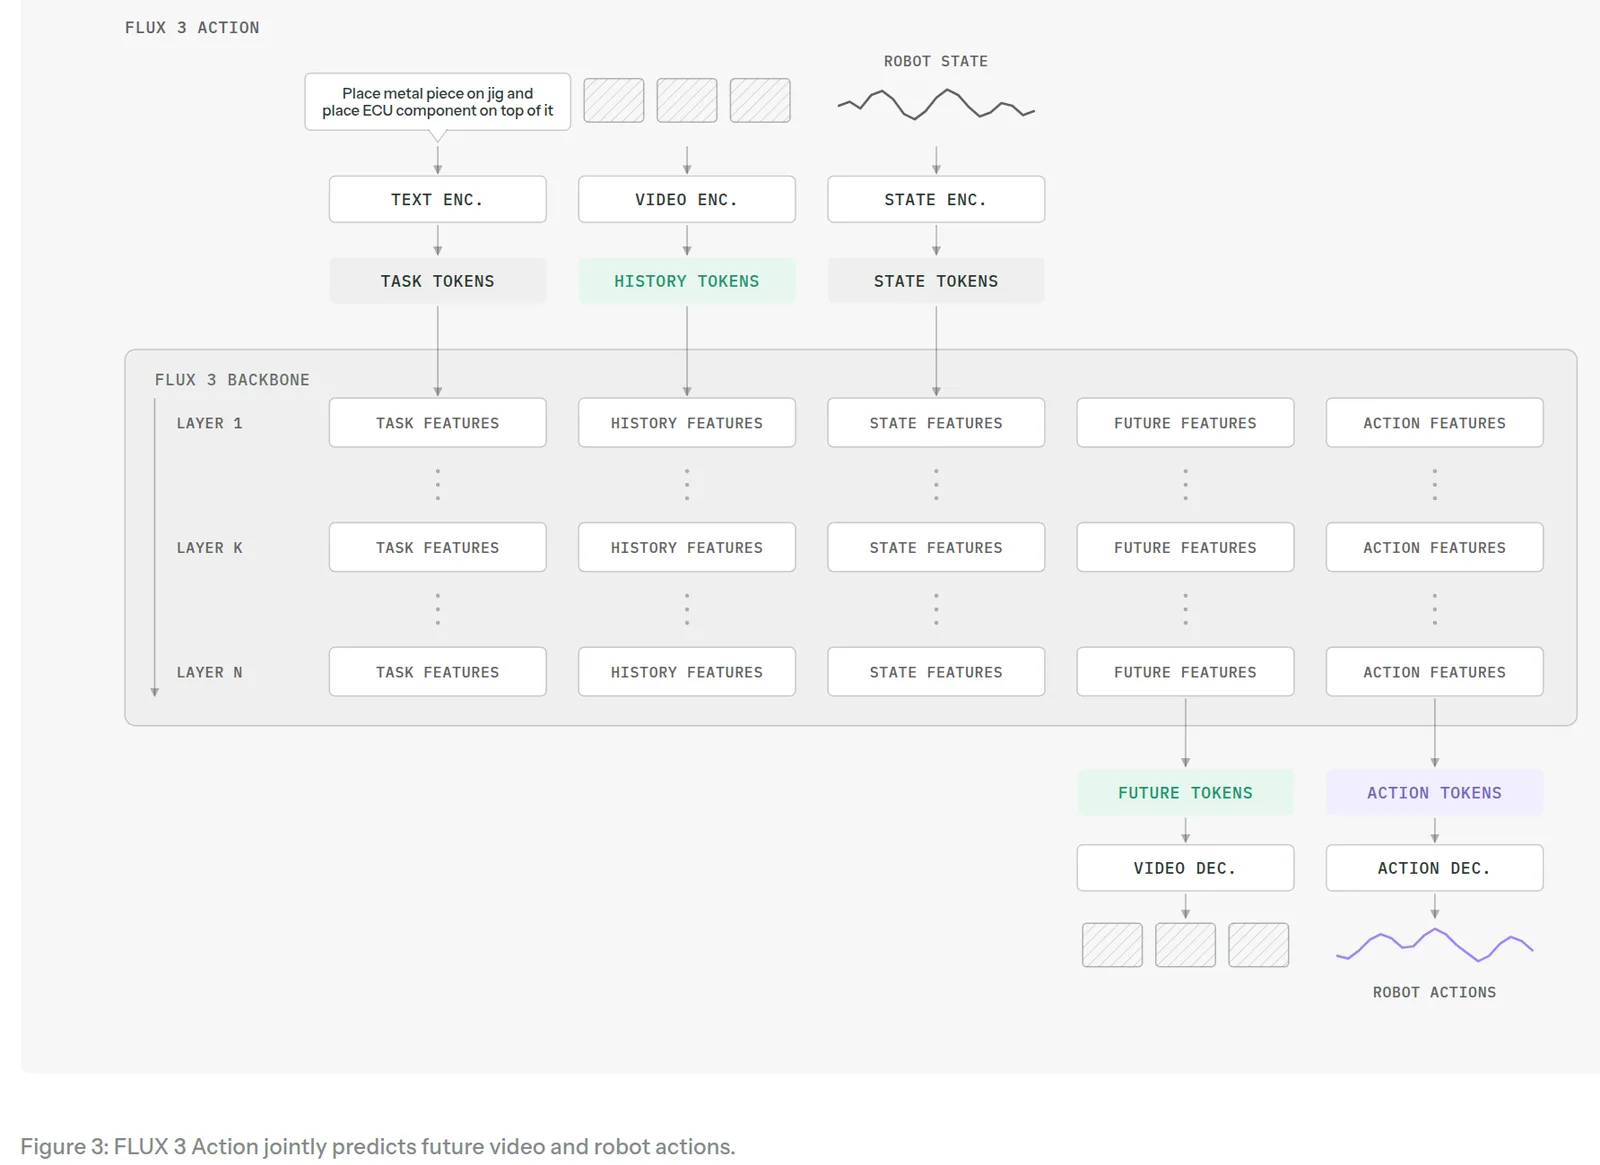
그림 3 — 텍스트·영상·로봇 상태를 각각 토큰으로 바꿔 FLUX 3 뼈대에 넣고, 마지막 층에서 미래 토큰은 영상 디코더로, 행동 토큰은 행동 디코더로 내보냅니다.
뼈대의 각 층은 과제·과거 이력·상태·미래·행동 특징을 한꺼번에 처리합니다. 미래 영상과 행동을 서로 다른 모델로 나누지 않고 같은 층들이 동시에 잡음 제거(denoise)한다는 것이 WAM의 요점입니다.
제어 루프
"빨간 큐브를 왼쪽 통에 넣어" 같은 지시를 받으면 모델은 카메라 영상과 관절 위치를 보고 모터 명령과 그 명령의 시각적 결과를 함께 예측합니다. 로봇은 예측한 행동 가운데 정해진 개수만 실행한 뒤 다시 보고, 새 관측에서 다시 계획합니다.
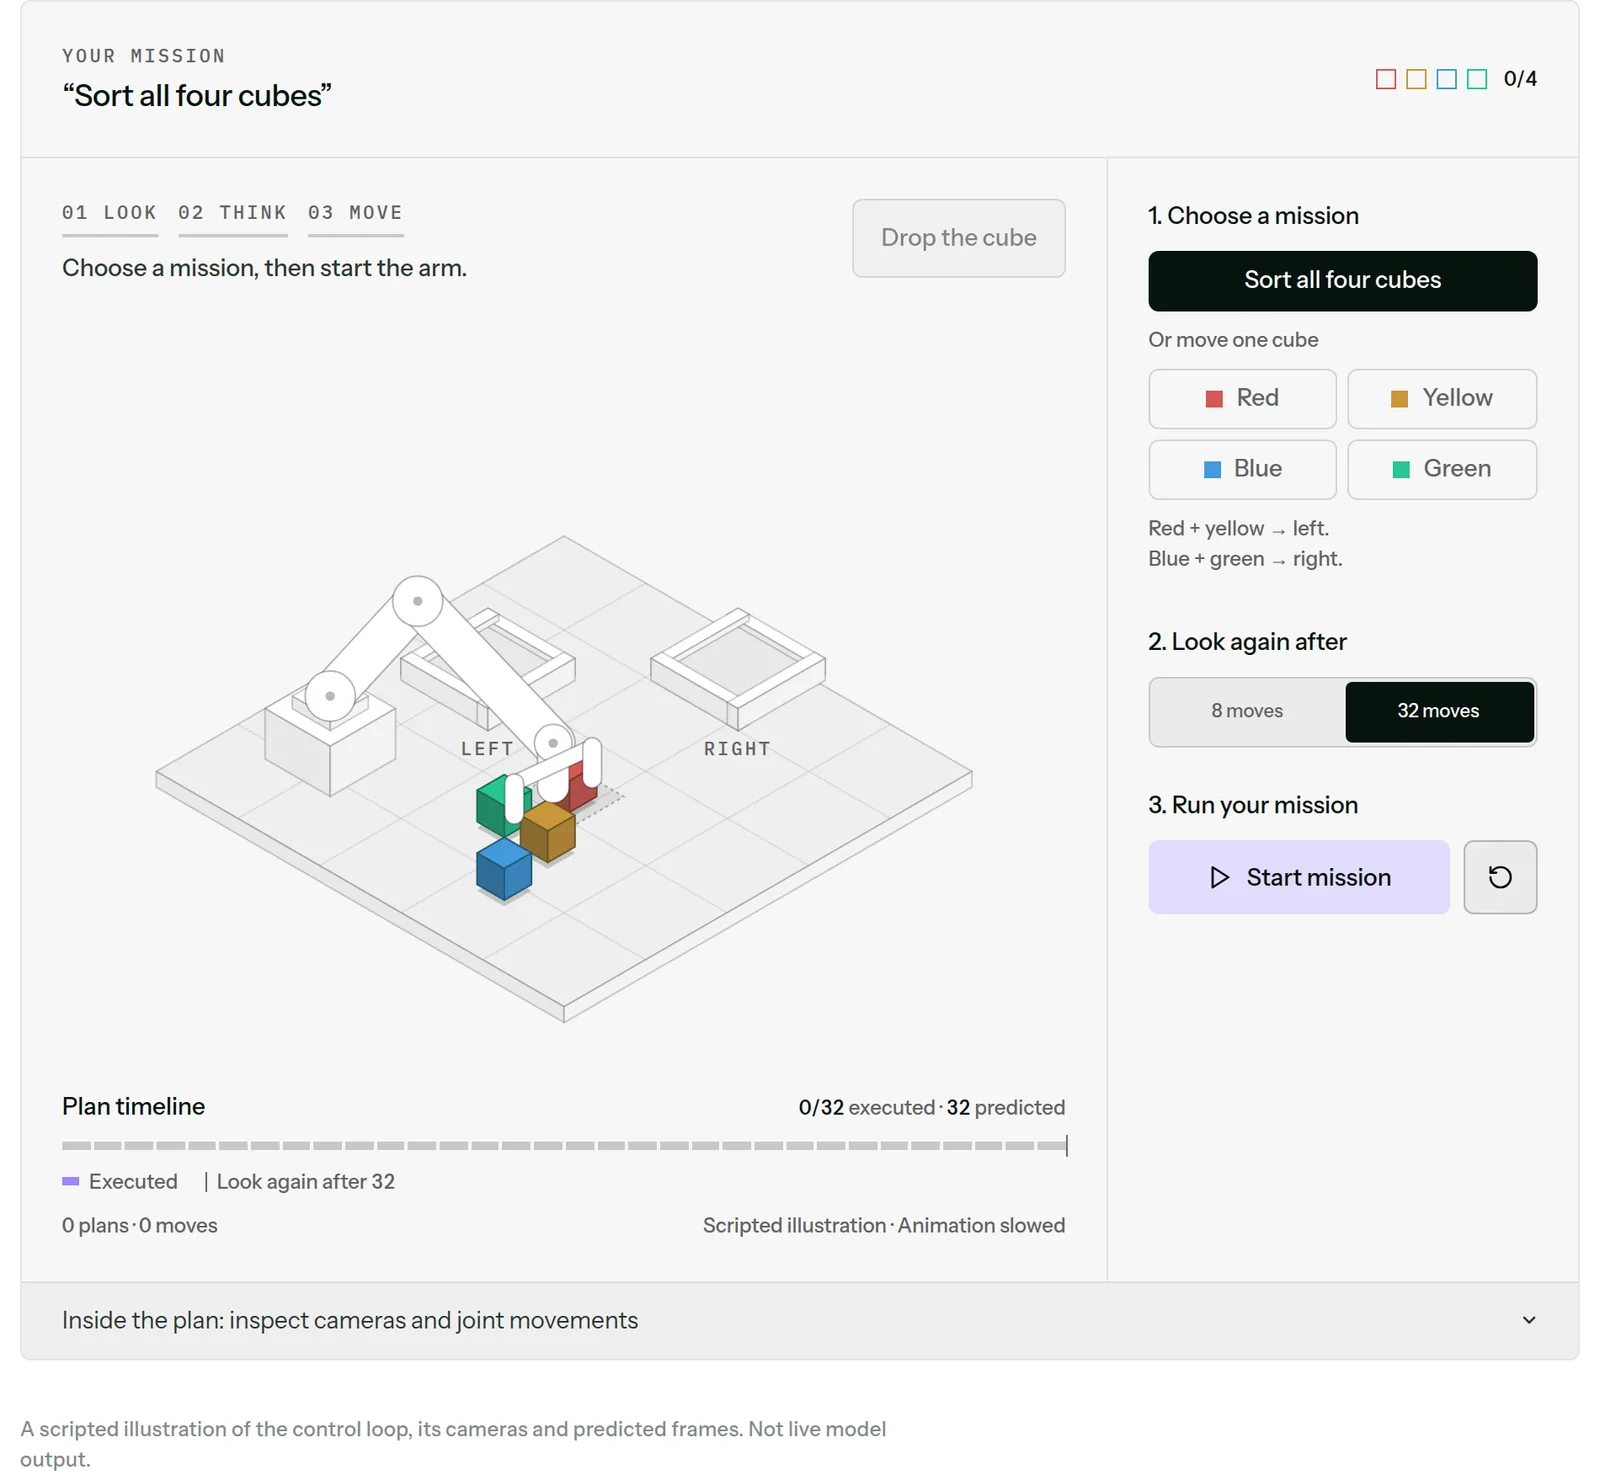
원문의 대화형 예시 — 보기(Look) · 생각하기(Think) · 움직이기(Move)를 반복하며, 몇 걸음마다 다시 볼지(8걸음 또는 32걸음)를 바꿔 볼 수 있습니다. 실제 모델 출력이 아닌 설명용 애니메이션입니다.
다시 보는 간격이 짧을수록 누가 큐브를 떨어뜨리는 것 같은 변화에 빨리 반응하고, 길수록 추론 호출이 줄어듭니다.
3. 사전학습과 중간학습
사전학습의 효과
사전학습은 FLUX 3를 따랐고 이미지·영상·음성 데이터를 섞었으며, 학습 토큰의 95% 이상이 영상입니다. 사전학습 체크포인트의 행동 예측 능력은 Cosmos 3와 비슷한 방식으로 평가했습니다. 무작위로 초기화한 행동 헤드를 붙여 DROID로 미세조정한 뒤 RoboLab에서 평가합니다.
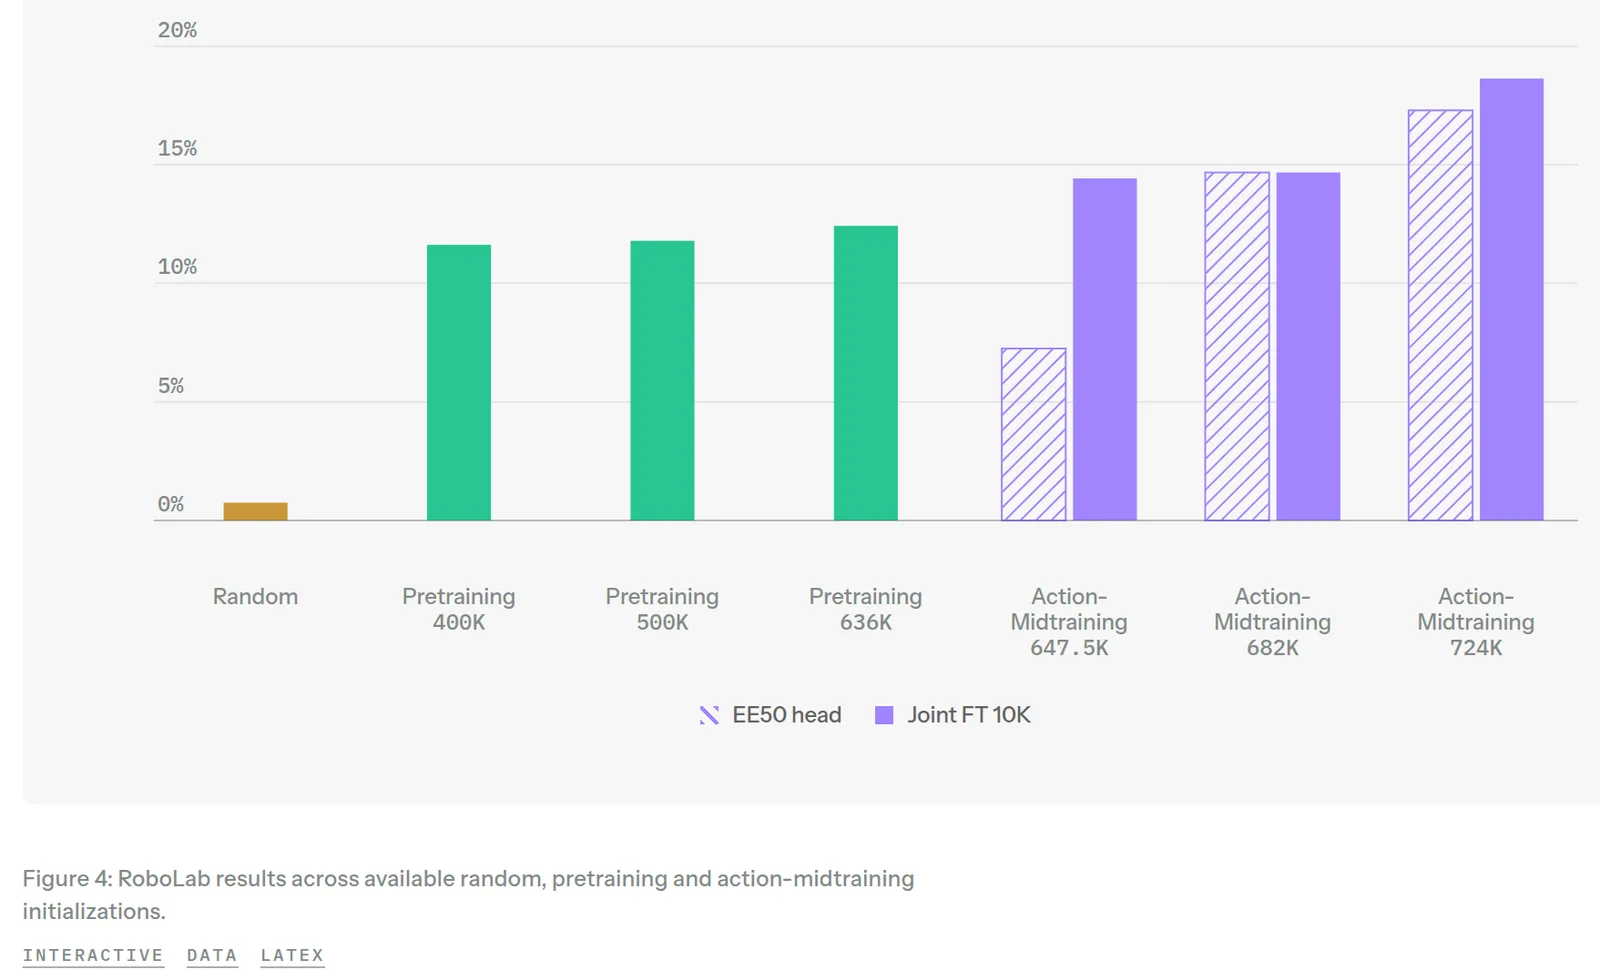
그림 4 — 무작위·사전학습·행동 중간학습 초기화별 RoboLab 성공률. 미세조정 1만 걸음에서 무작위 초기화는 0.75%, 724K 행동 중간학습 체크포인트는 18.63%이고, 중간학습에서 붙인 EE50 헤드를 그대로 쓰면 724K에서 17.29%입니다.
이 그림의 실험은 작은 배치와 학습률로 한 예비 설정이라 체크포인트의 최대 성능은 아니지만, 설정이 같으므로 상대 비교는 가능합니다. 사전학습 없이는 성능이 1% 미만에 머뭅니다. 사전학습을 거치면 11.6%로 뛰고 12.4%까지 천천히 오릅니다. DROID 행동 데이터만으로는 데이터가 크게 부족하고, 영상 중심의 멀티모달 사전학습이 이 부족을 메운다는 뜻입니다.
행동 중간학습 데이터
다음으로 사전학습 데이터에 행동이 붙은 새 데이터를 섞어 학습을 이어 가는 행동 중심 중간학습(midtraining)을 했습니다. 학습 샘플의 36.95%는 사전학습 데이터의 음성 포함 영상이고, 나머지 63.05%는 행동이 정렬된 영상입니다.
| 범주 | 샘플 비율 (%) | 토큰 비율 (%) |
|---|---|---|
| 영상/음성 공동 | 36.95 | 39.00 |
| 게임 | 19.55 | 21.85 |
| 1인칭 사람 손 | 13.54 | 13.78 |
| 휴대형 그리퍼 | 14.03 | 13.99 |
| 원격조작 | 15.93 | 11.37 |
표 2 — 행동 중간학습 데이터 구성. 원격조작은 몸체(embodiment) 14종에서 모았고, 해상도와 길이가 달라 토큰 비율은 샘플 비율과 조금 다릅니다.
행동 공간
데이터마다 행동을 표현하는 방식이 다르므로 공통 형식을 정했습니다.
| 행동 공간 | 차원 | 구성 |
|---|---|---|
| 게임 | 64 | 마우스 x·y 이동 2 + 좌우 버튼 2 + 키보드 60. 이진 버튼 채널은 학습 때 역양자화 |
| EE50 | 50 | 주(왼쪽) 말단장치 25 + 보조(오른쪽) 말단장치 25 |
| 관절 공간 | 14 | 팔 하나당 관절 6 + 그리퍼 1, 두 팔 |
EE50의 25차원은 평행이동 3, 회전 6, 손 자세 각도 또는 그리퍼 상태 16으로 나뉩니다. 회전은 Zhou et al.(2019)의 6차원 표현을 쓰되 회전 행렬의 앞 두 열이 아니라 앞 두 행을 씁니다. 그리퍼는 0이 닫힘, 1이 열림이고, 몸체에 없는 차원은 0으로 채웁니다. 관절 공간 데이터는 몸체의 순기구학 모델이 없어서 관절 상태로 직접 학습했습니다. 행동 주기는 데이터셋마다 5~30 Hz입니다.
EE50의 말단장치 자세는 마지막 조건 프레임을 기준(anchor) 프레임으로 삼아, 그 프레임에 가장 가까운 행동 상태에 대한 상대값으로 표현합니다. 손 관절과 그리퍼 값은 절대값으로 둡니다. 마지막으로 각 차원을 몸체별 z-점수로 정규화하는데, 기준 상태에서 떨어진 부호 있는 위치 오프셋마다 따로 정규화합니다(Punamiya et al. 2025).
EE50 행동 헤드가 생기자 중간학습 체크포인트를 추가 미세조정 없이 RoboLab에서 바로 평가할 수 있게 됐습니다(그림 4의 빗금 막대). EE50 성능은 초기에 0%에서 7.2%, 14.7%로 빠르게 올랐고 관절 미세조정 결과는 마지막 사전학습 체크포인트보다 2.3%만 좋아졌습니다. 후반으로 가면서 EE50은 17.3%, 관절 미세조정은 18.6%까지 계속 올랐고, 중간학습은 아직 포화하지 않았습니다.
4. 영상과 행동의 잡음-신호 전이
두 모달리티의 전이 시점
확산 모델과 flow 모델은 데이터 와 잡음 을 섞는 시간 색인 전방 과정 을 거꾸로 되돌리도록 학습합니다. 데이터의 규모와 구조에 따라 잡음이 신호로 바뀌는 구간이 다르고, 학습 때 를 뽑는 시간 단계 분포(timestep distribution)의 선택이 성능에 크게 영향을 줍니다.
영상과 행동을 함께 예측할 때는 두 모달리티의 상호작용도 고려해야 합니다. 저자들은 두 모달리티의 복원 손실을 따로 계산하고, 여러 시간 단계 분포로 학습한 체크포인트들의 점별 최솟값을 취해 최소 포락선(minimum envelope) 손실을 구했습니다. 이 포락선을 두 모달리티의 잡음-신호 전이 모양의 근사로 씁니다.
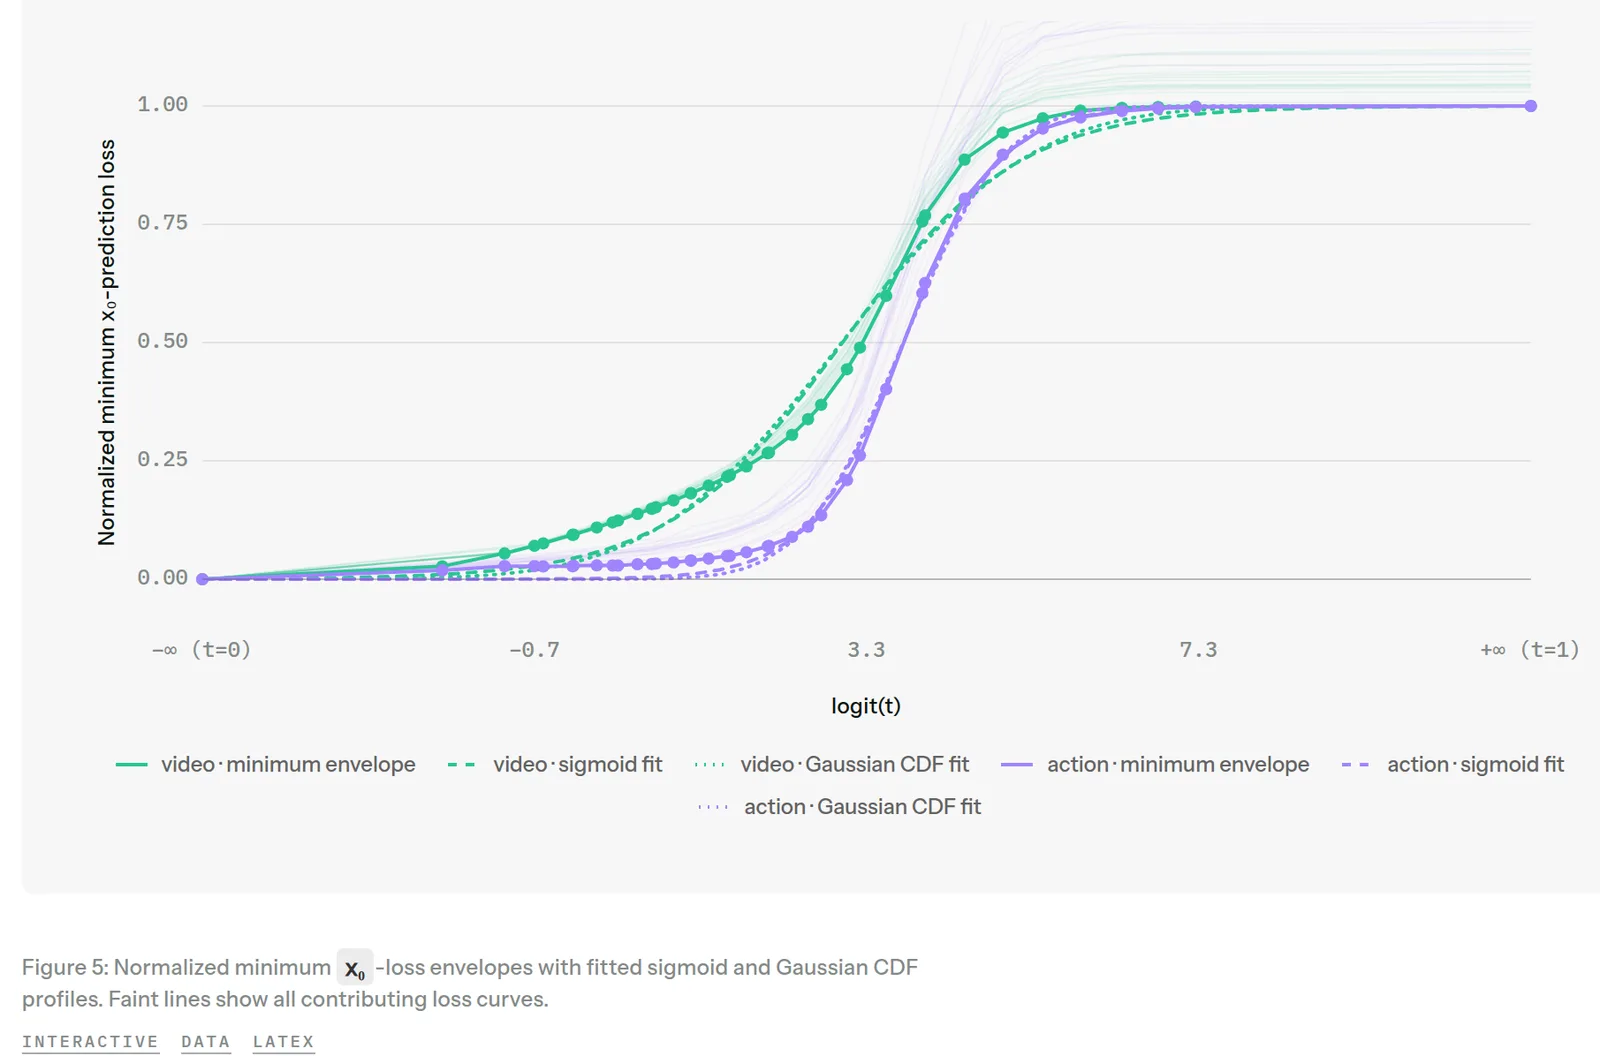
그림 5 — 최대값을 1로 정규화한 최소 x₀ 손실 포락선과 시그모이드·가우스 누적분포 근사. 행동 포락선이 대부분의 구간에서 영상보다 낮고, 전이가 더 늦게 일어납니다.
S자 모양의 전이는 , 곧 부근에서 일어납니다. 모델의 용량은 신호 전이가 큰 구간에 쓰는 것이 좋다고 보면, S자 곡선의 도함수에 비례하는 확률밀도를 시간 단계 분포로 쓰는 것이 자연스럽습니다. S자를 시그모이드로 근사하면 로짓 공간의 로지스틱 분포(logit-logistic)가 되고, 가우스 누적분포로 근사하면 로짓 정규분포(logit-normal)가 됩니다.
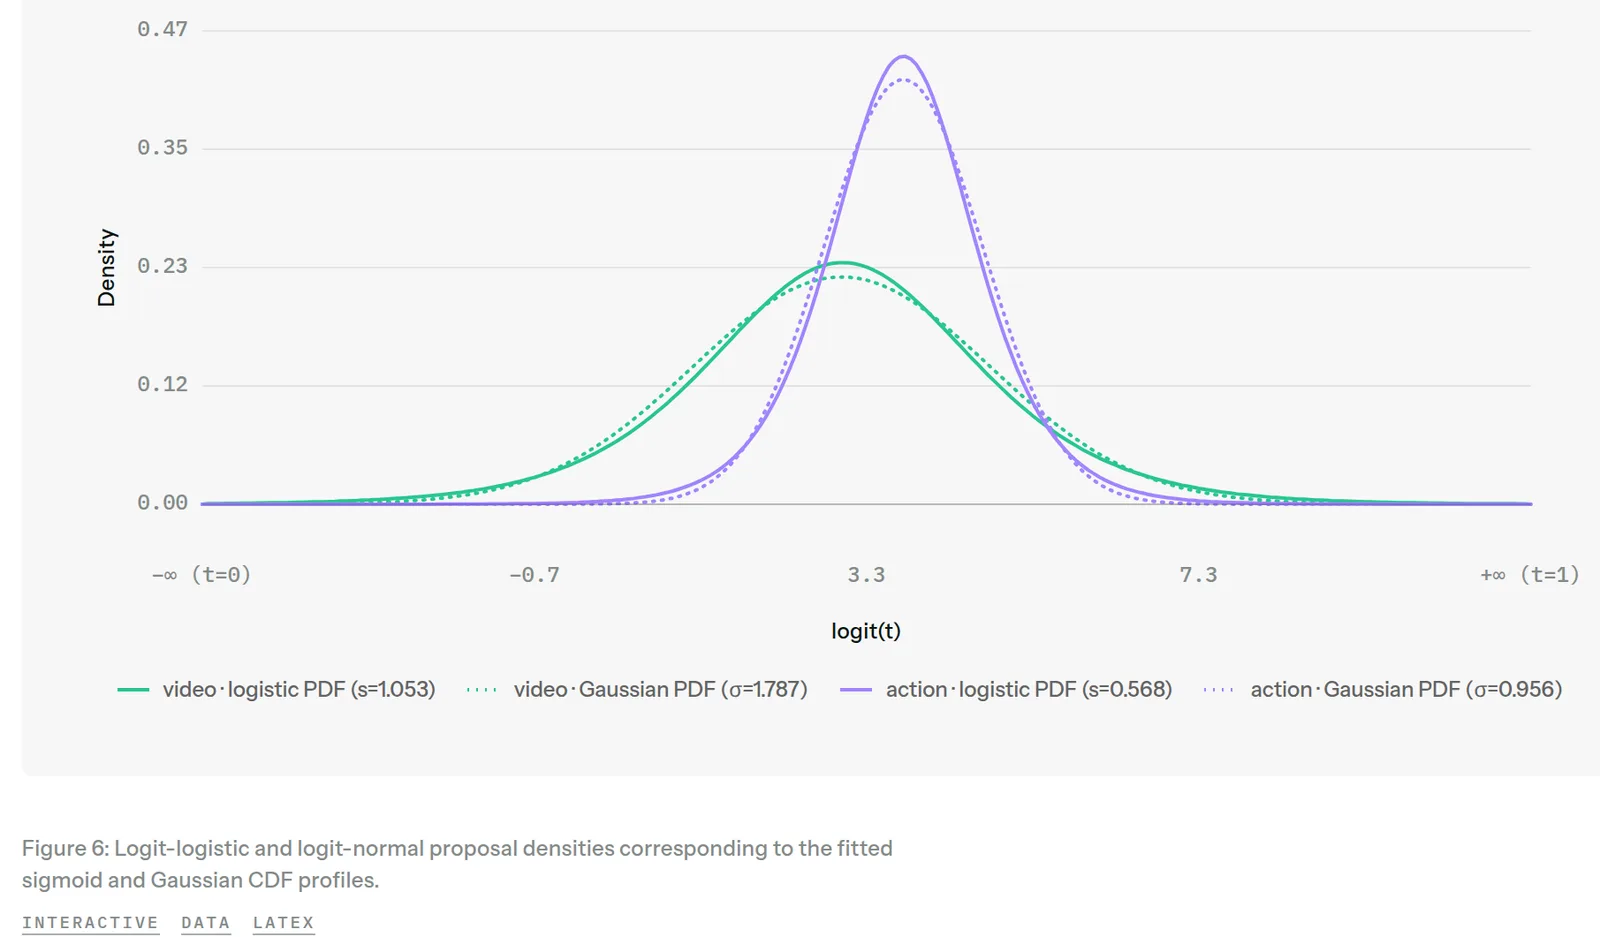
그림 6 — 그림 5의 근사에서 얻은 제안 밀도. 행동 밀도가 로짓 시간 단계 축에서 영상보다 늦게 정점에 이르고, 로짓 정규 밀도가 로짓 로지스틱보다 좁습니다.
시간 단계 분포와 행동 척도 탐색
이 추정치를 격자 탐색의 길잡이로 썼습니다. 후보는 로짓 정규, 로짓 로지스틱, 그리고 Cosmos 3가 쓴 "mode-sampler"(Waver) 분포입니다. 세 분포 모두 0을 중심으로 한 기본 분포에 이동 함수 를 적용해 위치를 정하고, 로짓 정규와 로짓 로지스틱은 이 이동으로 최빈값이 로 옮겨 갑니다.
| 분포 | 이동 α | 척도 |
|---|---|---|
| 로짓 정규 | 24, 33, 42 | 분산 1 |
| 로짓 로지스틱 | 24, 33, 42 | 0.5, 0.75 |
| Waver | 2.5, 5, 10 | — |
α 값 24·42는 그림 6의 영상·행동 최빈값에 해당하고 33은 그 중간입니다. Waver는 Cosmos 3를 따라 α=5와 그보다 높고 낮은 값을 넣었습니다.
여기에 행동 표현의 척도 (시간 단계 분포의 척도와는 다른 것)를 하나 더 탐색했습니다. 행동에만 를 곱하면 그림 5에서 두 모달리티의 전이가 서로 밀립니다. 이면 신호를 지우는 데 잡음이 더 필요해 행동 곡선이 오른쪽으로 갑니다. 두 모달리티 , 의 전이 모양이 비슷할 때 로 두면, 가 잡음에서 신호로 바뀌는 동안 은 거의 잡음이고, 이 전이할 때는 가 이미 거의 신호입니다. 그래서 하나의 공동 flow matching 모델이 사실상 순서의 인수분해를 근사합니다. 이면 반대 순서가 됩니다. 탐색에는 를 쓰고, 손실 가중치 효과를 통제하기 위해 행동 손실에 를 곱했습니다.
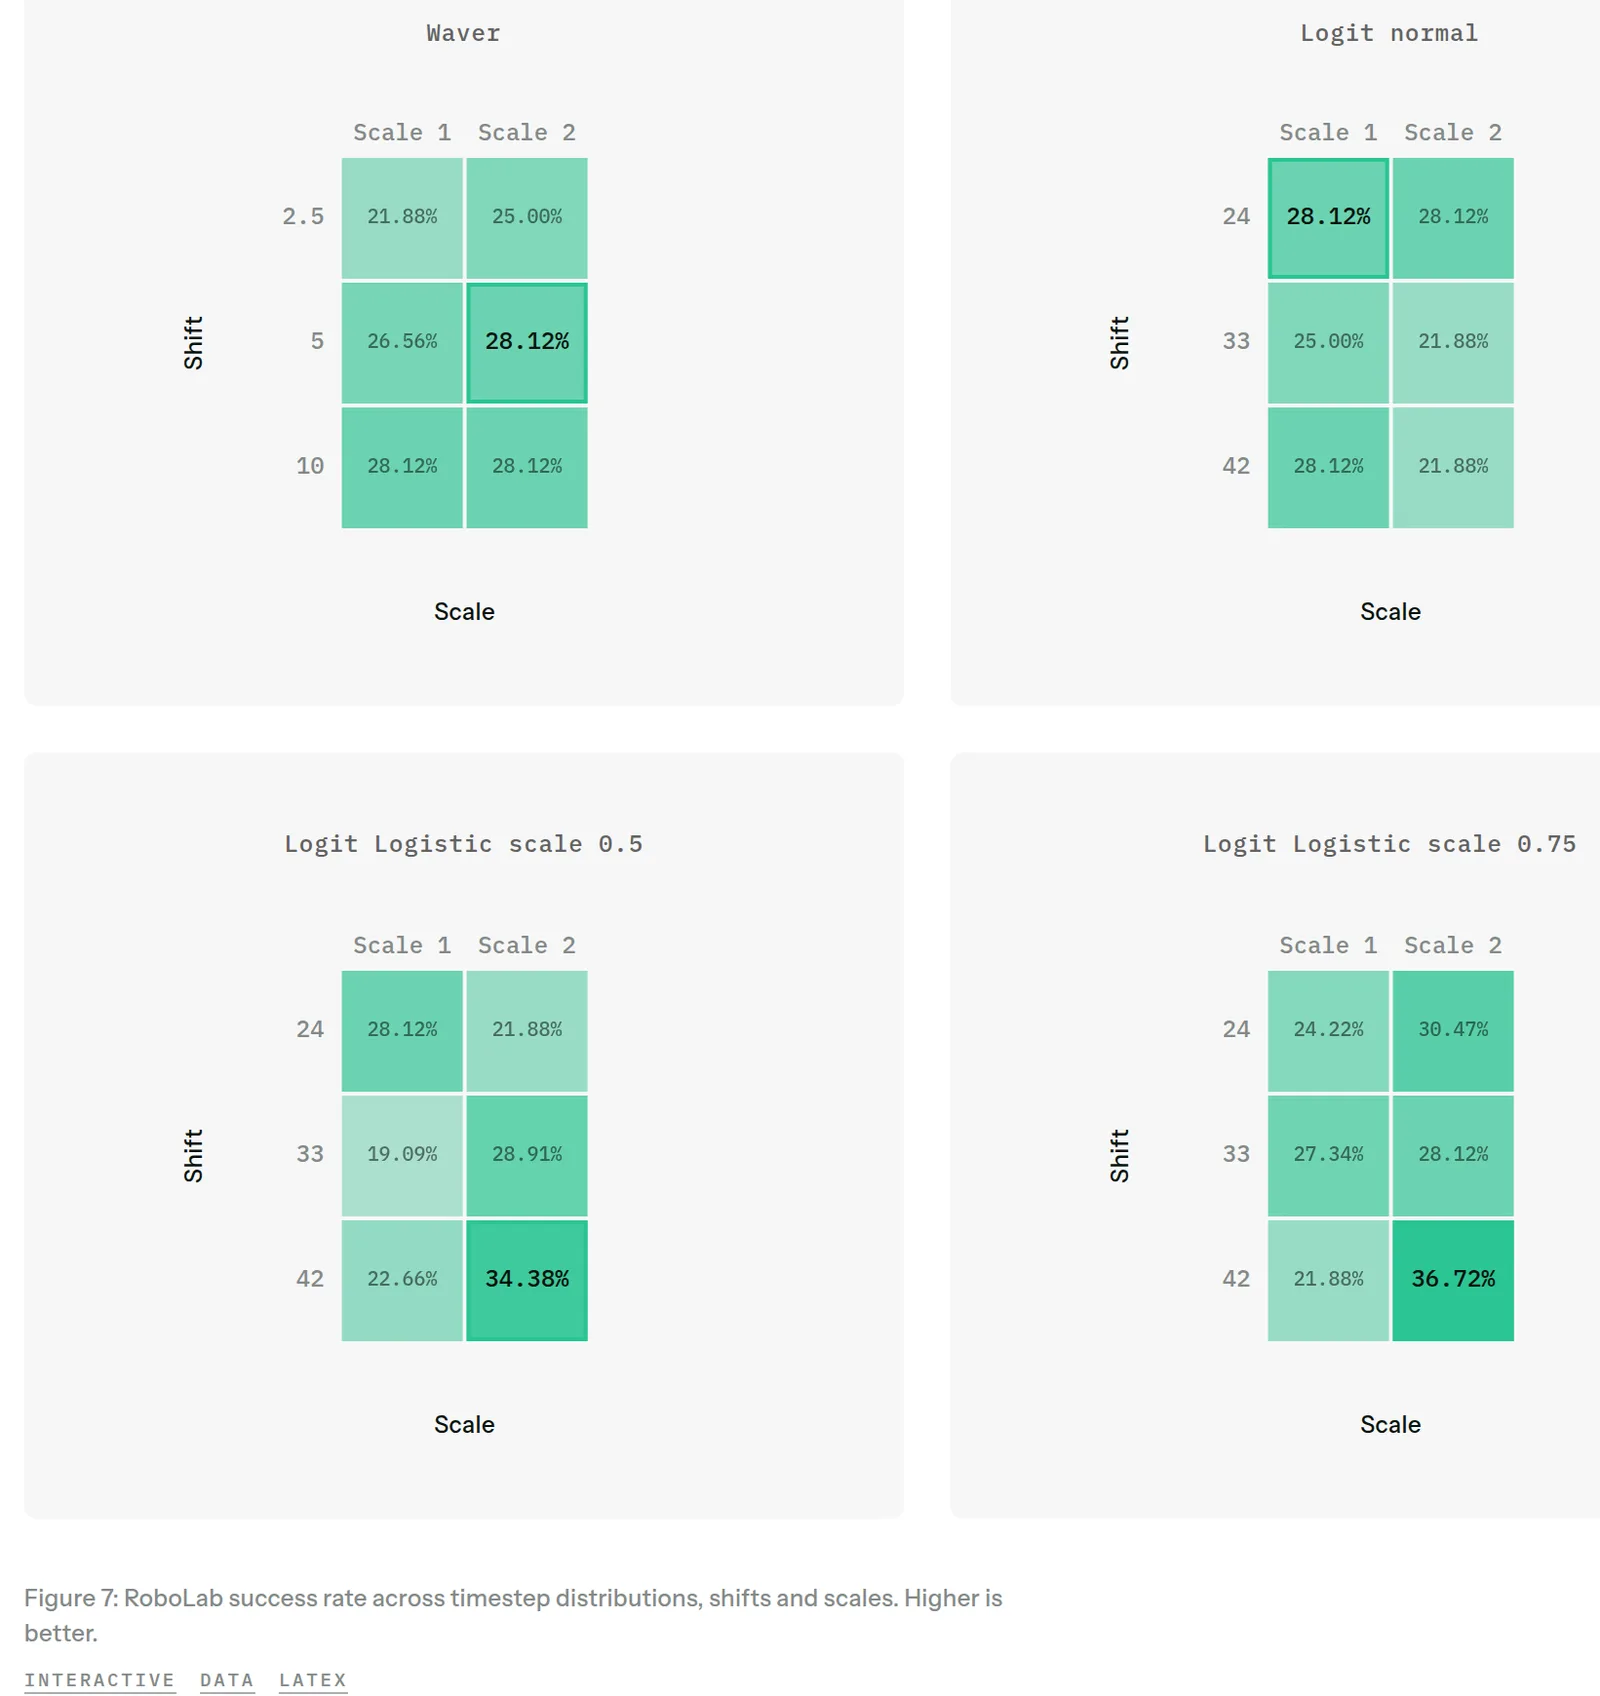
그림 7 — RoboLab 단순 과제 묶음에서 시드 여러 개로 잰 결과. 가장 높은 중앙값은 로짓 로지스틱 척도 0.75, 이동 42, 행동 척도 2의 36.72%입니다.
뚜렷한 경향은 찾지 못했지만, 로짓 로지스틱 분포에 행동 척도 , 큰 이동 α = 42를 쓴 조합이 꾸준히 좋았습니다. 로짓 로지스틱의 두 척도 가운데 더 넓은 0.75가 가장 좋아 이 설정으로 이어 갔습니다.
5. DROID 미세조정 방법
새 헤드를 붙일 때의 워밍업
DROID로 미세조정할 때는 중간학습 체크포인트에 무작위 초기화한 행동 헤드를 붙입니다. 그러면 초반 기울기가 매우 거칠어 중간학습 가중치를 망가뜨릴 수 있습니다. 이를 막기 위해 처음 1k 걸음은 중간학습 가중치를 얼리고, 이후 2k 걸음에 걸쳐 학습률을 0에서 2e-4로 선형으로 올립니다. 행동 헤드의 학습률은 처음 1k 걸음 동안 0에서 1e-3으로 올립니다.
비교 대상은 DROID의 말단장치 자세를 EE50 행동 공간으로 바꿔 미세조정하는 방식입니다. 이쪽은 행동 헤드가 이미 중간학습에서 초기화돼 있어서, 모든 파라미터에 처음 1k 걸음 동안 0에서 2e-4로 올리는 단순한 워밍업만 씁니다. 두 설정을 배치 512와 2048로 각각 2만 걸음 학습했습니다.
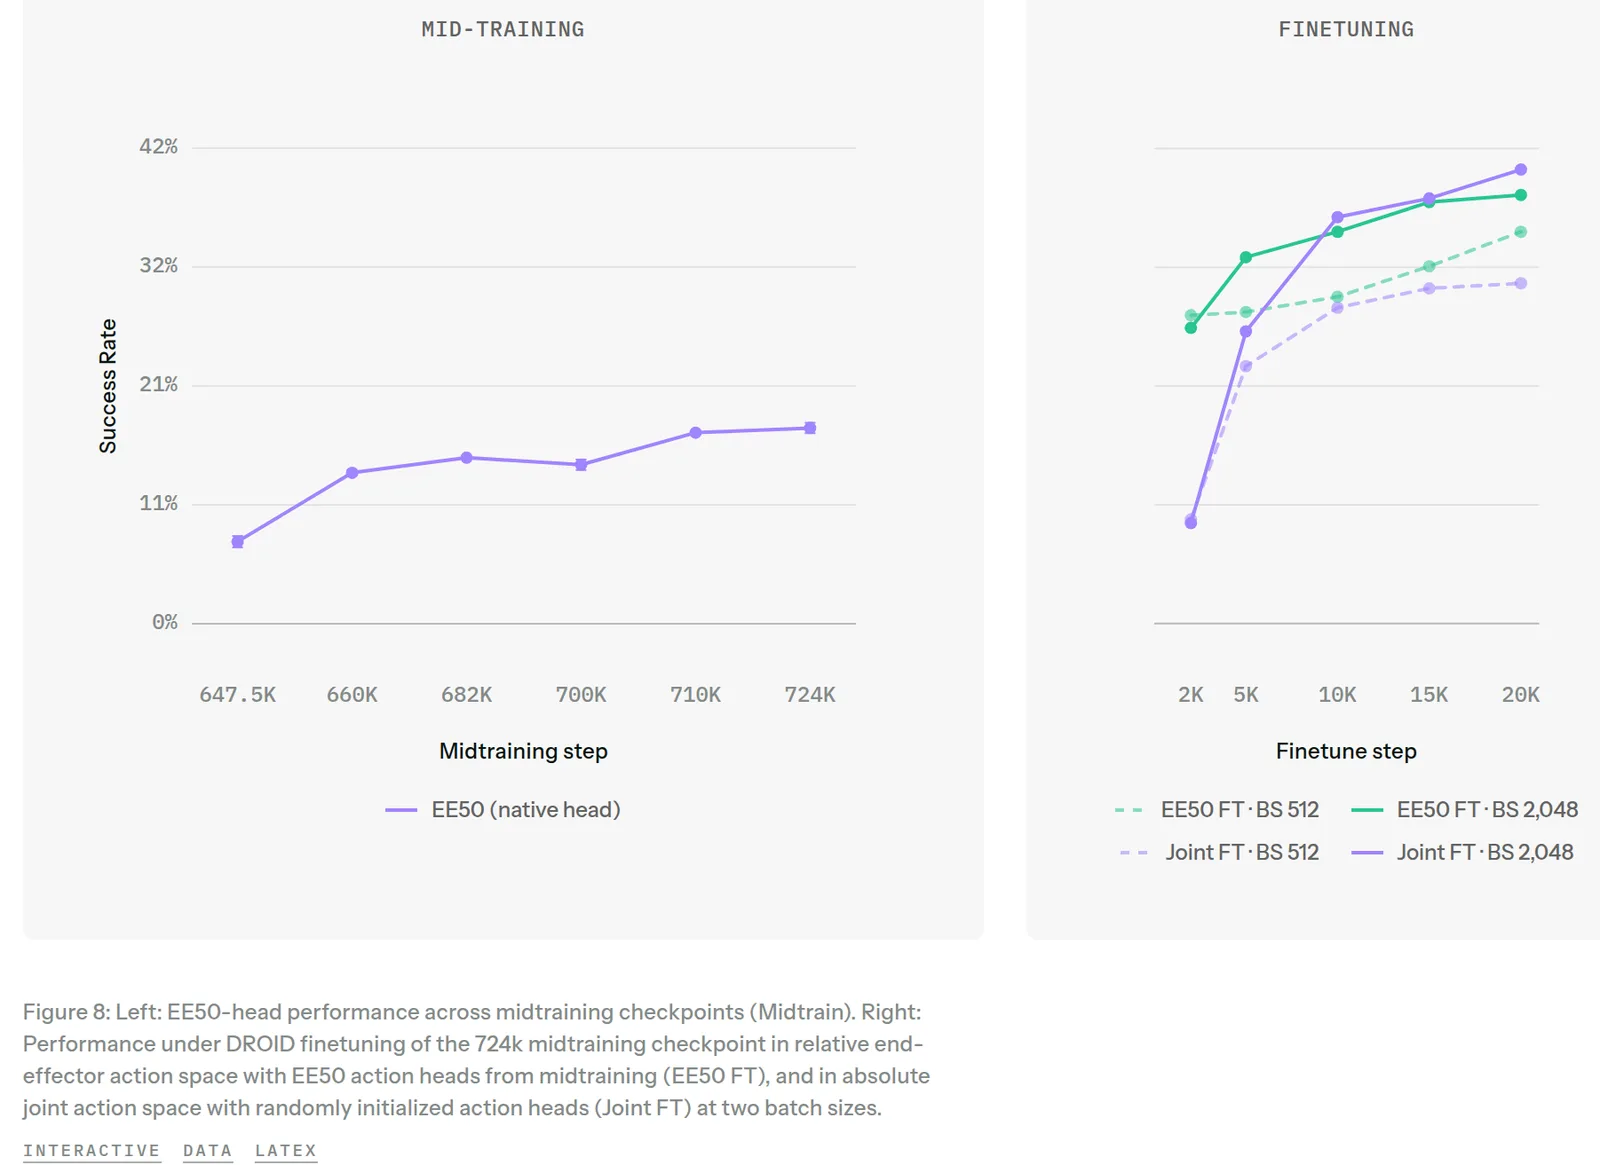
그림 8 — 왼쪽은 중간학습 체크포인트별 EE50 헤드 성능, 오른쪽은 724k 체크포인트를 EE50 상대 말단장치 공간(EE50 FT)과 새 헤드의 절대 관절 공간(Joint FT)으로 미세조정한 결과입니다. 배치 2048의 관절 미세조정이 2만 걸음에서 가장 높습니다.
작은 배치에서는 EE50 미세조정이 관절 미세조정보다 계속 높습니다. 성능은 배치 크기에 따라 잘 늘고, 같은 연산량으로 맞춰 비교해도 손해가 작습니다. 배치를 4배로 키운 실행의 5k 걸음 성능은 작은 배치의 2만 걸음 성능보다 EE50에서 2.25pp, 관절에서 4.25pp 낮을 뿐입니다. 그러나 큰 배치에서 1만 걸음이 지나면 관절 미세조정이 최종 40.13%로 EE50의 37.88%를 앞섭니다. 저자들은 관절 미세조정을 택하면서도, 데이터나 학습 걸음이 아주 적을 때는 EE50 미세조정이 좋은 선택일 수 있다고 적습니다. 시간 단계 분포를 관절 미세조정 성능으로 골랐다는 점도 감안해야 합니다.
포화 확인
성능이 포화했는지 보려고 관절 실행을 총 3만 걸음까지 이어 가며 마지막 5k 걸음에 학습률을 선형으로 낮췄고, 이 구간에서 1k 걸음마다 평가해 가장 좋은 체크포인트를 골랐습니다.
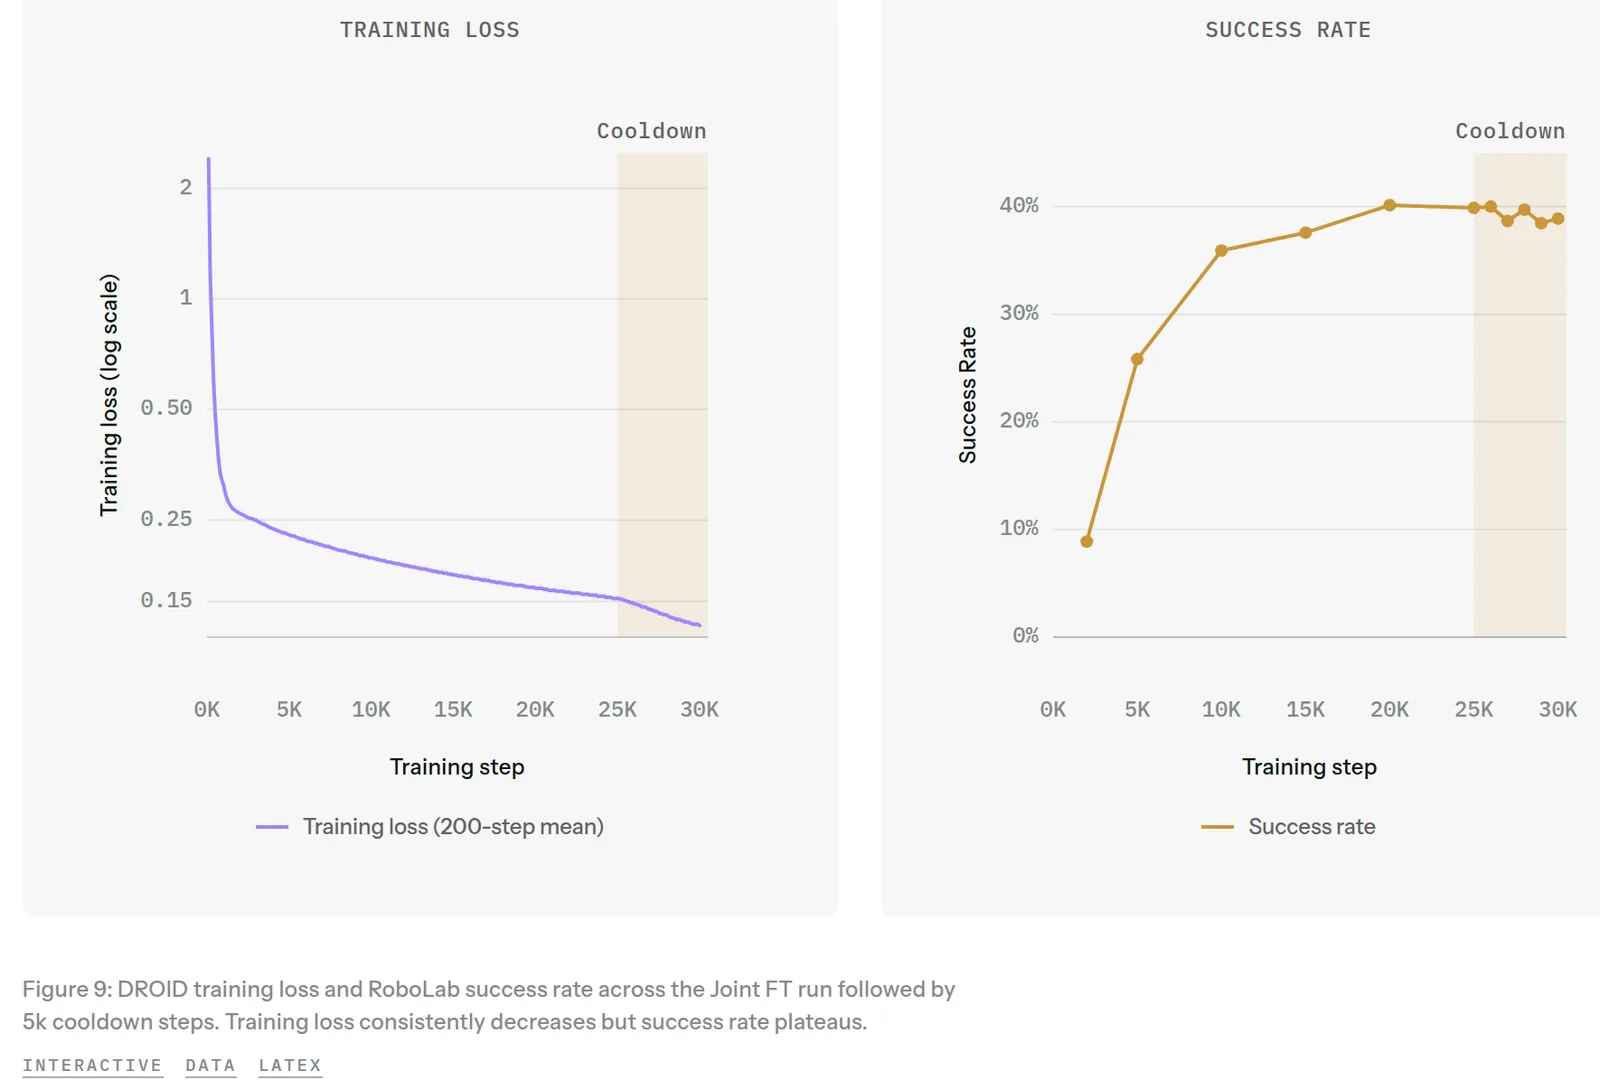
그림 9 — 학습 손실은 3만 걸음까지 계속 내려가고 학습률을 낮추는 구간에서 더 빨리 떨어지지만, RoboLab 성공률은 2만 걸음 이후 약 40%에서 멈춥니다. 최고치는 2만 걸음의 40.13%입니다.
학습 손실이 계속 좋아져도 2만 걸음 이후로는 성공률이 오르지 않았고, 학습률을 낮추는 구간의 최고 체크포인트는 26k 걸음의 40%였습니다.
손실 급등과 되돌리기
기본 학습률 2e-4 근처나 그 이상에서는 손실 급등(loss spike)이 가끔 일어났습니다.
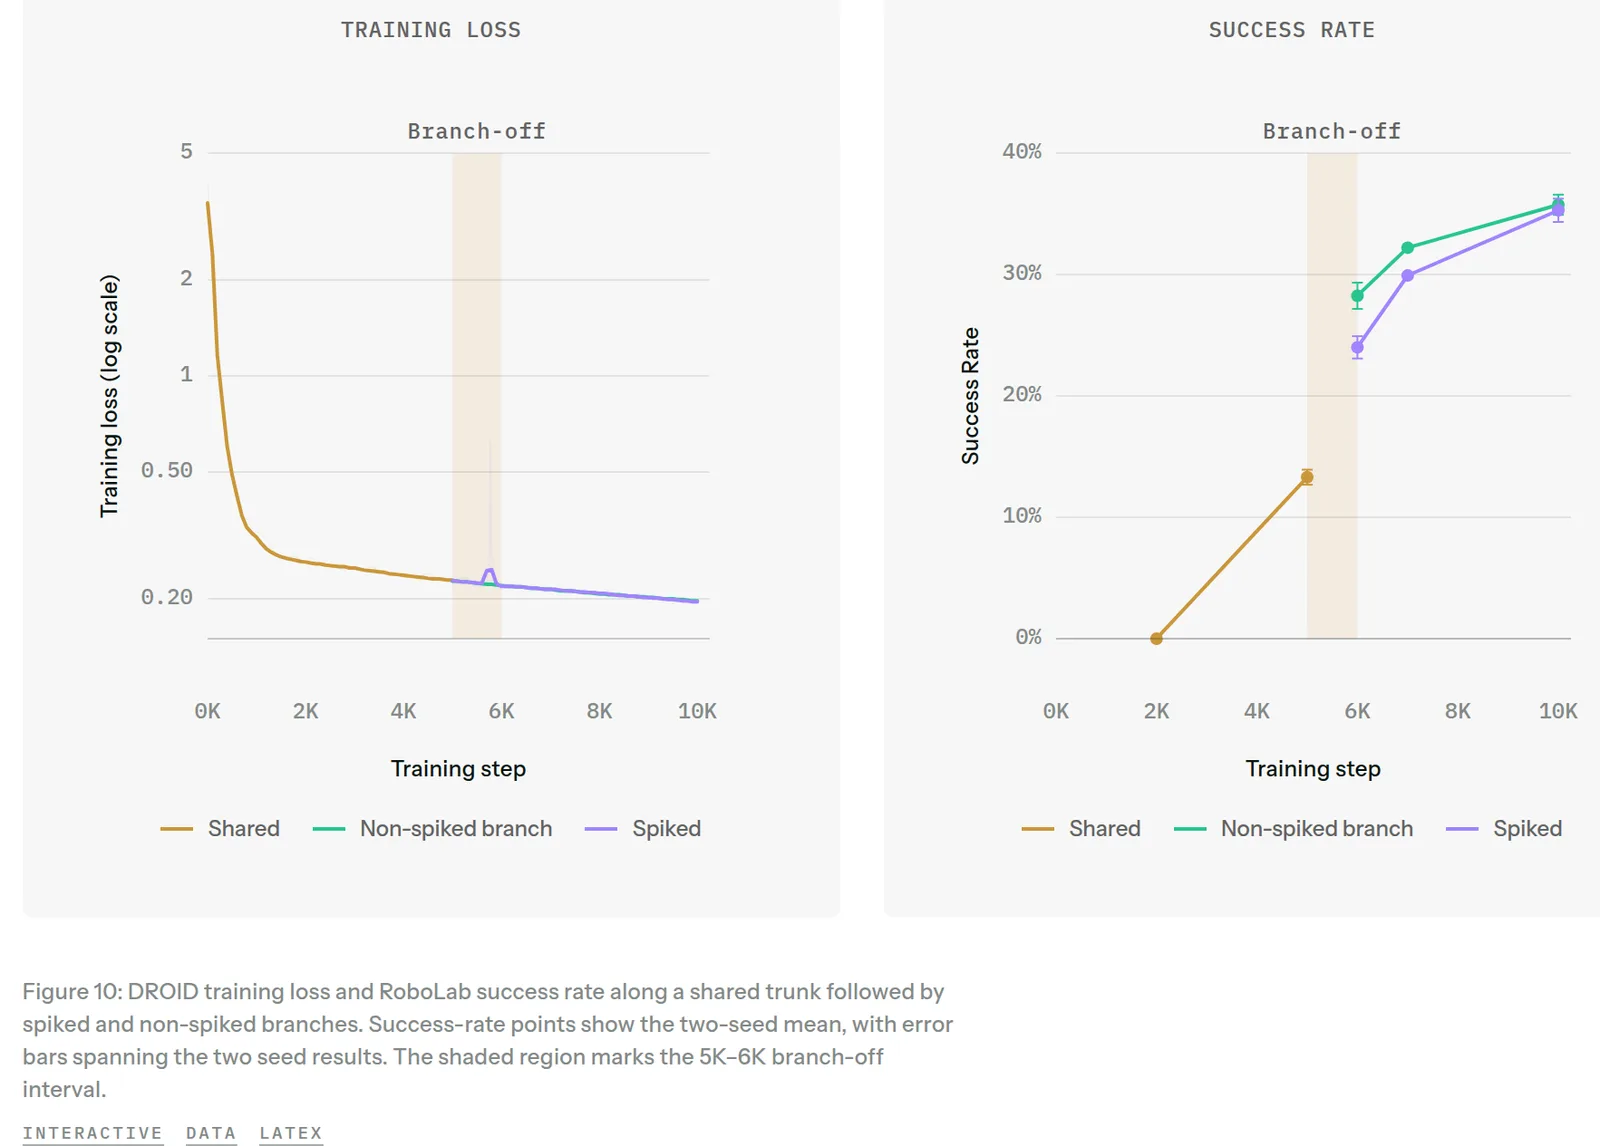
그림 10 — 공통 줄기에서 갈라진 급등 가지와 비급등 가지. 5.8K 걸음 부근의 급등으로 6K 걸음 성공률이 24.0%로 떨어졌고 비급등 가지는 28.25%입니다. 차이는 학습이 이어지며 좁혀져 두 가지 모두 1만 걸음에서 약 35%에 이릅니다.
이 경우는 결국 회복했지만, 회복이 훨씬 오래 걸려 학습 기간 안에 성능이 모자란 경우도 있었습니다. 그래서 체크포인트를 공정하게 비교하고 최종 성능을 해치지 않도록, 손실 급등이 보이면 항상 이전 체크포인트로 되돌렸습니다.
6. 영상과 행동에 따로 거는 안내
행동 묶음 하나를 추론할 때 미래 영상과 미래 행동을 함께 예측하므로, 분류기 없는 안내를 모달리티마다 따로 걸 수 있습니다. 영상 CFG와 행동 CFG를 격자 탐색하고 120개 과제 전체에서 성공률을 평가했습니다.
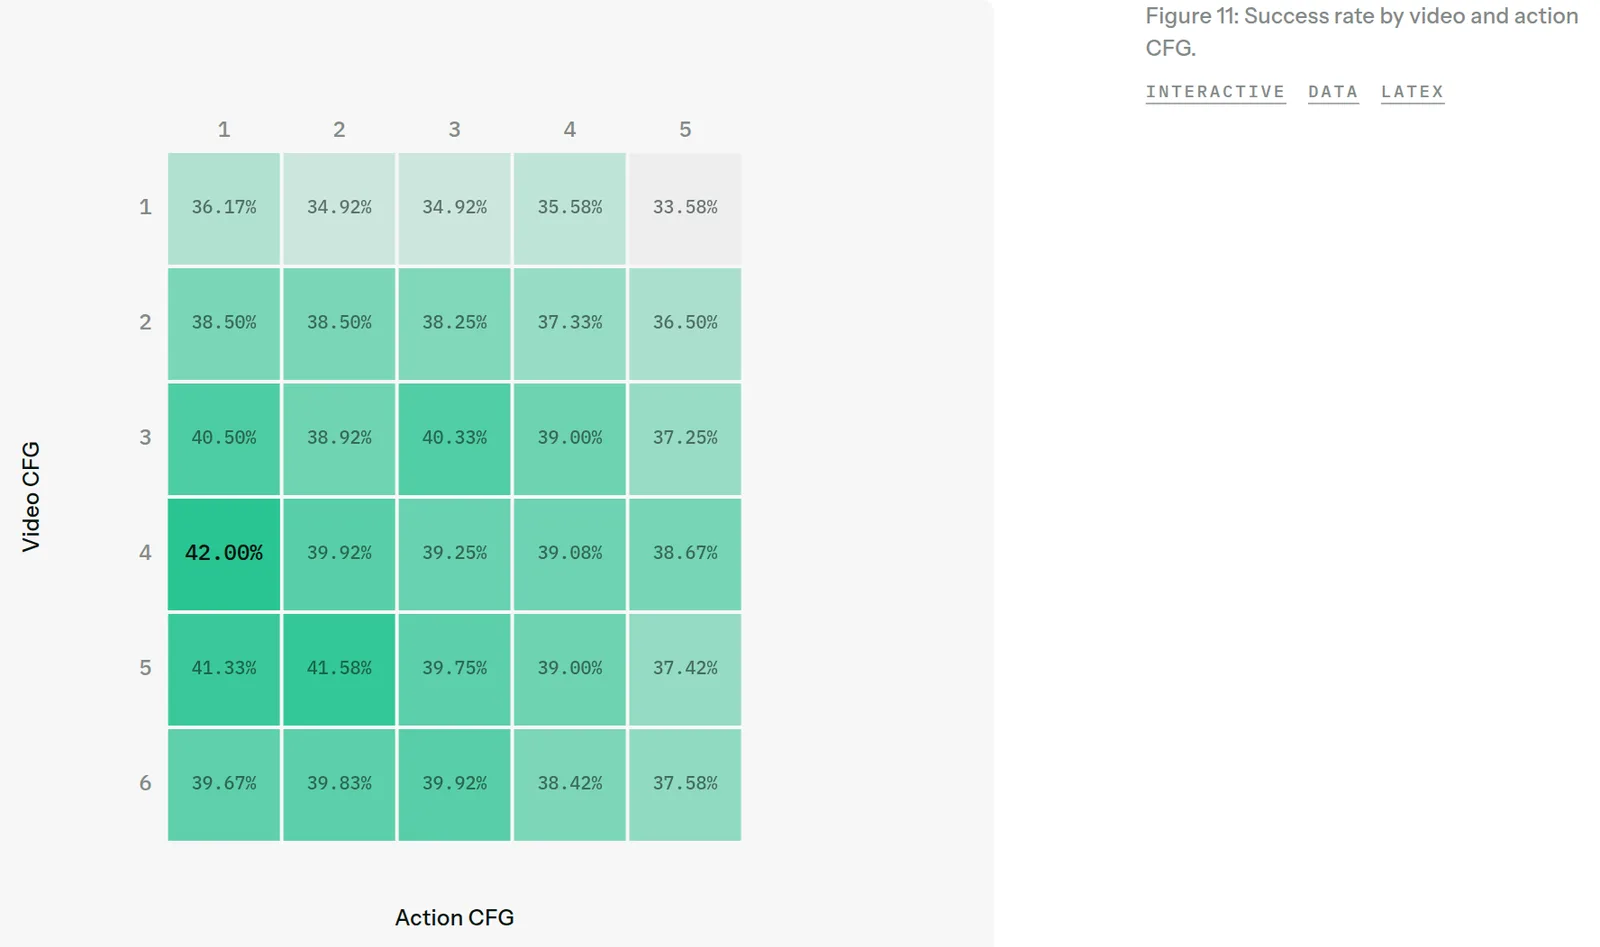
그림 11 — 가장 높은 성공률은 영상 안내 4, 행동 안내 1의 42.00%입니다. 영상 안내를 6으로 올리면 행동 안내 1에서 39.67%로 내려갑니다.
영상 안내는 높게, 행동 안내는 낮게 거는 쪽이 좋다는 경향이 보였고, 영상 CFG 4.0·행동 CFG 1.0을 실사용 추론 설정으로 정했습니다.
7. 지수 이동 평균 분석
지수 이동 평균(exponential moving average, EMA)은 성능에도, 절제 실험을 믿을 만하게 비교하는 데도 중요했습니다. 그래서 전통적인 EMA와 Power EMA(σrel = 0.05, 0.10)를 모두 추적했습니다.
전통적 EMA의 갱신은 다음과 같고, 을 썼습니다.
체크포인트를 걸음마다 저장했으므로 다른 값에 대한 "오프라인" EMA도 계산했습니다. 저장된 스냅숏의 유한 창에서 평균을 내고, 창 안에서 실제로 쌓인 가중치로 정규화합니다.
를 제곱하면 체크포인트 단위 점화식이 걸음 단위 가중치 모양과 맞고(구간 안의 세부는 잃습니다), 분모는 유한 창의 초기 편향을 없앱니다.
Power EMA는 Karras et al.(2024)를 따라 가중치 모양을 상대 폭 로 매개합니다. 학습 중에는 와 두 가지(, )를 추적했습니다. 두 모양을 모든 저장 체크포인트에서 가지고 있으면, 저장된 스냅숏 개의 아핀 결합으로 새로운 값의 EMA를 사후에 더 정확히 재구성할 수 있습니다. 결합 계수는 제약 없는 최소제곱으로 구하므로 음수가 될 수도 있고, 합이 1이 되도록 정규화합니다.
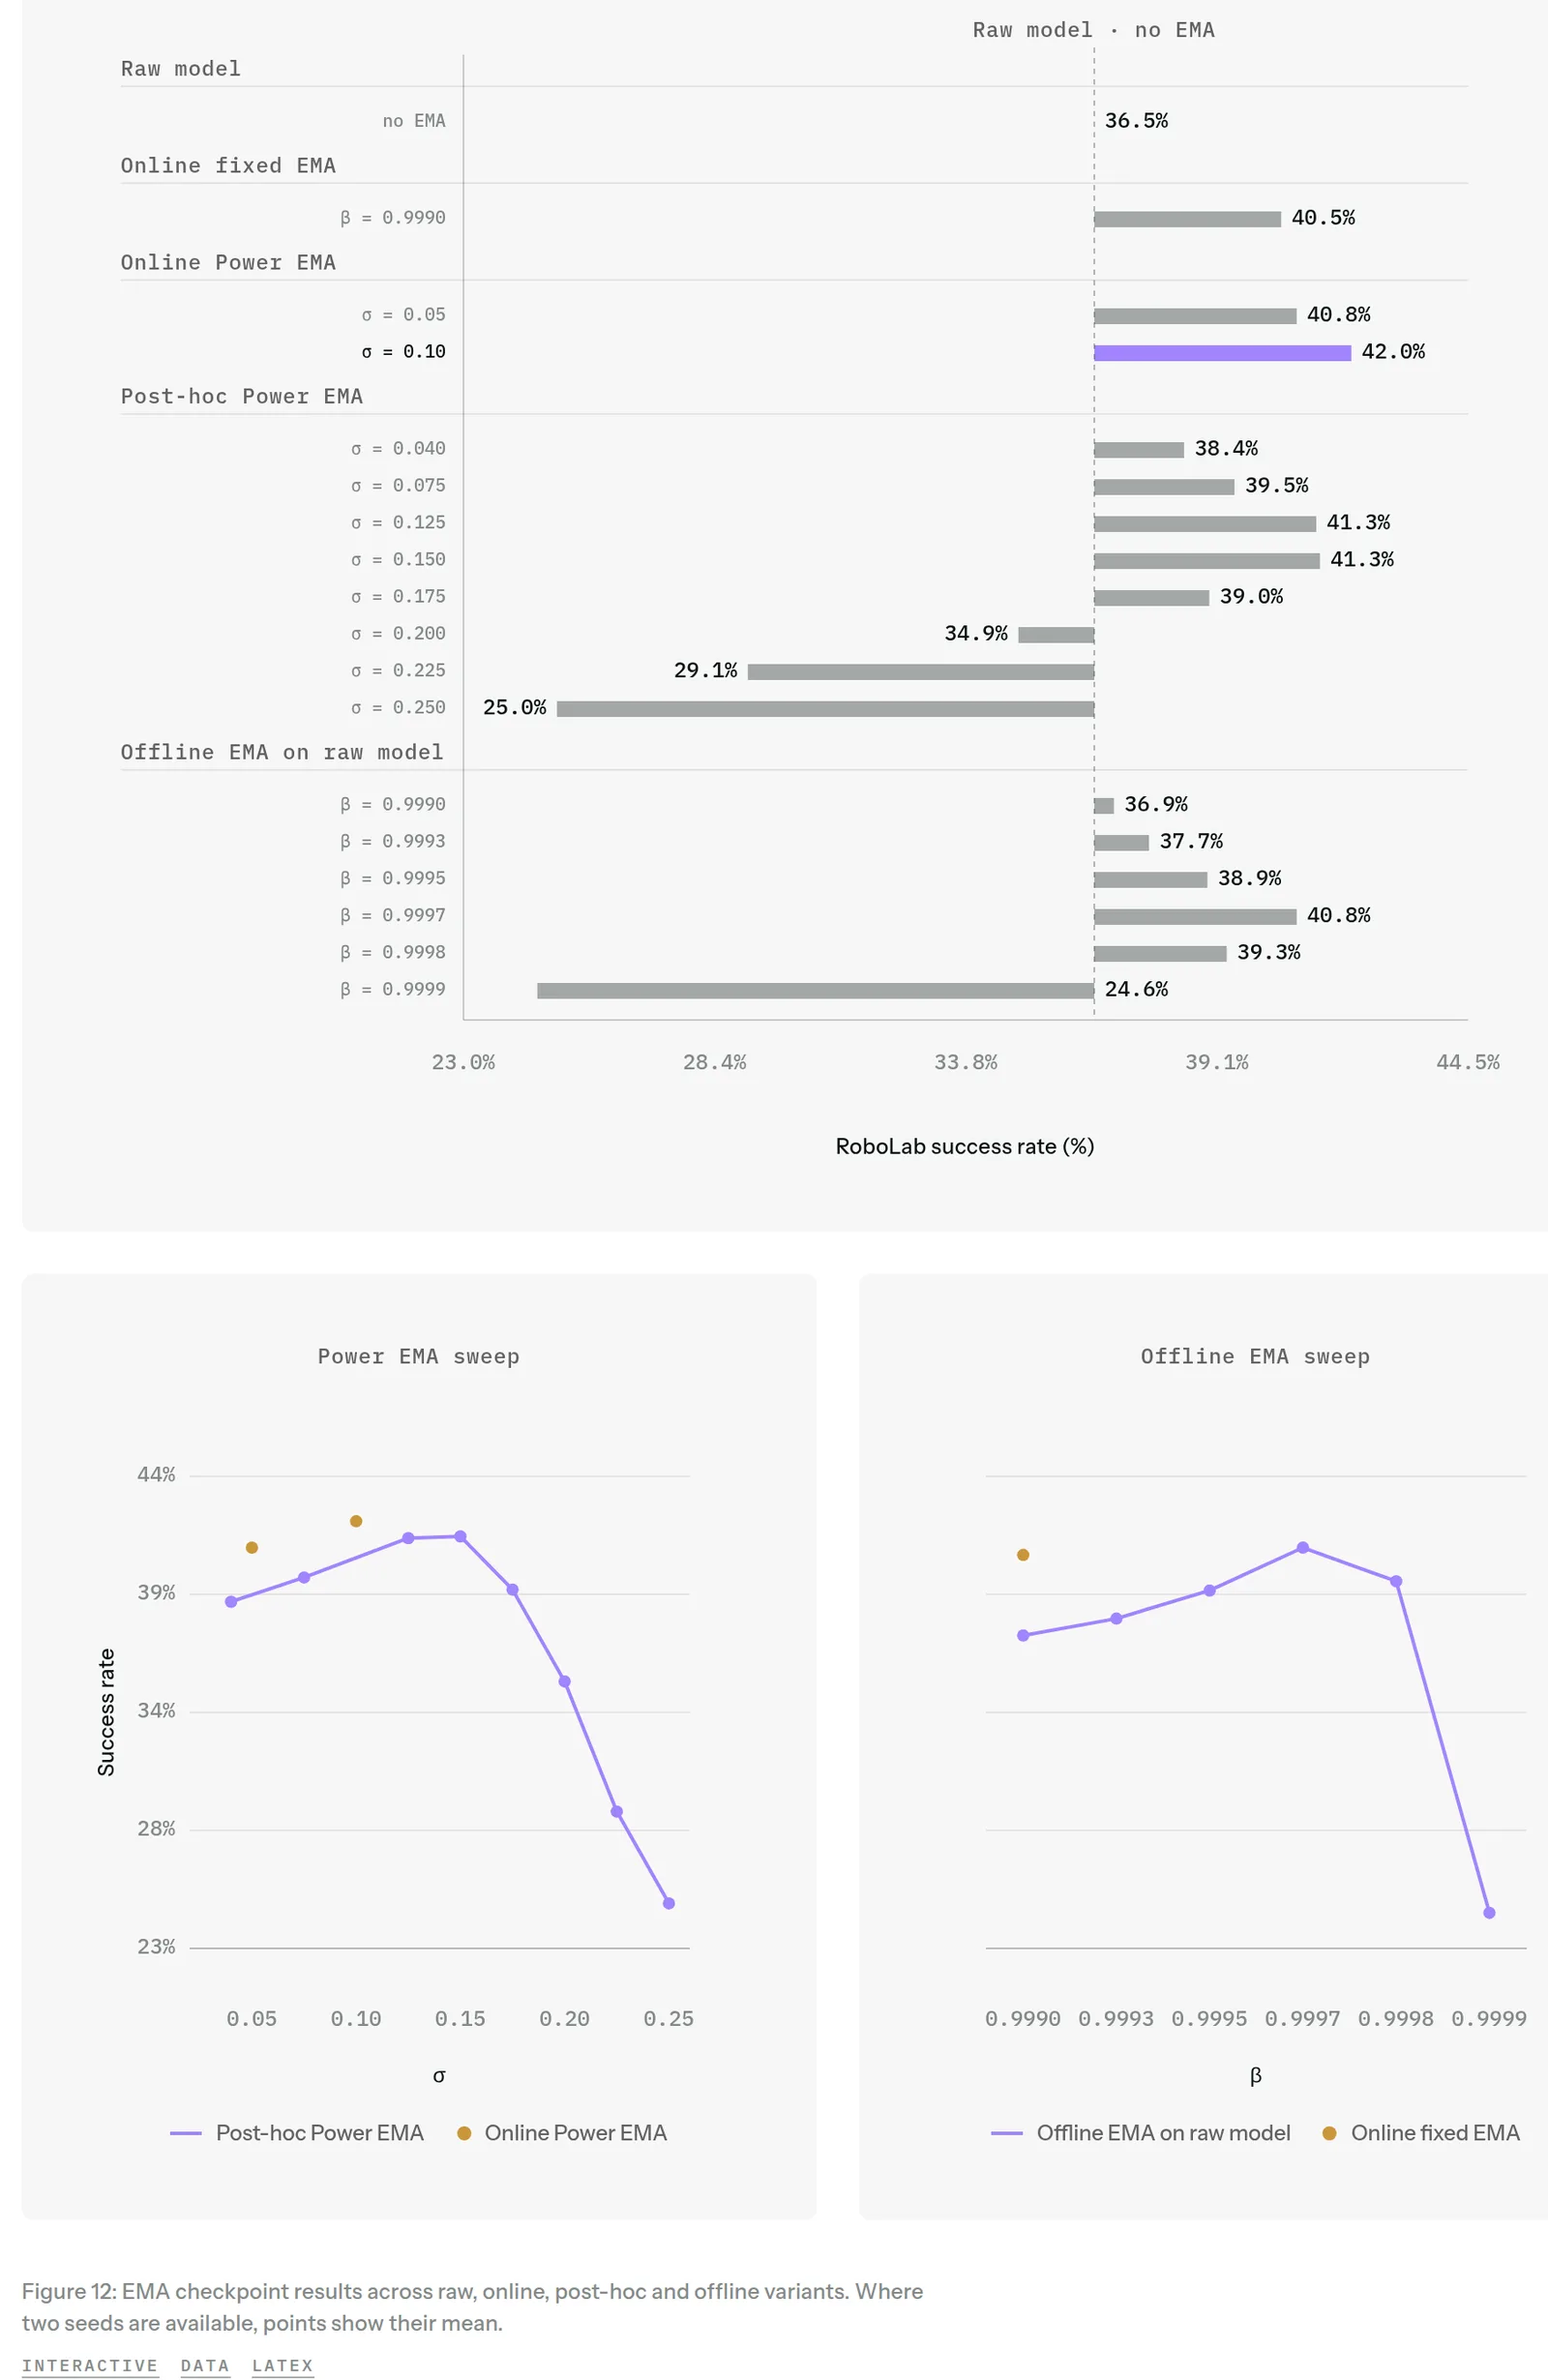
그림 12 — 원 모델·온라인·사후·오프라인 EMA 변형의 결과. 온라인 Power EMA σ 0.10이 42.00%로 18가지 중 가장 높고, EMA가 없는 원 모델은 36.50%입니다. 사후 Power EMA는 σ 0.15에서 41.33%로 정점을 찍고 σ 0.25에서 25%로 떨어지며, 원 모델에 대한 오프라인 EMA는 β 0.9997에서 40.83%가 최고입니다.
온라인 EMA와 두 Power EMA 모두 원 모델보다 확실히 높고, Power EMA가 전통적 EMA보다 조금 앞섭니다. 사후 Power EMA와 오프라인 EMA는 종 모양 경향을 보이며 각각 σrel = 0.150, β = 0.9997에서 정점에 이르지만, 매 걸음 갱신하는 온라인 평균이 사후 근사보다 강합니다. 저자들은 온라인 Power EMA σrel = 0.10을 DROID 미세조정의 권장 설정으로 정했습니다.
8. 추론 효율
안내 증류
WAM은 행동뿐 아니라 영상도 예측하므로 토큰 열이 VLA보다 길어 느립니다. 이전 연구는 대부분 시스템 수준 최적화나, 별도 디코더·어텐션 마스킹으로 영상과 행동을 떼는 방법에 기댔습니다. 저자들은 이와 직교하는 방향으로, 영상과 행동의 공동 예측은 그대로 둔 채 증류만으로 VLA의 효율에 얼마나 다가갈 수 있는지 봤습니다.
첫 번째는 안내 증류(guidance distillation) 입니다. 6절에서 봤듯 안내는 성능을 크게 올리지만 매 샘플링 단계마다 안내 없는 순전파가 한 번 더 필요합니다. 순전파 한 번이 이미 하드웨어의 병렬 용량을 충분히 쓰고 있다면 지연이 약 2배가 됩니다. 두 순전파를 GPU 두 장에 나누면 지연은 숨겨지지만 하드웨어 비용이 2배가 됩니다. 저자들은 F3A DROID 체크포인트에서 학생과 교사를 똑같이 초기화하고, 교사는 얼린 채 DROID 예시에 대한 안내된 예측을 학생의 목표로 줬습니다. 학습 후 학생은 안내 없이 추론하므로 1.8~2배 빨라지고, 성능은 유지되는 데서 그치지 않고 0.6~1.08pp 오릅니다.
단계 증류
두 번째는 단계 증류(step distillation) 입니다. 안내 증류 체크포인트에서 학생과 교사를 초기화하고, 교사의 안내를 받아 학생이 한 단계로 예측하도록 학습합니다. 샘플링 단계를 4분의 1로 줄여 3.15~4배 빨라지는 대신 성공률이 3.51~4.32pp 떨어집니다. 그래도 Cosmos 3보다 1.12~1.88pp 높고 9.19~13.22배 빠릅니다.
π0.5와 비교하면 F3A SD는 성능이 9.92~10.68pp 높고, 실시간 계수(RTF = 처리 시간 / 묶음 길이) 비교는 하드웨어에 따라 달라집니다. 워크스테이션·데이터센터 GPU에서 FP8 F3A SD는 BF16 π0.5보다 1.34~2.28배 빠르지만, RTX 5090 같은 소비자용 GPU에서는 FP8과 BF16에서 각각 1.15배, 2.42배 느립니다.
추론 최적화
불필요한 계산을 잘라 내고, FP8로 돌리고, 지연을 최소화하는 torch.compile(reduce-overhead)을 씁니다. 행 단위 동적 FP8은 성공률에 거의 영향이 없어서, 안내 증류 체크포인트에서 +0.05pp, 단계 증류 체크포인트에서 −0.76pp였고 로컬 GPU(RTX Pro, 5090)에서 1.4배 넘게 빨라졌습니다. 추론 중에는 모드 블록의 프롬프트 토큰이 바뀌지 않으므로 프롬프트가 바뀔 때 한 번만 캐시합니다. 관측이 바뀌어도 한 캔버스의 텐서 모양은 고정이라 효율적으로 컴파일할 수 있습니다. 마지막으로 단계에 무관한 계산과 공유 계산을 블록 밖의 준비 단계로 옮겼습니다.
| 정책 | 예측당 행동 수 | 제어 주기 (Hz) | 전체 묶음 길이 (s) |
|---|---|---|---|
| Pi0.5 | 15 | 15 | 1.00 |
| F3 + C3 | 32 | 15 | 2.13 |
표 3 — 정책 출력과 제어 설정.
| 작업 (B200) | BF16 (ms) | FP8 (ms) |
|---|---|---|
| F3 · 4단계 · 안내 켬 | 246.42 | 182.00 |
| F3 · 4단계 · 안내 끔 | 136.25 | 101.71 |
| F3 · 1단계 · 안내 끔 | 41.06 | 32.29 |
| Cosmos 3 Nano · 4단계 · 안내 켬 | 387.71 | 320.40 |
| π0.5 · 10단계 · 안내 끔 | 31.99 | 평가 안 함 |
표 4 — 예측한 행동 묶음 하나당 종단간 지연의 중앙값. 원문은 GPU별(B200·H200·RTX 6000 Pro·RTX 5090)로 보여 주고, 여기서는 B200 값만 옮겼습니다. 프롬프트 텍스트는 캐시하고 카메라 인코딩은 요청마다 다시 계산합니다.
| 설정 | 시드 수 | 평균 ± 표준오차 (%) |
|---|---|---|
| 기본 BF16 | 6 | 41.60 ± 0.46 |
| 기본 FP8 | 8 | 41.16 ± 0.30 |
| 안내 증류 BF16 | 6 | 42.19 ± 0.39 |
| 안내 증류 FP8 | 6 | 42.24 ± 0.36 |
| 단계 증류 BF16 | 6 | 38.68 ± 0.29 |
| 단계 증류 FP8 | 6 | 37.92 ± 0.31 |
표 5 — 기본·안내 증류·단계 증류 정책의 BF16·FP8 RoboLab 성공률.
9. 실제 로봇 평가
Franka 제3자 평가
정책을 외부 기관이 독립적으로 평가했습니다. Positronic Robotics가 자기 연구실의 Franka 팔로 DROID 과제 10개를 과제당 세 번씩 돌리며 Cosmos3-Nano, DreamZero, π0.5와 비교했습니다. 모든 모델이 같은 과제, 같은 설정, 시도당 같은 240초 제한, 같은 채점 기준을 받았고, 조작자는 어떤 모델이 로봇을 움직이는지 몰랐으며 모든 시도를 녹화했습니다. F3A는 30번 중 28번 성공했습니다.
| 과제 | F3A | Cosmos 3 Nano | DreamZero | π0.5 |
|---|---|---|---|---|
| Sponge in bowl | 2/3 | 3/3 | 1/3 | 1/3 |
| Put cube in bowl | 3/3 | 3/3 | 3/3 | 1/3 |
| Yellow block in blue cup | 3/3 | 1/3 | 3/3 | 1/3 |
| Put fork on plate | 3/3 | 3/3 | 2/3 | 2/3 |
| Banana on left plate | 3/3 | 3/3 | 3/3 | 3/3 |
| Marker in bowl | 2/3 | 3/3 | 3/3 | 1/3 |
| Cup in bowl | 3/3 | 3/3 | 2/3 | 3/3 |
| Yellow block in cup | 3/3 | 2/3 | 1/3 | 1/3 |
| Move cup left | 3/3 | 3/3 | 0/3 | 0/3 |
| Close the drawer | 3/3 | 3/3 | 2/3 | 0/3 |
| 전체 | 93.3% 28/30 | 90.0% 27/30 | 66.7% 20/30 | 43.3% 13/30 |
표 6 — 물체 하나짜리 실제 로봇 과제 성공률.
그림 13 — "Put the cube in the bowl" 과제 영상의 한 장면.
그림 14 — "Move the cup to the left" 과제 영상의 한 장면.
그림 15 — "Put the sponge in the bowl" 과제 영상의 한 장면.
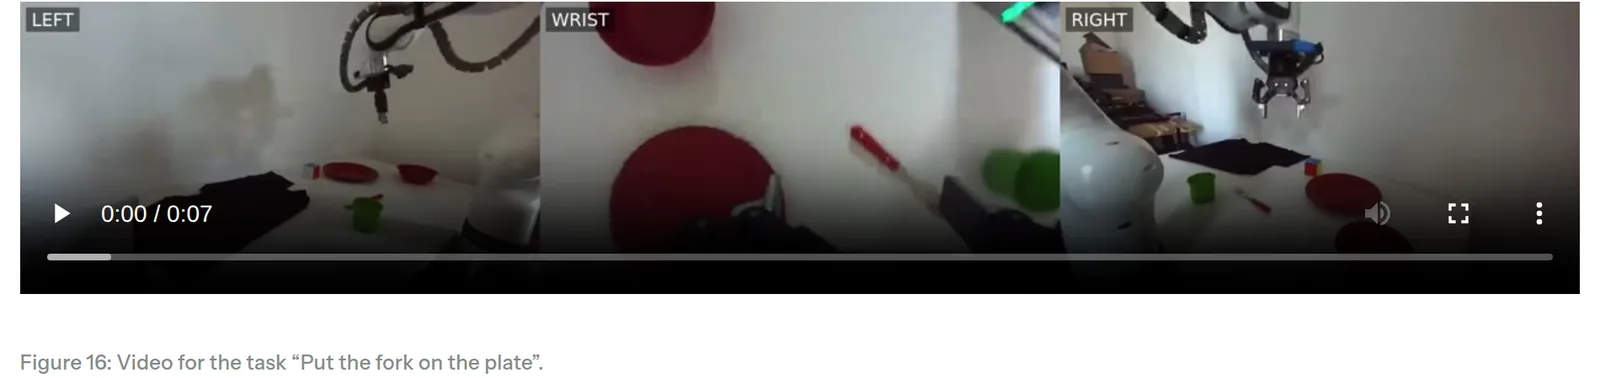
그림 16 — "Put the fork on the plate" 과제 영상의 한 장면.
SO-101 적용
같은 미세조정 방법을 저가 팔 SO-101에도 적용했습니다. 원격조작으로 작은 데이터셋을 모아 그 위에서 미세조정했고, 학습 분포 안의 과제와 함께 물체·용기·카메라가 바뀌는 분포 밖 상황에서의 일반화를 보여 줍니다.
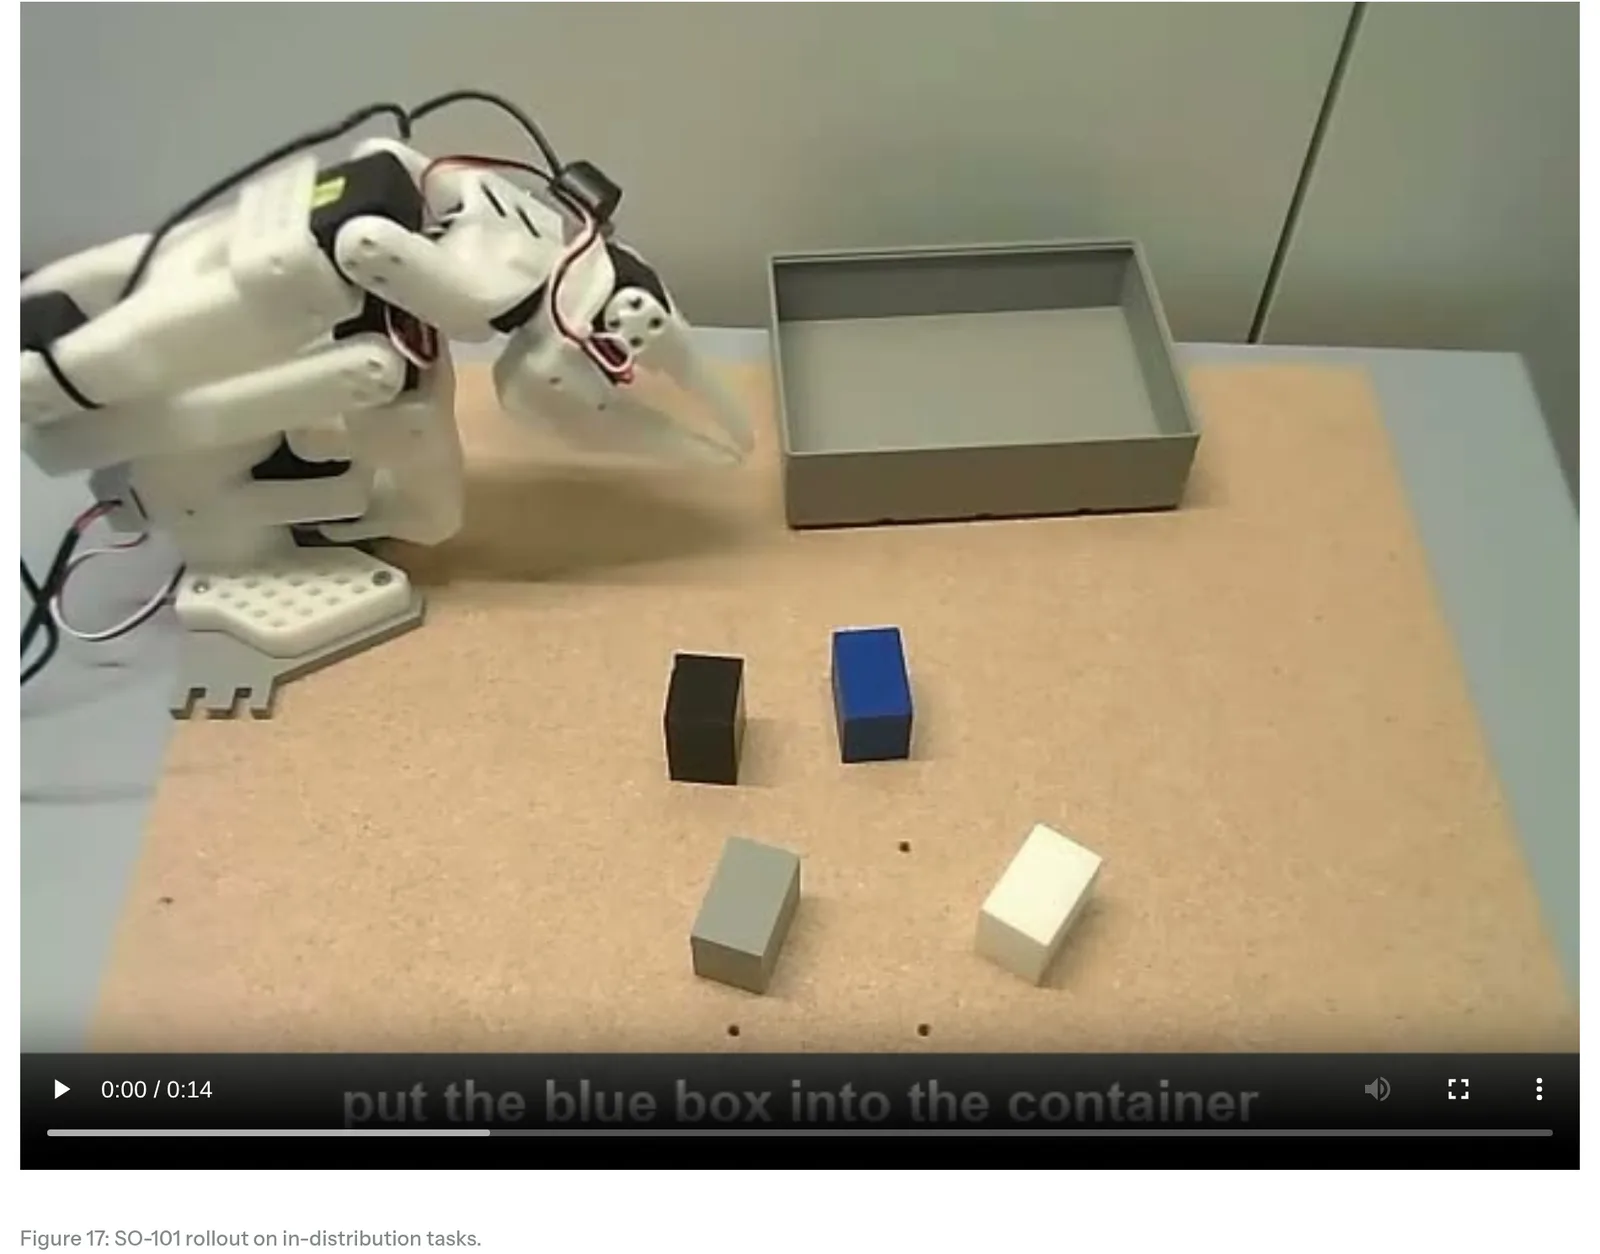
그림 17 — 학습 분포 안의 과제에서 SO-101이 실행한 장면.
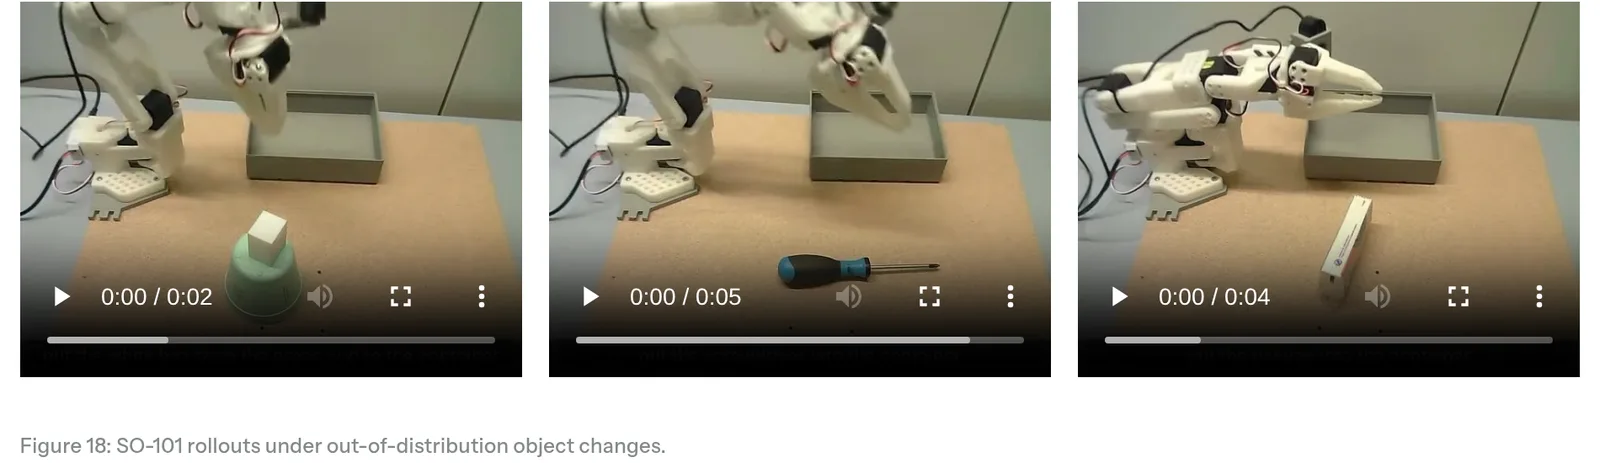
그림 18 — 학습에 없던 물체로 바꾼 경우.
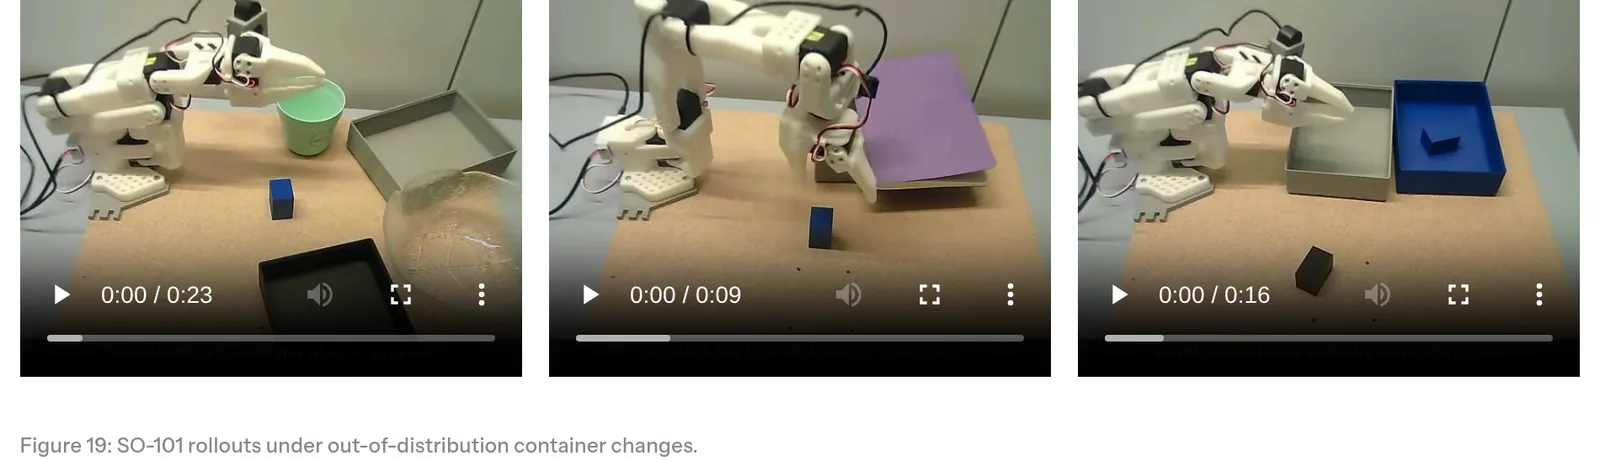
그림 19 — 학습에 없던 용기로 바꾼 경우.
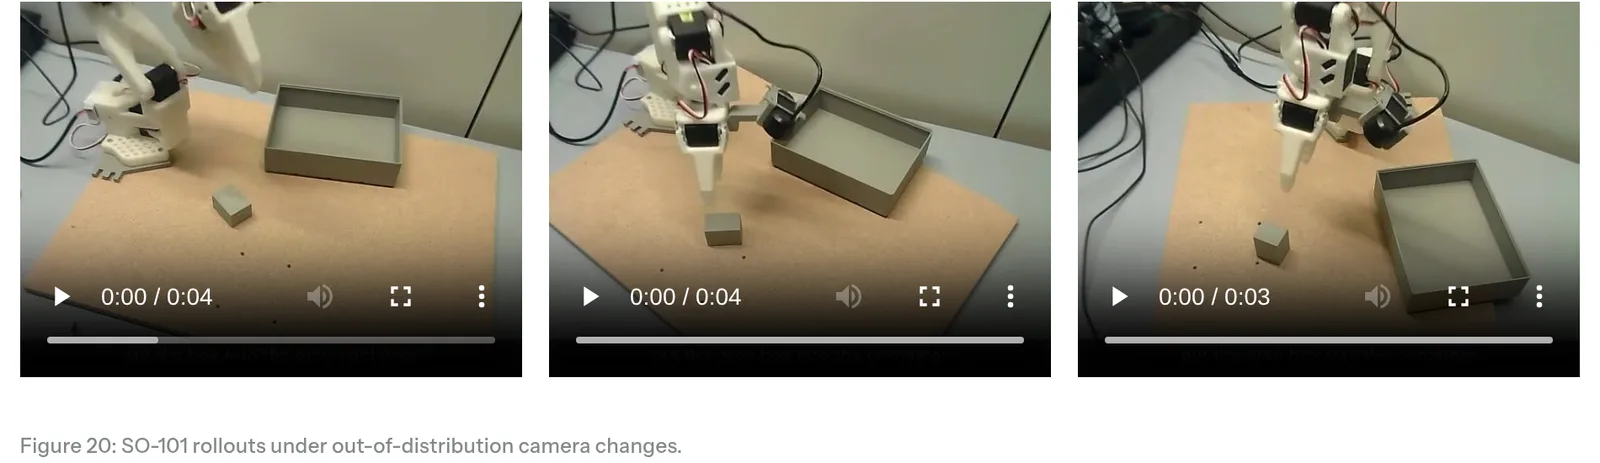
그림 20 — 카메라 위치를 바꾼 경우.
공개된 SO-101 체크포인트는 LeRobot에 통합돼 있습니다. 문서에 따르면 장면 카메라와 손목 카메라 두 대(각 256×256을 이어 붙인 512×256), 관절 5개와 그리퍼로 된 6차원 상태·행동을 쓰고, 42걸음을 예측해 그중 32걸음을 30 Hz로 실행한 뒤 다시 계획합니다. 새 과제 적응용으로 rank 32 LoRA 설정이 함께 제공되며, 문서의 예시는 원격조작 시연 약 200개로 학습했습니다. BF16 추론에는 GPU 메모리 약 32GB가 든다고 적혀 있습니다.
10. 혼합 정책 — 추론 모델과의 결합
실험 설정
F3A는 소비자용 하드웨어에서도 순전파 한 번으로 로봇 궤적을 만들고 넓은 범위의 조작 과제를 풉니다. 하지만 긴 과제를 쪼개거나 여러 단계 계획을 세워야 하는 과제에는 직관적인 제어 이상의 능력이 필요합니다. GPT 6 Astra 같은 추론 에이전트는 이 능력이 있고 최근 인상적인 제어 결과도 보였지만, 추론 호출이 평균 16초 걸려 정책으로 직접 돌리기에는 비현실적입니다. Su et al.(2026)이 GPT 6 Astra와 π0.5를 결합한 첫 결과를 냈고, 저자들은 이 결합이 체화 추론의 효율을 높이는지, 그리고 F3A처럼 좋아진 정책이 그 효율 개선으로 이어지는지를 물었습니다.
Su et al.(2026)의 설정을 그대로 재현했습니다. 매 에피소드마다 GPT 6 Astra가 이력을 기억하는 에이전트로 돌고, 매 차례 행동 정책(F3A 또는 π0.5)이 현재 관측과 상태로 예측을 냅니다. 관절 예측을 순기구학으로 말단장치 자세로 바꿔 관측·고유수용 상태와 함께 Astra에 주면, Astra는 네 가지 중 하나를 고릅니다.
- 정책이 예측한 행동 일부를 실행
- 정책의 행동 1~5개를 수정
- 자기 행동을 직접 제안
- 중단
결정된 행동은 RoboLab에서 역기구학으로 실행되고 이 순환이 반복됩니다. 다른 정책의 예측 없이 Astra가 매번 직접 행동을 내는 순수(pure) 변형도 넣었습니다. 저자들은 원 논문의 결과를 재현했고, 모든 Astra 호출의 시간과 토큰 수를 모아 효율을 추정했으며, F3A를 추가하고 추론 노력 세 수준(low, medium, xhigh)으로 모든 변형을 돌렸습니다.
순수 정책과 순수 추론의 효율 차이
표 7에서 가장 비용 효율적인 순수 Astra는 xhigh 노력으로 성공당 $13.47이고, 성공당 평균 16분 23초가 걸립니다. low 노력이면 시간은 14분 21초로 줄어듭니다.
F3A의 FP8 단계 증류 체크포인트는 시드 두 개에 걸쳐 정책 호출 4741번으로 147802걸음을 계산해 96번 성공했습니다. H200 기준으로 성공 한 번에 총 104.8초가 걸리는데, 그 대부분은 행동이 실행되는 동안 정책이 기다리는 시간입니다. H200 지연이 43.81ms이므로 이론적으로 시도 48.62개를 동시에 돌릴 수 있고, 그러면 성공당 실효 시간은 2.16초입니다.
정리하면 시도 하나만 돌리는 경우 H200을 GPU 시간당 0.087가 들어, 가장 비용 효율적인 순수 Astra보다 시간은 8.57배, 비용은 155배 효율적입니다. 여러 환경을 병렬로 돌리면 성공당 2.16초와 $0.0018로 시간 효율은 약 400배, 비용 효율은 7843배가 됩니다. 다만 순수 Astra와 혼합 변형은 특히 복잡한 과제에서 성공률을 크게 올립니다. "Pumpkins in clutter"처럼 순수 행동 정책은 아직 혼자 풀지 못하는 과제가 있습니다.
혼합 정책의 효율
π0.5는 효율을 조금만 개선했습니다. medium 노력에서 비용이 8.77·8분 08초로 각각 2배, 1.54배 개선하면서 90%의 높은 성공률로 모든 난이도의 과제를 풀었습니다.
| 구성 | 성공률 | 성공당 비용 ($) | 성공당 시간 | 성공당 토큰 |
|---|---|---|---|---|
| F3 + Astra (xhigh) | 94% 47/50 | 11.00 | 11m 53s | 7.83M |
| Pi0.5 + Astra (xhigh) | 92% 46/50 | 14.41 | 17m 09s | 10.12M |
| F3 + Astra (medium) | 84% 42/50 | 10.41 | 10m 05s | 7.69M |
| Pi0.5 + Astra (medium) | 86% 43/50 | 12.28 | 14m 26s | 8.86M |
| F3 + Astra (low) | 90% 45/50 | 8.77 | 8m 08s | 6.60M |
| Pi0.5 + Astra (low) | 86% 43/50 | 15.57 | 13m 33s | 12.38M |
| Pure Astra (xhigh) | 100% 50/50 | 13.47 | 16m 23s | 10.00M |
| Pure Astra (medium) | 94% 47/50 | 15.50 | 14m 48s | 12.11M |
| Pure Astra (low) | 84% 42/50 | 17.77 | 14m 21s | 14.13M |
표 7 — 정책과 Astra 추론 수준 조합별 혼합 정책 효율.
순수 행동 정책이 어려워하는 과제 중 하나는 "블록을 아래에서 위로 빨강·파랑·초록·노랑 순서로 쌓아"입니다.
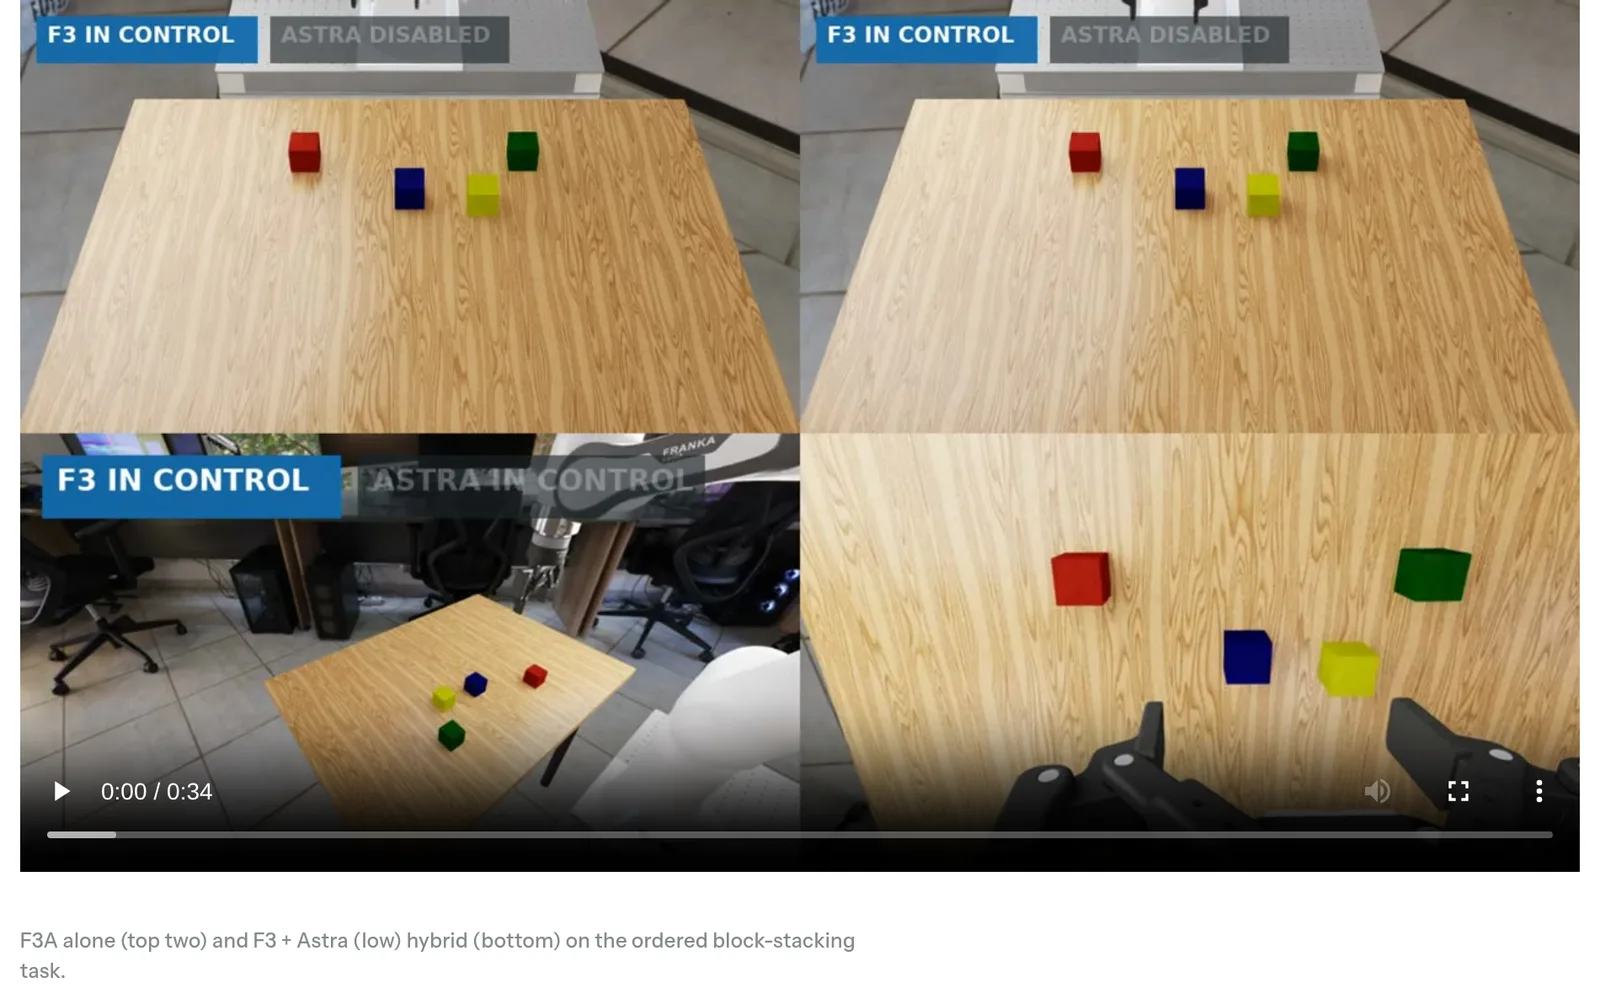
순서가 정해진 블록 쌓기 과제. 위 두 장면은 Astra 없이 F3A만 돈 결과이고, 아래는 F3+Astra(low) 혼합 정책으로 화면 표시가 그 순간 제어를 맡은 쪽을 나타냅니다.
F3A는 블록을 쌓는 시각-운동 기술은 갖췄지만 요청한 순서를 무시하는 것처럼 보입니다. 혼합 정책에서는 빨강과 파랑이 이미 쌓인 뒤 F3A가 노란 블록을 집으려 할 때 Astra가 잠깐 끼어듭니다. 말단장치를 초록 블록 쪽으로 옮기는 짧은 교정만으로 F3A가 다시 혼자 과제를 이어 갔습니다.
과제별 성공률(원문 표 8)에서 순수 정책 열을 보면 F3A 단독은 200번 중 96번(48%), π0.5·Cosmos 3는 50번 중 18번(36%), DreamZero는 50번 중 17번(34%)입니다. "Pumpkins in clutter"와 "Stack blocks in order"는 순수 정책 네 개 모두 0이지만, 혼합·순수 추론 구성은 5번 중 2~5번 성공합니다.
11. 전망
행동 예측은 에이전트가 세상과 직접 상호작용하는 길입니다. 이 능력이 물리 세계의 생산성으로 이어지려면, 행동 정책이 적은 시연으로 새 과제를 배우고 그 과제를 실시간으로 안정적으로 풀 수 있을 만큼 배포가 쉽고 효율적이어야 합니다.
산업 자동화만 봐도 실제 로봇으로 대규모 평가가 가능한 과제, 곧 통제된 환경의 조작 과제는 시각 지능의 작은 조각입니다. 낯선 지형을 지나 목표로 가는 것, 배경과 거의 구분되지 않는 것을 골라내는 것, 다른 에이전트의 행동을 예상하고 맞추는 것, 부분 정보 아래에서 전략을 세우고 앞을 계획하는 것 같은 능력은 현실에서 안전하게 대규모로 평가할 수 없습니다. 게임은 수백만 시간을 들여 바로 이런 능력들을 시험하도록 설계됐고, 물리 로봇과 달리 병렬로, 실시간보다 빠르게, 위험 없이 돌릴 수 있습니다. 저자들은 게임을 행동 예측과 추론 결합 연구의 이상적인 시험대로 보고, 게임을 하는 에이전트는 다른 소프트웨어를 조작하는 에이전트와 한 걸음 거리라고 적습니다.
12. 정리 — 계보에서의 위치
- 뼈대 — 토큰의 95% 이상이 영상인 멀티모달 생성 모델 FLUX 3를 그대로 가져와 7B WAM을 만들었습니다. 사전학습 없이 DROID만으로는 1% 미만이던 성공률이 사전학습으로 11.6%가 됩니다.
- 중간학습 — 게임·1인칭 손·휴대형 그리퍼·원격조작(14종 몸체) 데이터를 EE50·게임·관절 행동 공간으로 묶어 학습했습니다.
- 학습 세부 — 영상과 행동의 잡음-신호 전이를 따로 재서 로짓 로지스틱 시간 단계 분포(이동 42, 척도 0.75)와 행동 척도 2를 골랐고, 영상 CFG 4·행동 CFG 1, 온라인 Power EMA σrel 0.10을 썼습니다.
- 증류 — 영상과 행동을 떼지 않은 채 안내 증류(1.8~2배, 성능 +0.6~1.08pp)와 단계 증류(3.15~4배, −3.51~−4.32pp)를 적용했습니다.
- 결과 — RoboLab-120 42.2% ± 0.36(안내 증류), Franka 제3자 블라인드 평가 28/30, 추론 모델과의 혼합에서 성공당 비용 $8.77·8분 08초.
앞선 모델과의 비교
| 항목 | π0.5 (VLA) | Cosmos 3 Nano (WAM) | DreamZero (WAM) | FLUX 3 Action (WAM) |
|---|---|---|---|---|
| 파라미터 | 3.3B | 16B | 14B | 7B |
| 미래 영상 예측 | 없음 | 있음 | 있음 | 있음 |
| RoboLab-120 | 28.0% | 36.8% | 25.7% | 42.2% (안내 증류) |
| Franka 실물 10과제 | 13/30 | 27/30 | 20/30 | 28/30 |
| 묶음 길이 | 1.00 s | 2.13 s | — | 2.13 s |
파라미터와 RoboLab 값은 표 1, 실물 값은 표 6, 묶음 길이는 표 3을 기준으로 적었습니다. DreamZero의 묶음 길이는 이 보고서에 나오지 않습니다.
F3A는 영상 생성 모델의 뼈대를 로봇 정책으로 가져온 WAM 흐름에서, "영상까지 예측하면 느리다"는 WAM의 약점을 영상과 행동을 분리하지 않는 증류로 줄였습니다. 동시에 빠른 정책이 느린 추론 모델의 비용을 떠받치는 혼합 구조에서 정책의 질이 전체 효율을 좌우한다는 것을 수치로 보였습니다.
전체 목록은 WAM 계보 목차에서 볼 수 있습니다.